
利用多进程获取猫眼电影top100
猫眼电影top100 是数据是在加载网页时直接就已经加载了的,所以可以通过requests.get()方法去获取这个url的数据,能过对得到的数据进行分析从而获得top100的数据,
把获取的数据存入本地文件中.
代码如下:
import  requests

import re

import json

from multiprocessing import Pool

#引用异常处理机制,这个类是所有异常类的超类,所以能全捕捉

from  requests.exceptions import RequestException

def get_one_page(url):

    try:

        response=requests.get(url)

        if response.status_code==200:

            return response.text

        return  None

    except RequestException :

        return  None

def parse_one_page(html):

    pattern=re.compile('<dd>.*?board-index.*?(\d+)</i>.*?data-src="(.*?)".*?name"><a.*?>(.*?)</a>.*?star">(.*?)</p>.*?releasetime">(.*?)</p>.*?integer">(.*?)</i>.*?fraction">(.*?)</i>',re.S)

    items=re.findall(pattern,html)

    for item in items:

        yield  {

            "index":item[0],

            "iamge":item[1],

            "title":item[2],

            "actor":item[3].strip()[3:],

            "time":item[4].strip()[5:],

            "score":item[5]+item[6]

        }

def write_to_file(content):

    with open("result.txt","a",encoding="utf8") as f:

        f.write(json.dumps(content,ensure_ascii=False)+"\n")

        # f.close() 可以不关

def main(offset):

    url="http://maoyan.com/board/4?offset="+str(offset)

    html=get_one_page(url)

    # print(html)

    # parse_one_page(html)

    for item in parse_one_page(html):

        print(item)

        write_to_file(item)

    # print(html)

if __name__=="__main__":

    # for i in range(10):

    #     main(i*10)

    # 使用多进程

    pool=Pool()

    pool.map(main,[i*10 for i in range(10)])
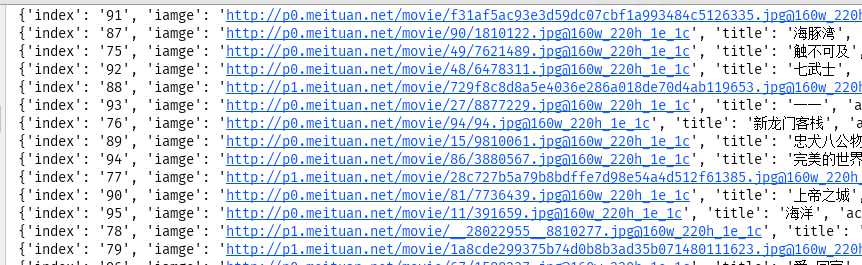
猫眼电影top100每个页面显示10部电影,用offset 来构造网页,
结果如下:
github https://github.com/573320328/tools.git
利用多进程获取猫眼电影top100的更多相关文章
- requests + 正则表达式 获取 ‘猫眼电影top100’。
使用 进程池Pool 提高爬取数据的速度. 1 # !/usr/bin/python 2 # -*- coding:utf-8 -*- 3 import requests 4 from request ...
- PYTHON 爬虫笔记八:利用Requests+正则表达式爬取猫眼电影top100(实战项目一)
利用Requests+正则表达式爬取猫眼电影top100 目标站点分析 流程框架 爬虫实战 使用requests库获取top100首页: import requests def get_one_pag ...
- Python爬虫项目--爬取猫眼电影Top100榜
本次抓取猫眼电影Top100榜所用到的知识点: 1. python requests库 2. 正则表达式 3. csv模块 4. 多进程 正文 目标站点分析 通过对目标站点的分析, 来确定网页结构, ...
- requests+正则表达式提取猫眼电影top100
#requests+正则表达式提取猫眼电影top100 import requests import re import json from requests.exceptions import Re ...
- 【爬虫综合作业】猫眼电影TOP100分析
作业的要求来自于:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3075 一.爬虫对象 猫眼电影TOP100排行榜 二.代码如下 im ...
- Python爬虫之requests+正则表达式抓取猫眼电影top100以及瓜子二手网二手车信息(四)
requests+正则表达式抓取猫眼电影top100 一.首先我们先分析下网页结构 可以看到第一页的URL和第二页的URL的区别在于offset的值,第一页为0,第二页为10,以此类推. 二.< ...
- 50 行代码教你爬取猫眼电影 TOP100 榜所有信息
对于Python初学者来说,爬虫技能是应该是最好入门,也是最能够有让自己有成就感的,今天,恋习Python的手把手系列,手把手教你入门Python爬虫,爬取猫眼电影TOP100榜信息,将涉及到基础爬虫 ...
- 40行代码爬取猫眼电影TOP100榜所有信息
主要内容: 一.基础爬虫框架的三大模块 二.完整代码解析及效果展示 1️⃣ 基础爬虫框架的三大模块 1.HTML下载器:利用requests模块下载HTML网页. 2.HTML解析器:利用re正则表 ...
- python 爬取猫眼电影top100数据
最近有爬虫相关的需求,所以上B站找了个视频(链接在文末)看了一下,做了一个小程序出来,大体上没有修改,只是在最后的存储上,由txt换成了excel. 简要需求:爬虫爬取 猫眼电影TOP100榜单 数据 ...
随机推荐
- VS工程中添加c/c++工程中外部头文件及库的基本步骤
转载自 在VS工程中,添加c/c++工程中外部头文件及库的基本步骤: 1.添加工程的头文件目录:工程---属性---配置属性---c/c++---常规---附加包含目录:加上头文件存放目录. 2.添加 ...
- bootstrap-paginator分页插件的两种使用方式
分页有两种方式: 1. 前台分页:ajax一次请求获取全部数据,适合少量数据(万条数据以下): $.ajax({ type: "GET", url: "",// ...
- Codeforces Round #415 (Div. 2)(A,暴力,B,贪心,排序)
A. Straight «A» time limit per test:1 second memory limit per test:256 megabytes input:standard inpu ...
- [国嵌攻略][155][I2C用户态驱动设计]
用户态驱动模型 用户态驱动模型首先是一个应用程序,其次是在这个用户程序中通过内核调用来驱动设备. IIC通用驱动代码 IIC通用驱动程序的代码在/drivers/i2c/i2c-dev.c中.一次读操 ...
- CXF之"@XmlType.name 和 @XmlType.namespace 为类分配不同的名称"错误
CXF 的 wsdl2java.bat 生产的代码,拷贝到目录,进行调研 web service接口时,抛出错误: Exception in thread "main" javax ...
- RSA关于加密长度限制的解决办法
RSA关于加密长度限制的解决办法 因为rsa采用分块进行加密的,所以有长度限制.如果加密信息较多,可分段加解密(不建议对大量信息rsa加密,效率低效): 正常加密情形如下: public ...
- UE4 AsnycTask
使用AsnycTask可以将制定代码放在指定线程中执行,例如更新文理必须放在游戏线程. AsyncTask(ENamedThreads::GameThread, [=](){ updateT ...
- Handler processing failed; nested exception is java.lang.NoClassDefFoundError: javax/servlet/jsp/jstl/core/Config解决
出现这个问题往往伴随 HTTP-500错误 报错信息: HTTP Status - Handler processing failed; nested exception is java.lang. ...
- TP5使用phpmailer实现邮件发送
1.从github下载PHPMailer,在vendor目录中新建文件夹phpmailer,将压缩包中的class.phpmailer.php和class.smtp.php复制到phpmailer中, ...
- Web前端性能优化——如何提高页面加载速度
前言: 在同样的网络环境下,两个同样能满足你的需求的网站,一个"Duang"的一下就加载出来了,一个纠结了半天才出来,你会选择哪个?研究表明:用户最满意的打开网页时间是2-5秒, ...