
【爬虫综合作业】猫眼电影TOP100分析
作业的要求来自于:https://edu.cnblogs.com/campus/gzcc/GZCC-16SE2/homework/3075
一.爬虫对象
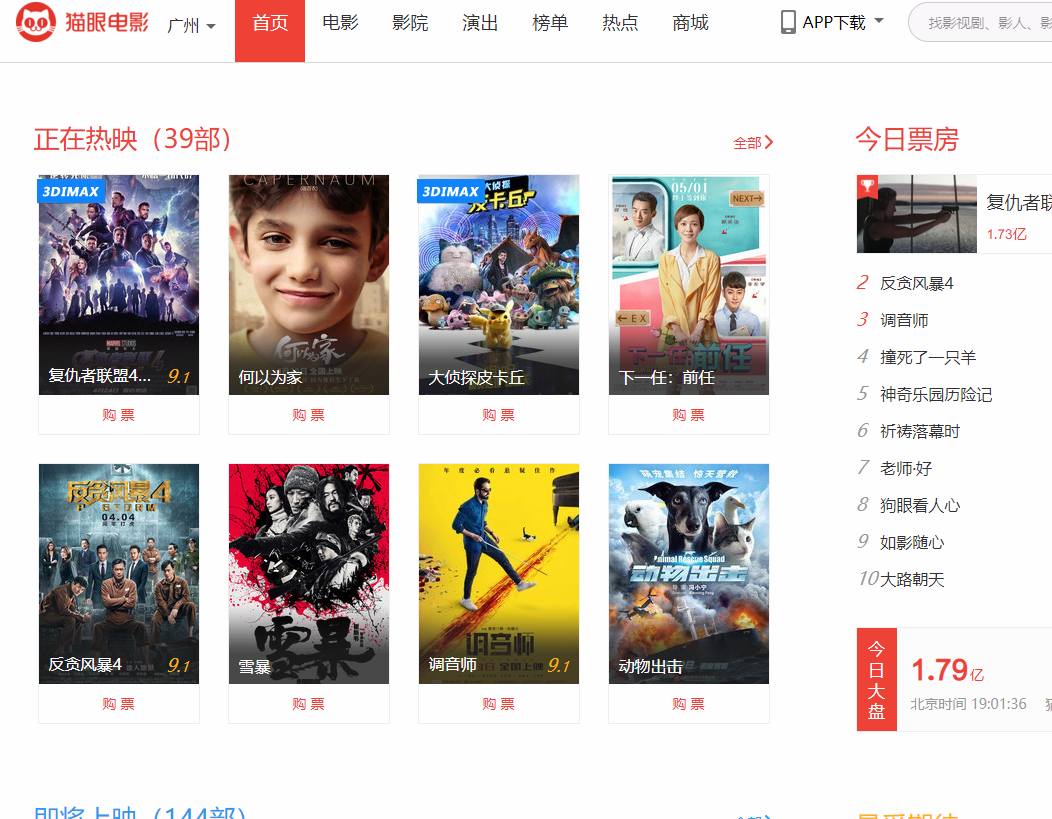
猫眼电影TOP100排行榜
二.代码如下
import requests

import re,json

from lxml import etree

import csv

class Spider():

    def open_csv(self):

        '''

        在CSV文件的开头写一行标题

        :return:

        '''

        with open('data.csv', 'a', newline='', encoding='utf-8') as f:

            spamwriter = csv.writer(f)

            spamwriter.writerow(['名称', '主演', '上映时间', '评分'])

    def __get_page(self,url,headers):

        '''

        获取文本内容

        :param url:

        :param headers:

        :return:

        '''

        try:

            response = requests.get(url, headers=headers)

            if response.status_code == 200:

                return response.text

            else:

                return None

        except Exception:

            return None

    def __parse_page(self,html):

        '''

        解析HTML,并得到提取的数据

        :param html:

        :return:

        '''

        data = etree.HTML(html)

        results = data.xpath('//*[@class="board-wrapper"]/dd/div/div')

        for result in results:

            # 电影名称 电影主演 电影上映日期 评分

            ws = [

            result.xpath('./div[1]/p[1]/a/text()')[0],

            result.xpath('./div[1]/p[2]/text()')[0].strip(),

            result.xpath('./div[1]/p[3]/text()')[0],

            result.xpath('./div[2]/p/i[1]/text()')[0] + result.xpath('./div[2]/p/i[2]/text()')[0],

            ]

            #保存到CSV

            with open('data.csv', 'a', newline='', encoding='utf-8') as f:

                writer = csv.writer(f)

                writer.writerow(ws)

    def run(self):

        '''

        程序运行入口

        :return:

        '''

        self.open_csv()

        for i in range(11):

            url ='http://maoyan.com/board/4?offset={}'.format(10*i)

            headers = {'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64)'

                                     ' AppleWebKit/537.36 (KHTML, like Gecko) Chrome/67.0.3396.99 Safari/537.36'

                       }

            html = self.__get_page(url,headers)

            self.__parse_page(html)

#实例化类

spider = Spider()

spider.run()
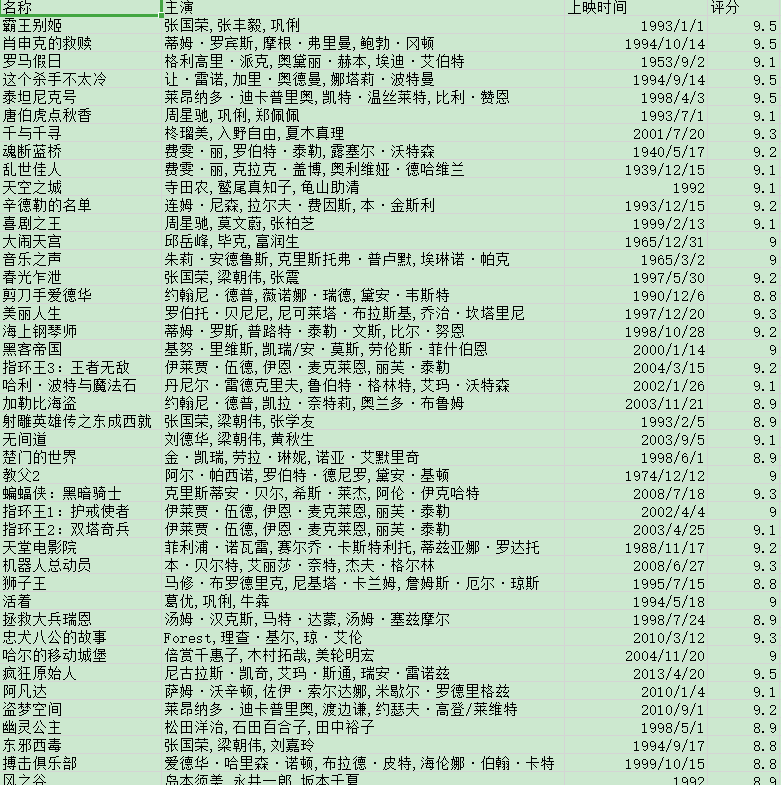
三.运行结果

四.数据分析
(1)电影评分比例
一部电影质量由评分能直接体现出来,而总体评分分布能体现出播放器的质量。
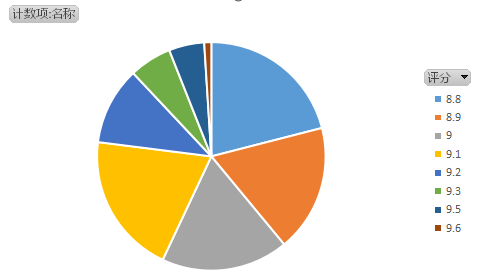
由上图看出8.8-9.1分数的电影比较多,所以猫眼电影的质量还是可以的。
(2)电影的成功除了质量之外,发布的时间也是很重要的。
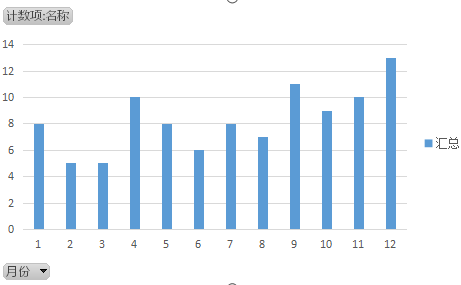
大家看电影都知道,电影基本在假期上映更有热度,这里统计出来,发现下半年的电影比上半年电影好很多。
(3)通过数据透视表可以看出,在猫眼电影TOP100排行榜中,有一部由周星驰主演的《大话西游之月光宝盒》评分远远超过其他的电影,看来星爷的经典难以被超越

【爬虫综合作业】猫眼电影TOP100分析的更多相关文章
- python3爬虫爬取猫眼电影TOP100(含详细爬取思路)
待爬取的网页地址为https://maoyan.com/board/4,本次以requests.BeautifulSoup css selector为路线进行爬取,最终目的是把影片排名.图片.名称.演 ...
- <scrapy爬虫>爬取猫眼电影top100详细信息
1.创建scrapy项目 dos窗口输入: scrapy startproject maoyan cd maoyan 2.编写item.py文件(相当于编写模板,需要爬取的数据在这里定义) # -*- ...
- python 爬取猫眼电影top100数据
最近有爬虫相关的需求,所以上B站找了个视频(链接在文末)看了一下,做了一个小程序出来,大体上没有修改,只是在最后的存储上,由txt换成了excel. 简要需求:爬虫爬取 猫眼电影TOP100榜单 数据 ...
- PYTHON 爬虫笔记八:利用Requests+正则表达式爬取猫眼电影top100(实战项目一)
利用Requests+正则表达式爬取猫眼电影top100 目标站点分析 流程框架 爬虫实战 使用requests库获取top100首页: import requests def get_one_pag ...
- 爬虫系列(1)-----python爬取猫眼电影top100榜
对于Python初学者来说,爬虫技能是应该是最好入门,也是最能够有让自己有成就感的,今天在整理代码时,整理了一下之前自己学习爬虫的一些代码,今天先上一个简单的例子,手把手教你入门Python爬虫,爬取 ...
- # [爬虫Demo] pyquery+csv爬取猫眼电影top100
目录 [爬虫Demo] pyquery+csv爬取猫眼电影top100 站点分析 代码君 [爬虫Demo] pyquery+csv爬取猫眼电影top100 站点分析 https://maoyan.co ...
- Python爬虫之requests+正则表达式抓取猫眼电影top100以及瓜子二手网二手车信息(四)
requests+正则表达式抓取猫眼电影top100 一.首先我们先分析下网页结构 可以看到第一页的URL和第二页的URL的区别在于offset的值,第一页为0,第二页为10,以此类推. 二.< ...
- Python爬虫项目--爬取猫眼电影Top100榜
本次抓取猫眼电影Top100榜所用到的知识点: 1. python requests库 2. 正则表达式 3. csv模块 4. 多进程 正文 目标站点分析 通过对目标站点的分析, 来确定网页结构, ...
- 爬虫练习之正则表达式爬取猫眼电影Top100
#猫眼电影Top100import requests,re,timedef get_one_page(url): headers={ 'User-Agent':'Mozilla/5.0 (Window ...
随机推荐
- Beta冲刺四
1.团队TSP 团队任务 预估时间 实际时间 完成日期 对数据库的最终完善 120 150 12.2 对学生注册功能的完善--新增触发器 150 140 11.29 对教师注册功能的完善 150 13 ...
- 初读"Thinking in Java"读书笔记之第四章 ---控制执行流程
true和false Java不允许将数字作为布尔值使用. 所有条件表达式都将布尔值作为判断条件,决定执行路径. if-lese 迭代 while,do-while,for为三个迭代语句. ,逗号操作 ...
- python常见函数以及模块调用
1.常用函数区别 print: 在python3.0中print是函数,这意味着需要编写print(A )而不是print A str()和repr()的区别 >>>print st ...
- day 23 对象的名称空间 类,对象属性和方法 封装 接口提供
一.对象的特有名称空间 # 对象独有的名称空间:在产生对象时就赋初值 '''class ted: def func(): 当func里不存在参数时,调用时不需要给值 print('hah')ted.f ...
- Redis安装以及Java客户端jedis连接不上相关问题解决
安装步骤 1.由于Redis是由C 语言编写的 所以虚拟机编译需要C的编译环境 用命令 yum install gcc-c++ 2.用SFTP上传Redis安装包并解压 3.进入Redis源码目录 b ...
- 2017年5月12日15:10:46 rabbitmq不支持非阻塞调用服务器
就像昨天碰到的问题描述一样,问题不是出在消费者上而是在生产者发送消息出现没有得到返回值时消息通道被挂起,rabbitmq发送的消息是阻塞调用即当发生阻塞时,继续发送的消息都堆在后面.在网上看到有两个方 ...
- JAVA8之数据流Stream
在JAVA8之前的传统编程方式,如果我们需要操作一个集合数据,需要使用集合提供的API,通过一个循环去获取集合的元素,这种访问数据的方式会使代码显得臃肿,JAVA8新引入的Stream类,用于重新封装 ...
- vue中使用ajax
var vue = new Vue({ el:"#vueid", data:{ selectById : "", }, methods:{ yourMethod ...
- 使用VS调试DUMP文件
使用前准备: 1.保存编译文件的PDB文件(要和生成exe文件的对应) 2.在开发机器上,使用vs直接双击打开dmp文件,注意 进程名称 ,这个是程序运行crash的时候所在的目录位置,这个很重要. ...
- WCF分布式3-InstanceContext和ConcurrencyMode
WCF中,如果将实现契约(接口)的服务配置默认为 InstanceContextMode = InstanceContextMode.Single, 也就是说这个服务对象,客户端调用这个对象的接口时, ...