
K-means聚类的Python实现
生物信息学原理作业第五弹:K-means聚类的实现。
转载请保留出处!
原理参考:K-means聚类(上)
数据是老师给的,二维,2 * 3800的数据。plot一下可以看到有7类。
怎么确定分类个数我正在学习,这个脚本就直接给了初始分类了,等我学会了再发。
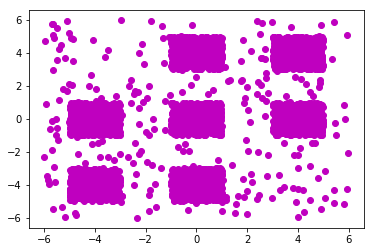
下面贴上Python代码,版本为Python3.6。
 # -*- coding: utf-8 -*-

 """

 Created on Wed Dec  6 16:01:17 2017

 @author: zxzhu

 """

 import numpy as np

 import matplotlib.pyplot as plt

 from numpy import random

 def Distance(x):

     def Dis(y):

         return np.sqrt(sum((x-y)**2))                      #欧式距离

     return Dis

 def init_k_means(k):

     k_means = {}

     for i in range(k):

         k_means[i] = []

     return k_means

 def cal_seed(k_mean):                                      #重新计算种子点

     k_mean = np.array(k_mean)

     new_seed = np.mean(k_mean,axis=0)                      #各维度均值

     return new_seed

 def K_means(data,seed_k,k_means):

     for i in data:

         f = Distance(i)

         dis = list(map(f,seed_k))                        #某一点距所有种子点的距离

         index = dis.index(min(dis))

         k_means[index].append(i)

     new_seed = []                                           #存储新种子

     for i in range(len(seed_k)):

         new_seed.append(cal_seed(k_means[i]))

     new_seed = np.array(new_seed)

     return k_means,new_seed

 def run_K_means(data,k):

     seed_k = data[random.randint(len(data),size=k)]       #随机产生种子点

     k_means = init_k_means(k)                                #初始化每一类

     result = K_means(data,seed_k,k_means)

     count = 0

     while not (result[1] == seed_k).all():                     #种子点改变,继续聚类

         count+=1

         seed_k = result[1]

         k_means = init_k_means(k=7)

         result = K_means(data,seed_k,k_means)

     print('Done')

     #print(result[1])

     print(count)

     plt.figure(figsize=(8,8))

     Color = 'rbgyckm'

     for i in range(k):

         mydata = np.array(result[0][i])

         plt.scatter(mydata[:,0],mydata[:,1],color = Color[i])

     return result[0]

 data = np.loadtxt('K-means_data')

 run_K_means(data,k=7)
附上结果图:
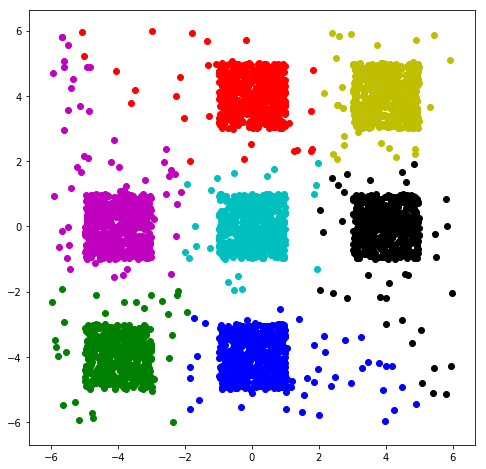
这个算法太依赖于初始种子点的选取了,随机选点很有可能会得到局部最优的结果,所以下一步学习一下怎么设置初始种子点以及分类数目。
K-means聚类的Python实现的更多相关文章
- Python实现kMeans(k均值聚类)
Python实现kMeans(k均值聚类) 运行环境 Pyhton3 numpy(科学计算包) matplotlib(画图所需,不画图可不必) 计算过程 st=>start: 开始 e=> ...
- 机器学习算法与Python实践之(五)k均值聚类(k-means)
机器学习算法与Python实践这个系列主要是参考<机器学习实战>这本书.因为自己想学习Python,然后也想对一些机器学习算法加深下了解,所以就想通过Python来实现几个比较常用的机器学 ...
- 机器学习算法与Python实践之(六)二分k均值聚类
http://blog.csdn.net/zouxy09/article/details/17590137 机器学习算法与Python实践之(六)二分k均值聚类 zouxy09@qq.com http ...
- 机器学习之路:python k均值聚类 KMeans 手写数字
python3 学习使用api 使用了网上的数据集,我把他下载到了本地 可以到我的git中下载数据集: https://github.com/linyi0604/MachineLearning 代码: ...
- 100天搞定机器学习|day44 k均值聚类数学推导与python实现
[如何正确使用「K均值聚类」? 1.k均值聚类模型 给定样本,每个样本都是m为特征向量,模型目标是将n个样本分到k个不停的类或簇中,每个样本到其所属类的中心的距离最小,每个样本只能属于一个类.用C表示 ...
- K-means聚类 的 Python 实现
K-means聚类 的 Python 实现 K-means聚类是一个聚类算法用来将 n 个点分成 k 个集群. 算法有3步: 1.初始化– K 个初始质心会被随机生成 2.分配 – K 集群通过关联到 ...
- (转) K-Means聚类的Python实践
本文转自: http://python.jobbole.com/87343/ K-Means聚类的Python实践 2017/02/11 · 实践项目 · K-means, 机器学习 分享到:1 原文 ...
- ML: 聚类算法-K均值聚类
基于划分方法聚类算法R包: K-均值聚类(K-means) stats::kmeans().fpc::kmeansruns() K-中心点聚类(K-Medoids) ...
- Kmeans 聚类 及其python实现
主要参考 K-means 聚类算法及 python 代码实现 还有 <机器学习实战> 这本书,当然前面那个链接的也是参考这本书,懂原理,会用就行了. 1.概述 K-means ...
随机推荐
- APP测试时常用adb命令
ADB全称Android Debug Bridge, 是android sdk里的一个工具, 用这个工具可以直接操作管理android模拟器或者真实的andriod设备(手机),故在其实工作可以给我们 ...
- Oracle_insert_delete_update
Oracle_insert_delete_update --复制表格的结构 create table temp as (select * from emp where 1=2); select * f ...
- Switch 语句
如果您希望有选择地执行若干代码块之一,请使用 Switch 语句. 使用 Switch 语句可以避免冗长的 if..elseif..else 代码块. 语法 工作原理: 对表达式(通常是变量)进行一次 ...
- 解决DEDECMS Call to undefined function dede_htmlspecialchars()
作者:DEDECMS建站网 关注: 3610 时间:2015-11-18 16:39 内容详情 以下内容您可能感兴趣: 织梦官方在2015年6月18日更新了织梦5.7,为了兼容php5.4+,修改了/ ...
- No input file specified的解决方法apache伪静态
http://jingyan.baidu.com/article/dca1fa6f8d623ff1a44052e8.html (一)IIS Noinput file specified 方法一:改PH ...
- [SinGuLaRiTy] NOIP互测模拟赛
[SinGuLaRiTy-1045] Copyright (c) SinGuLaRiTy 2017. All Rights Reserved. 源文件名 输入输出文件 时间限制 内存限制 淘气的cch ...
- 百万级别QPS轻量级PHP框架Steeze介绍
系统简介 Steeze是一个优雅.简洁而又高效的PHP开源框架,在整合了知名框架ThinkPHP和Laravel优点的同时,重写了底层架构,增强了功能实现. 支持swoole模型运行,支持容器.模 ...
- J.U.C JMM. pipeline.指令重排序,happen-before(续MESI协议)
缓存(Cache) CPU的读/写(以及取指令)单元正常情况下甚至都不能直接访问内存——这是物理结构决定的:CPU都没有管脚直接连到内存.相反,CPU和一级缓存(L1 Cache)通讯,而 ...
- maven项目生成war包
配置 你的pom.xml文件,在你的overview视窗里 配置 packaging为 war 然后添加 <plugin> <groupId>org.apache.maven. ...
- set&enum小结(database)
今天发现mysql中有set这种数据类型,工作的业务中也使用到了.网上查阅资料后,小结一下 先总结一下两者的分别 set和enum类似表单中的多选和单选,set和enum在数据库内部是用整数表示的,显 ...