
Java+Selenium爬取高德POI边界坐标
一、写在前面
关于爬取高德兴趣点边界坐标网上有几篇文章介绍实现方式,总的来说就是通过https://www.amap.com/detail/get/detail传入POI的ID值获取数据,BUT,如果实际操作过就会发现,然并卵。
二、主角出场
这里提供一个思路具体怎么应用大家自己把握。Selenium作为Web应用程序自动化测试工具,通过WebDriver实现多种浏览器(包括Chrome、Firefox、IE、Edge等)访问网页、设置代理、设置缓存、切换选项卡,而且还能通过findElement方法类似WebMagic的文档操作功能。
Selenium使用方法分三步
1、引入pom依赖:
<dependency>

    <groupId>org.seleniumhq.selenium</groupId>

    <artifactId>selenium-java</artifactId>

    <version>3.141.59</version>
</dependency>
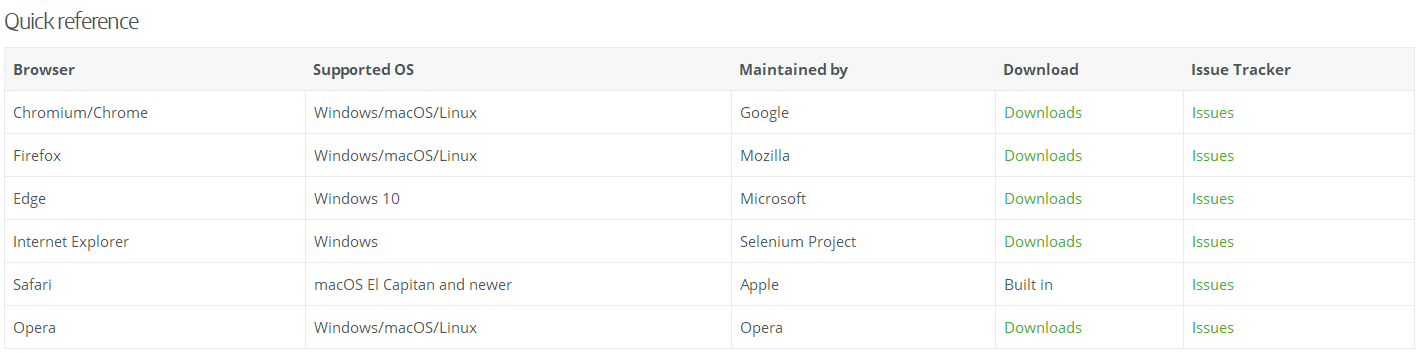
2、Web浏览器,目前支持的浏览器如图:
3、下载Web浏览器对应的WebDriver;
三、三部曲之谷歌浏览器
1)安装谷歌浏览器,最好使用安装版的,用便携版可能会出现org.openqa.selenium.WebDriverException: unknown error: cannot find Chrome binary错误,需要设置谷歌浏览器主程序路径,代码如下:
ChromeOptions options = new ChromeOptions();

options.setBinary("Chrome的启动文件路径");

WebDriver driver = new ChromeDriver(options);
2)下载谷歌浏览器对应的WebDriver浏览器驱动程序,需要下载与谷歌浏览器版本对应的驱动程序,下载地址:https://chromedriver.storage.googleapis.com/index.html
3)测试代码:
public class SeleniumChromeTest {

    public static void main(String args[]) throws Exception {

        ChromeDriver driver = null;

        try {

            //设置chrome浏览器驱动的所在位置

            // 可以设置系统环境变量省略此代码

            System.setProperty("webdriver.chrome.driver","C:\\Users\\chromedriver\\chromedriver.exe");

            ChromeOptions options = new ChromeOptions();

            // 设置IP代理

            Proxy proxy = new Proxy();

            proxy.setHttpProxy("ip:port");

            options.setProxy(proxy);

            // Chrome浏览器驱动

            driver = new ChromeDriver(options);

            // 清理所有cookie

            driver.manage().deleteAllCookies();

            // 请求POI页面

            driver.get("https://www.amap.com/place/B001B0IZY1");

            // 跳转到POI边界坐标资源请求接口

            driver.navigate().to("https://www.amap.com/detail/get/detail?id=B001B0IZY1&smToken=token&smSign=undefined");

            // 打印网页源代码

            System.out.println(driver.getPageSource());

        } catch (Exception e) {

            e.printStackTrace();

        } finally {

            driver.quit();

        }

    }

}
测试谷歌浏览器发现即使采用代理IP方式访问,每次都会弹出机器人效验,而且效验一直通过不了,可能浏览器本身发送了自动化测试程序的信息到服务端。
四、三部曲之Edge
换一个”单纯“一点的浏览器。
1)Win10系统自带Edge浏览器,不用额外安装,Win10以下的同学请跳过这段;
2)下载Edge浏览器驱动程序,下载地址https://developer.microsoft.com/en-us/microsoft-edge/tools/webdriver/,这里有一点要注意Edge内核分为Chromium和EdgeHTML,内核不一样驱动程序也是不一样的,另外根据官方描述:
Microsoft WebDriver for Microsoft Edge version 18 is a Windows Feature on Demand.

To install run the following in an elevated command prompt:

DISM.exe /Online /Add-Capability /CapabilityName:Microsoft.WebDriver~~~~0.0.1.0

For builds prior to 18, download the approriate driver for your installed version of Microsoft
EdgeHTML18的版本不用额外下载驱动程序,直接在CMD中执行如下命令方式安装驱动程序,并且程序中不用设置环境变量
DISM.exe /Online /Add-Capability /CapabilityName:Microsoft.WebDriver~~~~0.0.1.0
3)测试代码参考谷歌浏览器实现。
测试结果,Edge浏览器驱动程序设置IP代理会报错,这是因为Edge的IP代理就是Windows的代理,无法单独对Edge进行代理设置。错误信息如下:
org.openqa.selenium.InvalidArgumentException: The specified arguments passed to the command are invalid.
Edge Chromium内核的没有测试过设置IP代理,有兴趣的同学可以测试一下。
五、三部曲之IE
谷歌和Edge测试完以后发现都有缺陷,最后只能尝试IE浏览器。
1)Windows自带了IE浏览器;
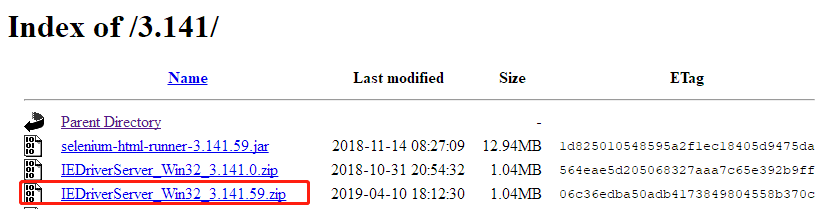
2)下载IE浏览器驱动程序,下载地址:https://selenium-release.storage.googleapis.com/index.html,版本和Selenium版本对应版本选择32为驱动程序,即使是64位操作系统也要选择32位驱动程序,否则会出现指令执行不成功(例如无法获取cookie)等问题,如图:
3)测试代码参考谷歌浏览器实现。
测试发现IE浏览器也有个问题,跳转到https://www.amap.com/detail/get/detail页面后IE不会再网页显示JSON数据,而是下提供JSON文件下载。
以上是使用Selenium爬取POI边界坐标的测试过程,如需交流可以发站内信给我。
Java+Selenium爬取高德POI边界坐标的更多相关文章
- java selenium爬取验证图片是否加载完成
爬虫任务里发现有部分图片没有加载完成就进行文件流上传,导致有一些图片是空白,需要判断一下: 首选获取image标签元素: WebElement image = driver.findElement(B ...
- C# HtmlAgilityPack+Selenium爬取需要拉动滚动条的页面内容
现在大多数网站都是随着滚动条的滑动加载页面内容的,因此单纯获得静态页面的Html是无法获得全部的页面内容的.使用Selenium就可以模拟浏览器拉动滑动条来加载所有页面内容. 前情提要 C#HtmlA ...
- selenium模块使用详解、打码平台使用、xpath使用、使用selenium爬取京东商品信息、scrapy框架介绍与安装
今日内容概要 selenium的使用 打码平台使用 xpath使用 爬取京东商品信息 scrapy 介绍和安装 内容详细 1.selenium模块的使用 # 之前咱们学requests,可以发送htt ...
- [Python爬虫] Selenium爬取新浪微博客户端用户信息、热点话题及评论 (上)
转载自:http://blog.csdn.net/eastmount/article/details/51231852 一. 文章介绍 源码下载地址:http://download.csdn.net/ ...
- selenium爬取煎蛋网
selenium爬取煎蛋网 直接上代码 from selenium import webdriver from selenium.webdriver.support.ui import WebDriv ...
- 利用selenium爬取京东商品信息存放到mongodb
利用selenium爬取京东商城的商品信息思路: 1.首先进入京东的搜索页面,分析搜索页面信息可以得到路由结构 2.根据页面信息可以看到京东在搜索页面使用了懒加载,所以为了解决这个问题,使用递归.等待 ...
- 利用Selenium爬取淘宝商品信息
一. Selenium和PhantomJS介绍 Selenium是一个用于Web应用程序测试的工具,Selenium直接运行在浏览器中,就像真正的用户在操作一样.由于这个性质,Selenium也是一 ...
- Scrapy 框架 使用 selenium 爬取动态加载内容
使用 selenium 爬取动态加载内容 开启中间件 DOWNLOADER_MIDDLEWARES = { 'wangyiPro.middlewares.WangyiproDownloaderMidd ...
- 使用selenium爬取网站动态数据
处理页面动态加载的爬取 selenium selenium是python的一个第三方库,可以实现让浏览器完成自动化的操作,比如说点击按钮拖动滚轮等 环境搭建: 安装:pip install selen ...
- scrapy框架 + selenium 爬取豆瓣电影top250......
废话不说,直接上代码..... 目录结构 items.py import scrapy class DoubanCrawlerItem(scrapy.Item): # 电影名称 movieName = ...
随机推荐
- 从源码角度了解Vue生命周期
每个Vue应用都是通过new Vue()创建一个Vue实例开始.Vue()函数可以传入选项Options,常见的有el.template和data选项等. el 只在new创建实例时生效,其值可以是一 ...
- 文心一言 VS 讯飞星火 VS chatgpt (75)-- 算法导论7.2 4题
四.如果用go语言,银行一般会按照交易时间来记录某一账户的交易情况.但是,很多人却喜欢收到的银行对账单是按照支票号码的顺序来排列的.这是因为,人们通常都是按照支票号码的顺序来开出支票的,而商人也通常都 ...
- Jmeter+Ant+Jenkins接口自动化框架(续)
前段时间给公司内部项目搭建了一套接口自动化框架,基于实际使用,需要配置自动发送邮件功能,将 执行结果发送给相关负责人.Jenkins本身也提供了一个邮件通知功能,但在提供详细的邮件内容.自定义邮 件格 ...
- 《Linux基础》09. Shell 编程
@ 目录 1:Shell 简介 2:Shell 脚本 2.1:规则与语法 2.2:执行方式 2.3:第一个 Shell 脚本 3:变量 3.1:系统变量 3.2:用户自定义变量 3.2.1:规则 3. ...
- Programming abstractions in C阅读笔记:p139-p143
<Programming Abstractions In C>学习第55天,p139-p140,总结如下: 一.技术总结 1.文件I/O操作 文件I/O操作可以分为一下这些步骤: (1)声 ...
- msvc++中的预编译头文件pch.hpp和stdafx.h
预编译头文件 在 Visual Studio 中创建新项目时,会在项目中添加一个名为 pch.h 的"预编译标头文件". (在 Visual Studio 2017 及更高版本中, ...
- WPF学习 - 动画基础(1)
1. WPF中的动画(Animation),是一种属性动画.技术上来说,它是让属性从一个值,变化到另一个值的过程.因此,有两条重要的特性: 1.1 只能为依赖属性应用动画(因为第二条特性). 1.2 ...
- 弹性数据库连接池探活策略调研(三)——DBCP
前言 在之前的文章中,我们介绍了弹性数据库连接失效的背景,并探讨了HikariCP.Druid连接池探活策略的相关内容.在本文中,我们将会继续探讨另一个线上常用的连接池--DBCP,并为您介绍如何在使 ...
- 循序渐进介绍基于CommunityToolkit.Mvvm 和HandyControl的WPF应用端开发(1)
在我们的SqlSugar的开发框架中,整合了Winform端.Vue3+ElementPlus的前端.以及基于UniApp+Vue+ThorUI的移动前端几个前端处理,基本上覆盖了我们日常的应用模式了 ...
- kmp的简单应用
Smiling & Weeping ---- 我只为你一个人写过月亮 题目链接:P4824 [USACO15FEB] Censoring S - 洛谷 | 计算机科学教育新生态 (luogu. ...