
scrapy框架简介与安装启动
Scrapy 是一个专业的、高效的爬虫框架,它使用专业的 Twisted 包(基于事件驱动的网络引擎包)高效地处理网络通信,使用 lxml(专业的 XML 处理包)、cssselect 高效地提取 HTML 页面的有效信息,同时它也提供了有效的线程管理。
安装scrapy
pip3 install scrapy
在windows如果报错的话按以下方式安装(缺少环境,或者直接下载VS):

    pip3  install wheel

    下载twisted   https://www.lfd.uci.edu/~gohlke/pythonlibs/#twisted

    进入下载目录,执行  pip3 install Twisted‑17.1.0‑cp35‑cp35m‑win_amd64.whl

    pip3   install  pywin32

    pip3   install  scrapy
项目创建与启动
#scrapy项目创建
scrapy startproject  xxx(项目名)-----创建爬虫项目
    cd xxx(项目名)--------必须要进入项目文件
    scrapy genspider  xx(爬虫文件)   url(起始url,后期可修改)--------创建爬虫应用
#scrapy项目启动
scrapy crawl xx(爬虫文件)----需要进入爬虫文件所在的目录
scrapy crawl 爬虫文件 --nolog:该种执行形式不会显示执行的日志信息

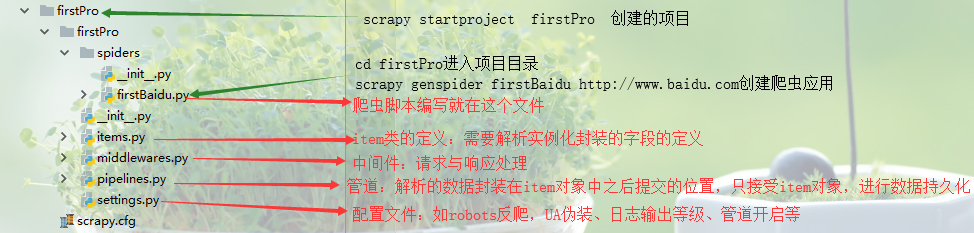
项目中创建的默认爬虫文件
 import scrapy

 class FirstbaiduSpider(scrapy.Spider):

     name = 'firstBaidu'#爬虫文件(应用)名

     # allowed_domains = ['https://www.baidu.com/']#域名限定,一般直接注释

     start_urls = ['https://www.baidu.com//']#起始url,创建应用时指定的,可修改

     def parse(self, response):#自动访问起始URL并获取结果后的回调函数,参数respons为起始请求的响应对象,可以直接调用封装好的xpath解析

         pass
默认创建的爬虫文件
scrapy框架简介与安装启动的更多相关文章
- 爬虫基础(五)-----scrapy框架简介
---------------------------------------------------摆脱穷人思维 <五> :拓展自己的视野,适当做一些眼前''无用''的事情,防止进入只关 ...
- 爬虫开发7.scrapy框架简介和基础应用
scrapy框架简介和基础应用阅读量: 1432 scrapy 今日概要 scrapy框架介绍 环境安装 基础使用 今日详情 一.什么是Scrapy? Scrapy是一个为了爬取网站数据,提取结构性数 ...
- selenium模块使用详解、打码平台使用、xpath使用、使用selenium爬取京东商品信息、scrapy框架介绍与安装
今日内容概要 selenium的使用 打码平台使用 xpath使用 爬取京东商品信息 scrapy 介绍和安装 内容详细 1.selenium模块的使用 # 之前咱们学requests,可以发送htt ...
- 爬虫(九)scrapy框架简介和基础应用
概要 scrapy框架介绍 环境安装 基础使用 一.什么是Scrapy? Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架,非常出名,非常强悍.所谓的框架就是一个已经被集成了各种功能 ...
- 10.scrapy框架简介和基础应用
今日概要 scrapy框架介绍 环境安装 基础使用 今日详情 一.什么是Scrapy? Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架,非常出名,非常强悍.所谓的框架就是一个已经被 ...
- scrapy框架简介和基础应用
scrapy框架介绍 环境安装 基础使用 一.什么是Scrapy? Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架,非常出名,非常强悍.所谓的框架就是一个已经被集成了各种功能(高性 ...
- Scrapy 框架简介
Scrapy 框架 介绍 Scrapy一个开源和协作的框架,其最初是为了页面抓取 (更确切来说, 网络抓取 )所设计的,使用它可以以快速.简单.可扩展的方式从网站中提取所需的数据.但目前Scrapy的 ...
- 爬虫 (5)- Scrapy 框架简介与入门
Scrapy 框架 Scrapy是用纯Python实现一个为了爬取网站数据.提取结构性数据而编写的应用框架,用途非常广泛. 框架的力量,用户只需要定制开发几个模块就可以轻松的实现一个爬虫,用来抓取网页 ...
- scrapy框架介绍及安装
什么是scrapy框架? scrapy框架的安装 1.windowes下的安装 Python 2 / 3升级pip版本: pip install --upgrade pip 通过pip 安装 Scra ...
随机推荐
- 深入理解Java枚举
深入理解Java枚举 重新认识Java枚举 老实说,挺羞愧的,这么久了,一直不知道Java枚举的本质是啥,虽然也在用,但是真不知道它的底层是个啥样的 直到2020年4月28日的晚上20点左右,我才真的 ...
- Python与Excel交互——Xlwings实战
这一期直接来实战. 比如说,我们在一个快递网站上爬取了几个快递的轨迹信息,我们需要将数据保存下来,一个常规做法是把数据保存在数据库里(Mysql,MongoDB,Redis),另一个是用Excel的形 ...
- MySql id 设定为主键不自增后,再给 sort 字段增加自增属性
需求 id 已经被设置为主键,但是没有给它设置 自增 属性.sort 起到一个排序的作用,需要给它设置一个 自增 属性 加自增属性的前提 表中的属性没有增加自增 赋予自增属性的字段,必须带有 索引 S ...
- java制作一个简单的抽签程序
首先需要导入import java.util.Random;才能使用随机类Random:Random生成随机数介绍:https://www.cnblogs.com/prodigal-son/p/128 ...
- MyBatis学习总结(9)——使用MyBatis Generator自动创建代码
2019独角兽企业重金招聘Python工程师标准>>> 由于MyBatis属于一种半自动的ORM框架,所以主要的工作就是配置Mapping映射文件,但是由于手写映射文件很容易出错,所 ...
- Vs Code在Vue项目中v-for指令提示错误的解决办法
最近在做一个Vue项目,在其中用到v-for指令时,发现Vs Code报错,如下图(代码是没有任何问题的),在网上找了一下解决办法,希望能帮助到更多人. 解决方法: 打开 文件-首选项-设置 将 ...
- POJ 2188 Cow Laundry
Cow Laundry Time Limit: 1000MS Memory Limit: 65536K Total Submissions: 1376 Accepted: 886 Descriptio ...
- 网络流--最大流--POJ 1273 Drainage Ditches
链接 Description Every time it rains on Farmer John's fields, a pond forms over Bessie's favorite clov ...
- unittest(封装用例)
from selenium import webdriver from time import sleep import unittest #导入unittest库 import HTMLTestRu ...
- 一只简单的网络爬虫(基于linux C/C++)————线程相关
爬虫里面采用了多线程的方式处理多个任务,以便支持并发的处理,把主函数那边算一个线程的话,加上一个DNS解析的线程,以及我们可以设置的max_job_num值,最多使用了1+1+max_job_num个 ...