
Python简易爬虫爬取百度贴吧图片
通过python 来实现这样一个简单的爬虫功能,把我们想要的图片爬取到本地。(Python版本为3.6.0)
一.获取整个页面数据
def getHtml(url):

    page=urllib.request.urlopen(url)

    html=page.read()

    return html
说明:
向getHtml()函数传递一个网址,就可以把整个页面下载下来.
urllib.request 模块提供了读取web页面数据的接口,我们可以像读取本地文件一样读取www和ftp上的数据.
二.筛选页面中想要的数据
在百度贴吧找到了几张漂亮的图片,想要下载下来.使用火狐浏览器,在图片位置鼠标右键单单击有查看元素选项,点进去之后就会进入开发者模式,并且定位到图片所在的前段代码
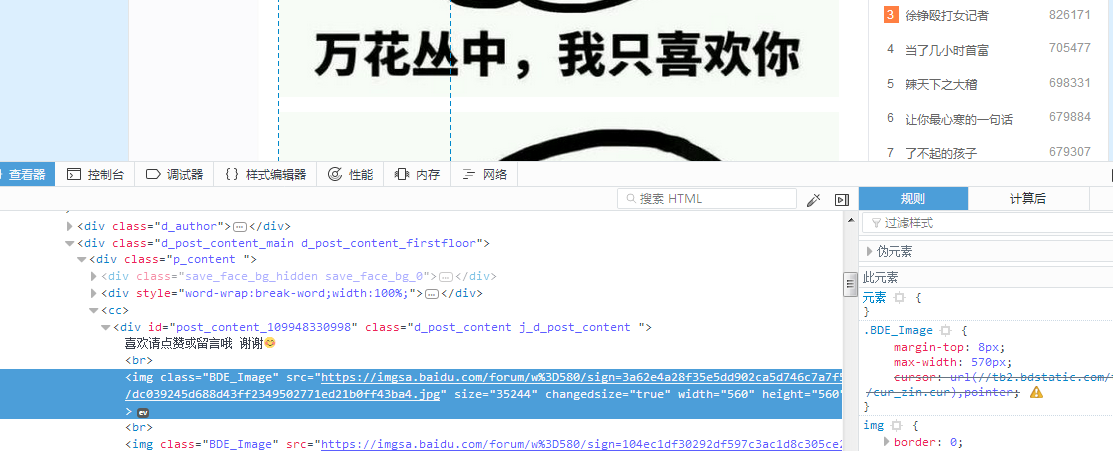
现在主要观察图片的正则特征,编写正则表达式.
reg=r'src="(https://imgsa[^>]+\.(?:jpeg|jpg))"'
#参考正则
编写代码
def getImg(html):

    reg=r'src="(https://imgsa[^>]+\.(?:jpeg|jpg))"'

    imgre = re.compile(reg)

    imglist = re.findall(imgre,html.decode('utf-8'))

    return imglist
说明:
re.compile() 可以把正则表达式编译成一个正则表达式对象.
re.findall() 方法读取html 中包含 imgre(正则表达式)的数据。
运行脚本将得到整个页面中包含图片的URL地址。
三.将页面筛选的数据保存到本地
编写一个保存的函数
def saveFile(x):

    if not os.path.isdir(path):

        os.makedirs(path)

    t = os.path.join(path,'%s.img'%x)

    return  t
完整代码:
'''

Created on 2017年7月15日

@author: Administrator

'''

import urllib.request,os

import re

def getHtml(url):

    page=urllib.request.urlopen(url)

    html=page.read()

    return html

path='D:/workspace/Python1/reptile/__pycache__/img'

def saveFile(x):

    if not os.path.isdir(path):

        os.makedirs(path)

    t = os.path.join(path,'%s.img'%x)

    return  t

html=getHtml('https://tieba.baidu.com/p/5248432620')

print(html)

print('\n')

def getImg(htnl):

    reg=r'src="(https://imgsa[^>]+\.(?:jpeg|jpg))"'

    imgre=re.compile(reg)

    imglist=re.findall(imgre,html.decode('utf-8'))

    x=

    for imgurl in imglist:

        urllib.request.urlretrieve(imgurl,saveFile(x))

        print(imgurl)

        x+=

        if x==:

            break

    print(x)

    return imglist

getImg(html)

print('end')
核心是用到了urllib.request.urlretrieve()方法,直接将远程数据下载到本地
最后,有点问题还没有完全解决,这里也向大家请教一下.
当下载图片超过23张时会报错:
urllib.error.HTTPError: HTTP Error 500: Internal Server Error
不知道是什么问题,求助.
Python简易爬虫爬取百度贴吧图片的更多相关文章
- 【Python】Python简易爬虫爬取百度贴吧图片
通过python 来实现这样一个简单的爬虫功能,把我们想要的图片爬取到本地.(Python版本为3.6.0) 一.获取整个页面数据 def getHtml(url): page=urllib.requ ...
- python简单爬虫爬取百度百科python词条网页
目标分析:目标:百度百科python词条相关词条网页 - 标题和简介 入口页:https://baike.baidu.com/item/Python/407313 URL格式: - 词条页面URL:/ ...
- Python爬虫 - 爬取百度html代码前200行
Python爬虫 - 爬取百度html代码前200行 - 改进版, 增加了对字符串的.strip()处理 源代码如下: # 改进版, 增加了 .strip()方法的使用 # coding=utf-8 ...
- python爬虫-爬取百度图片
python爬虫-爬取百度图片(转) #!/usr/bin/python# coding=utf-8# 作者 :Y0010026# 创建时间 :2018/12/16 16:16# 文件 :spider ...
- 如何利用Python网络爬虫爬取微信朋友圈动态--附代码(下)
前天给大家分享了如何利用Python网络爬虫爬取微信朋友圈数据的上篇(理论篇),今天给大家分享一下代码实现(实战篇),接着上篇往下继续深入. 一.代码实现 1.修改Scrapy项目中的items.py ...
- 利用Python网络爬虫爬取学校官网十条标题
利用Python网络爬虫爬取学校官网十条标题 案例代码: # __author : "J" # date : 2018-03-06 # 导入需要用到的库文件 import urll ...
- 百度图片爬虫-python版-如何爬取百度图片?
上一篇我写了如何爬取百度网盘的爬虫,在这里还是重温一下,把链接附上: http://www.cnblogs.com/huangxie/p/5473273.html 这一篇我想写写如何爬取百度图片的爬虫 ...
- 写一个python 爬虫爬取百度电影并存入mysql中
目标是利用python爬取百度搜索的电影 在类型 地区 年代各个标签下 电影的名字 评分 和图片连接 以及 电影连接 首先我们先在mysql中建表 create table liubo4( id in ...
- 04 Python网络爬虫 <<爬取get/post请求的页面数据>>之requests模块
一. urllib库 urllib是Python自带的一个用于爬虫的库,其主要作用就是可以通过代码模拟浏览器发送请求.其常被用到的子模块在Python3中的为urllib.request和urllib ...
随机推荐
- jQuery 提供多个与 AJAX 有关的方法。
jQuery 提供多个与 AJAX 有关的方法. 通过 jQuery AJAX 方法,您能够使用 HTTP Get 和 HTTP Post 从远程服务器上请求文本.HTML.XML 或 JSON - ...
- discuz用户登录不响应,提示nginx gateway timeout解决方法
在使用nginx+php-cgi搭建discuz论坛过程中,出现论坛登录不响应,一直提示nginx gateway timeout504网关超时,单单采用php方式登录无问题.但因需要使用nginx把 ...
- vue-resource promise兼容性问题
背景 其实这个问题在之前的项目开发中就出现过,但是当初只解决问题了,并没有针对问题作总结:于是乎今天踩到了自己埋的坑,所以决定记录一下.那么到底是什么问题呢?就是"在安卓低版本,如果你在vu ...
- Java IO学习笔记三
Java IO学习笔记三 在整个IO包中,实际上就是分为字节流和字符流,但是除了这两个流之外,还存在了一组字节流-字符流的转换类. OutputStreamWriter:是Writer的子类,将输出的 ...
- mysql中group by和order by同时使用无效的替代方案
前言 最近一年由于工作需要大部分使用的都是NoSql数据库,对关系型数据库感觉越来越陌生,一个由group by和order by 引发的血案由此而生.在此做个记录,以备不时之需. 需求 首先,看一下 ...
- crontab问题处理
用pyhton写了一些爬虫,由于数据量比较大,需要跑的时间也比较长,所以将代码部署到服务器上.选择用crontab完成爬虫的定时爬取数据,这样避免了人工的干预,减少一些人为错误.但在部署crontab ...
- watchdog(IWDG)
1.为了避免程序忙跑跑死了没反应,加上一个看门狗watchdog实时监控着程序,一旦程序没有在规定的时间喂狗,则狗叫使得单片机复位. 2.Independent watchdog(IWDG)内部有时钟 ...
- 我的学习之路_第二十一章_JDBC连接池
JDBC连接池和DButils [DBCP连接池工具类] 使用读取配置文件的方式 DBCP中有一个工厂类 BasicDataSourceFactory 工厂类中有一个静态方法 返回值为: DataSo ...
- js倒计时函数和(js禁用和恢复a标签的操作)
<script type="text/javascript"> /*获取手机号*/ var start_time=60; function get_phone_nums ...
- php后台模板html拼接写法
public function get_kefu_reply_list(){ $wid=$this->_post('order_id'); if(!$wid){ echo('工单信息获取失败!' ...