
Python——爬取百度百科关键词1000个相关网页
Python简单爬虫——爬取百度百科关键词1000个相关网页——标题和简介
网站爬虫由浅入深:慢慢来
分析:

链接的URL分析:

数据格式:
爬虫基本架构模型:
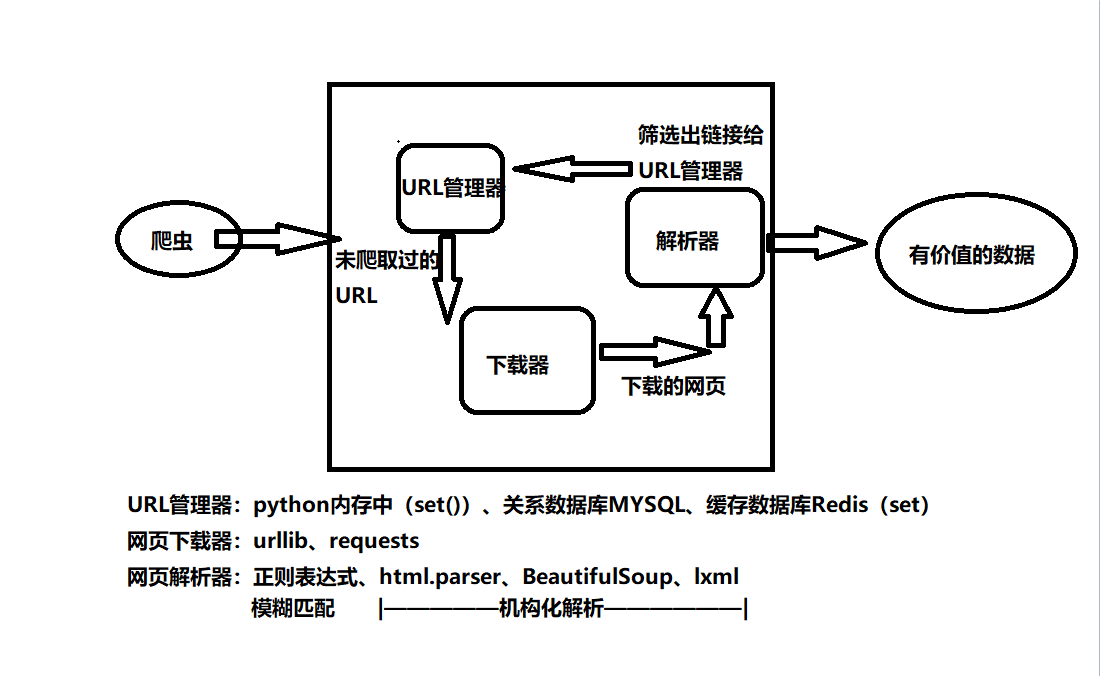
本爬虫架构:

源代码:
# coding:utf8

# author:Jery

# datetime:2019/4/12 19:22

# software:PyCharm

# function:爬取百度百科关键词python1000个相关网页——标题和简介

from urllib.request import urlopen

import re

from bs4 import BeautifulSoup

class SpiderMain(object):

    def __init__(self):

        self.urls = UrlManager()

        self.downloader = HtmlDownloader()

        self.parser = HtmlParser()

        self.outputer = DataOutputer()

    # 主爬虫,调度四个类的方法执行爬虫

    def crawl(self, root_url):

        count = 1

        self.urls.add_new_url(root_url)

        while self.urls.has_new_url():

            try:

                new_url = self.urls.get_new_url()

                print("crawl 第{} :{} ".format(count, new_url))

                html_content = self.downloader.download(new_url)

                new_urls, new_data = self.parser.parse(new_url, html_content)

                # 新网页的url及数据

                self.urls.add_new_urls(new_urls)

                self.outputer.collect_data(new_data)

                if count == 1000:

                    break

                count += 1

            except:

                print(" crawl failed! ")

        self.outputer.output_html()

# URL管理器,实现URL的增加与删除

class UrlManager:

    def __init__(self):

        self.new_urls = set()

        self.old_urls = set()

    def has_new_url(self):

        return len(self.new_urls) != 0

    def get_new_url(self):

        new_url = self.new_urls.pop()

        self.old_urls.add(new_url)

        return new_url

    def add_new_url(self, url):

        if url is None:

            return

        if url not in self.new_urls and url not in self.old_urls:

            self.new_urls.add(url)

    def add_new_urls(self, urls):

        if urls is None or len(urls) == 0:

            return

        for url in urls:

            self.new_urls.add(url)

# 下载网页源代码

class HtmlDownloader:

    def download(self, url):

        if url in None:

            return

        response = urlopen(url)

        if response.getcode() != 200:

            return

        return response.read()

# 下载网页所需内容

class HtmlParser:

    def parse(self, page_url, html_content):

        if page_url is None or html_content is None:

            return

        soup = BeautifulSoup(html_content, 'lxml', from_encoding='utf-8')

        new_urls = self._get_new_urls(page_url, soup)

        new_data = self._get_new_data(page_url, soup)

        return new_urls, new_data

    def _get_new_urls(self, page_url, soup):

        new_urls = set()

        links = soup.find_all('a', href=re.compile(r'/view/.*'))

        for link in links:

            new_url = "https://baike.baidu.com" + link['href']

            new_urls.add(new_url)

        return new_urls

    def _get_new_data(self, page_url, soup):

        res_data = {}

        # <dl class="lemmaWgt-lemmaTitle lemmaWgt-lemmaTitle-">

        # <dd class="lemmaWgt-lemmaTitle-title">

        # <h1>Python</h1>

        title_node = soup.find("dl", {"class": "lemmaWgt-lemmaTitle lemmaWgt-lemmaTitle-"}).dd.h1

        res_data['title'] = title_node.get_text()

        summary_node = soup.find('div', {"class": "lemma-summary"})

        res_data['summary'] = summary_node.get_text()

        return res_data

# 将所搜集数据输出至html的表格中

class DataOutputer:

    def __init__(self):

        self.datas = []

    def collect_data(self, data):

        if data is None:

            return

        self.datas.append(data)

    def output_html(self):

        output = open('output.html', 'w')

        output.write("<html>")

        output.write("<body>")

        output.write("<table>")

        for data in self.datas:

            output.write("<tr>")

            output.write("<td>{}</td>".format(data['url']))

            output.write("<td>{}</td>".format(data['title'].encode('utf-8')))

            output.write("<td>{}</td>".format(data['summary'].encode('utf-8')))

            output.write("</tr>")

        output.write("</table>")

        output.write("<body>")

        output.write("</html>")

        output.close()

if __name__ == '__main__':

    root_url = "https://baike.baidu.com/item/Python/407313"

    obj_spider = SpiderMain()

    obj_spider.crawl(root_url)
Python——爬取百度百科关键词1000个相关网页的更多相关文章
- 爬虫实战(一) 用Python爬取百度百科
最近博主遇到这样一个需求:当用户输入一个词语时,返回这个词语的解释 我的第一个想法是做一个数据库,把常用的词语和词语的解释放到数据库里面,当用户查询时直接读取数据库结果 但是自己又没有心思做这样一个数 ...
- Python开发简单爬虫(二)---爬取百度百科页面数据
一.开发爬虫的步骤 1.确定目标抓取策略: 打开目标页面,通过右键审查元素确定网页的url格式.数据格式.和网页编码形式. ①先看url的格式, F12观察一下链接的形式;② 再看目标文本信息的标签格 ...
- Python抓取百度百科数据
前言 本文整理自慕课网<Python开发简单爬虫>,将会记录爬取百度百科"python"词条相关页面的整个过程. 抓取策略 确定目标:确定抓取哪个网站的哪些页面的哪部分 ...
- python简单爬虫 用beautifulsoup爬取百度百科词条
目标:爬取“湖南大学”百科词条并处理数据 需要获取的数据: 源代码: <div class="basic-info cmn-clearfix"> <dl clas ...
- Python3爬取百度百科(配合PHP)
用PHP写了一个网页,可以获取百度百科词条.源代码已分享至github:https://github.com/1049451037/xiaobaike/tree/master 那么通过Python来爬 ...
- java 如何爬取百度百科词条内容(java如何使用webmagic爬取百度词条)
这是老师所布置的作业 说一下我这里的爬去并非能把百度词条上的内容一字不漏的取下来(而是它分享链接的一个主要内容概括...)(他的主要内容我爬不到 也不想去研究大家有好办法可以call me) 例如 互 ...
- python 爬取百度url
#!/usr/bin/env python # -*- coding: utf-8 -*- # @Date : 2017-08-29 18:38:23 # @Author : EnderZhou (z ...
- 用Python爬取了考研吧1000条帖子,原来他们都在讨论这些!
写在前面 考研在即,想多了解考研er的想法,就是去找学长学姐或者去网上搜索,贴吧就是一个好地方.而借助强大的工具可以快速从网络鱼龙混杂的信息中得到有价值的信息.虽然网上有很多爬取百度贴吧的教程和例子, ...
- 假期学习【十一】Python爬取百度词条写入csv格式 python 2020.2.10
今天主要完成了根据爬取的txt文档,从百度分类从信息科学类爬取百度词条信息,并写入CSV格式文件. txt格式文件如图: 为自己爬取内容分词后的结果. 代码如下: import requests fr ...
随机推荐
- Spring Boot Reference Guide
Spring Boot Reference Guide Authors Phillip Webb, Dave Syer, Josh Long, Stéphane Nicoll, Rob Winch, ...
- 白盒测试实践-任务进度-Day02
所使用静态代码检查工具 阿里巴巴Java开发代码检测IDE插件 小组成员 华同学.郭同学.覃同学.刘同学.穆同学.沈同学 任务进度 在经过任务分配阶段后,大家都投入到了各自的任务中,以下是大家今天任务 ...
- 为 pycharm 修改 Theme & Color
版本: pycharm-community-4.5.2 安装之后先导入 (File --> Import Setting --> django.jar) 将文件pycharm-themes ...
- Centos6 hadoop2.6.0安装笔记
系统环境: linux:Centos6-64bit hadoop:hadoop2.6.0 jdk:1.6.45 集群方式安装 一台master,3台slave master 192.168.111.1 ...
- Linux下MySQL表名不区分大小写的设置方法
MySQL表名不区分大小写的设置方法 在用centox安装mysql后,把项目的数据库移植了过去,发现一些表的数据查不到,排查了一下问题,最后发现是表名的大小写不一致造成的. mysql在window ...
- 【微服务架构】SpringCloud之Ribbon(四)
一:Ribbon是什么? Ribbon是Netflix发布的开源项目,主要功能是提供客户端的软件负载均衡算法,将Netflix的中间层服务连接在一起.Ribbon客户端组件提供一系列完善的配置项如连接 ...
- 文字编码ASCII,GB2312,GBK,GB18030,UNICODE,UCS,UTF的解析
众所周知,一个文字从输入到显示到存储是有一个固定过程的,其过程为:输入码(根据输入法不同而不同)→机内码(根据语言环境不同而不同,不同的系统语言编码也不一样)→字型码(根据不同的字体而不同)→存储码( ...
- SQL 语句常用函数
一.字符转换函数 1.ASCII()返回字符表达式最左端字符的ASCII 码值.在ASCII()函数中,纯数字的字符串可不用‘’括起来,但含其它字符的字符串必须用‘’括起来使用,否则会出错. 2.CH ...
- .net core session cookie操作
配置Session Cookie注意
- redis安装 卸载 启动 关闭
一 redis安装 第一步:在VMware中安装CentOS(参考Linux教程中的安装虚拟机) 第二步:在Linux下安装gcc环境 [root@hadoop ~]#yum install gcc- ...