
大数据学习——下载集群根目录下的文件到E盘
代码如下:
package cn.itcast.hdfs;

import java.io.IOException;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.FileSystem;

import org.apache.hadoop.fs.Path;

public class TestHDFS {

    public static void main(String[] args) throws IOException {

        Configuration conf = new Configuration();

        //伪造root用户身份

        System.setProperty("HADOOP_USER_NAME","root");

        //1首先需要一个hdfs的客户端对象

        conf.set("fs.defaultFS", "hdfs://mini1:9000");

        FileSystem fs = FileSystem.get(conf);

        fs.copyToLocalFile( new Path("/hello.txt"),new Path("E://"));

        fs.close();

    }

}
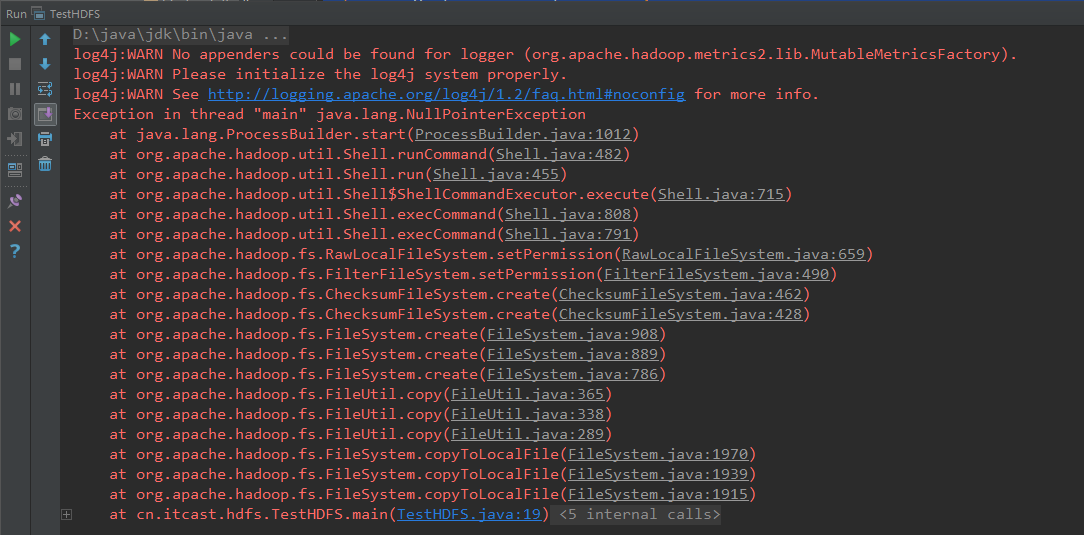
此时会报空指针异常
修改后代码如下:
package cn.itcast.hdfs;

import java.io.IOException;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.fs.FileSystem;

import org.apache.hadoop.fs.Path;

public class TestHDFS {

    public static void main(String[] args) throws IOException {

        Configuration conf = new Configuration();

        //伪造root用户身份

        System.setProperty("HADOOP_USER_NAME", "root");

        //1首先需要一个hdfs的客户端对象

        conf.set("fs.defaultFS", "hdfs://mini1:9000");

        FileSystem fs = FileSystem.get(conf);

//        fs.copyToLocalFile( new Path("/hello.txt"),new Path("E://"));

        fs.copyToLocalFile(false, new Path("/hello.txt"), new Path("E://"), true);

        fs.close();

    }

}
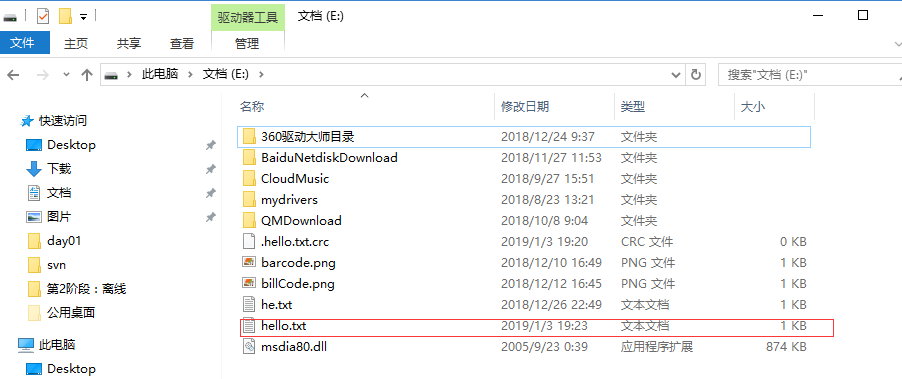
注意,出现以上的问题是没有配环境变量造成的
window下开发的说明
建议在linux下进行hadoop应用的开发,不会存在兼容性问题。如在window上做客户端应用开发,需要设置以下环境:
A、用老师给的windows平台下编译的hadoop安装包解压一份到windows的任意一个目录下
B、在window系统中配置HADOOP_HOME指向你解压的安装包目录
C、在windows系统的path变量中加入HADOOP_HOME的bin目录
大数据学习——下载集群根目录下的文件到E盘的更多相关文章
- 大数据学习——HADOOP集群搭建
4.1 HADOOP集群搭建 4.1.1集群简介 HADOOP集群具体来说包含两个集群:HDFS集群和YARN集群,两者逻辑上分离,但物理上常在一起 HDFS集群: 负责海量数据的存储,集群中的角色主 ...
- 大数据学习——Kafka集群部署
1下载安装包 2解压安装包 -0.9.0.1.tgz -0.9.0.1 kafka 3修改配置文件 cp server.properties server.properties.bak # Lice ...
- 大数据学习——Storm集群搭建
安装storm之前要安装zookeeper 一.安装storm步骤 1.下载安装包 2.解压安装包 .tar.gz storm 3.修改配置文件 mv /root/apps/storm/conf/st ...
- 大数据学习——hdfs集群启动
第一种方式: 1 格式化namecode(是对namecode进行格式化) hdfs namenode -format(或者是hadoop namenode -format) 进入 cd /root/ ...
- 大数据学习——hadoop集群搭建2.X
1.准备Linux环境 1.0先将虚拟机的网络模式选为NAT 1.1修改主机名 vi /etc/sysconfig/network NETWORKING=yes HOSTNAME=itcast ### ...
- 大数据学习——yarn集群启动
启动yarn命令: start-yarn.sh 验证是否启动成功 jps查看进程 http://192.168.74.100:8088页面 关闭 stop-yarn.sh
- 大数据测试之hadoop集群配置和测试
大数据测试之hadoop集群配置和测试 一.准备(所有节点都需要做):系统:Ubuntu12.04java版本:JDK1.7SSH(ubuntu自带)三台在同一ip段的机器,设置为静态IP机器分配 ...
- CDH构建大数据平台-配置集群的Kerberos认证安全
CDH构建大数据平台-配置集群的Kerberos认证安全 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 当平台用户使用量少的时候我们可能不会在一集群安全功能的缺失,因为用户少,团 ...
- 朝花夕拾之--大数据平台CDH集群离线搭建
body { border: 1px solid #ddd; outline: 1300px solid #fff; margin: 16px auto; } body .markdown-body ...
随机推荐
- April Fools Contest 2017 D
Description Input The only line of the input contains a string of digits. The length of the string i ...
- python正则表达式多次提取数据(一个规则提取多组数据)
import re ttt='"FileName":"陈雪凝 - <em>绿色<\/em>","AlbumID":& ...
- 149 Max Points on a Line 直线上最多的点数
给定二维平面上有 n 个点,求最多有多少点在同一条直线上. 详见:https://leetcode.com/problems/max-points-on-a-line/description/ Jav ...
- HAL之定时器
一首先得对定时器的时钟与系统时钟的关系搞清楚,基本定时器的时钟来自APB1最大36MHZ.(定时器倍频值为1) 二 在STM32CubeMX中打开外设功能,时钟源选择内部:然后在配置定时器3中的参数设 ...
- Mysql选择合适的存储引擎
Myisam:默认的mysql插件式存储引擎.如果应用是以读操作和插入操作为主,只有很少的更新和删除操作,并且对事务的完整性.并发性要求不是很高,那么选择这个存储引擎是非常合适的.Myisam是在we ...
- collection接口的实现:set,list,queue
在java.util包中提供了一些集合类,常用的有List.Set和Map类,其中List类和Set类继承了Collection接口.这些集合类又称为容器,长度是可变的,数组用来存放基本数据类型的数据 ...
- js 获取最后一个字符
方法一: str.charAt(str.length - 1) 方法二: str.subStr(str.length-1,1) 方法三: var str = "123456" ...
- 浅谈 echarts 用法
对于服务型的公司来说,需要了解用户的使用趋势,来帮助分析市场的走向,所以说统计在一个管理后台中是必不可少的. 会用到echarts插件 ,其官网网址 http://echarts.baidu.com/ ...
- jQuery Validate自定义各种验证方法(转)
一.封装自定义验证方法-validate-methods.js /***************************************************************** j ...
- Android学习笔记--Intent
Intent是android四大组件之间交互的一种重要方式.Intent可以指明当前要执行的动作,也可以指明要传递的数据.Intent可以用来启动活动,启动服务,发送广播. Intent分为两种:1. ...