
Spark Streaming实时数据分析
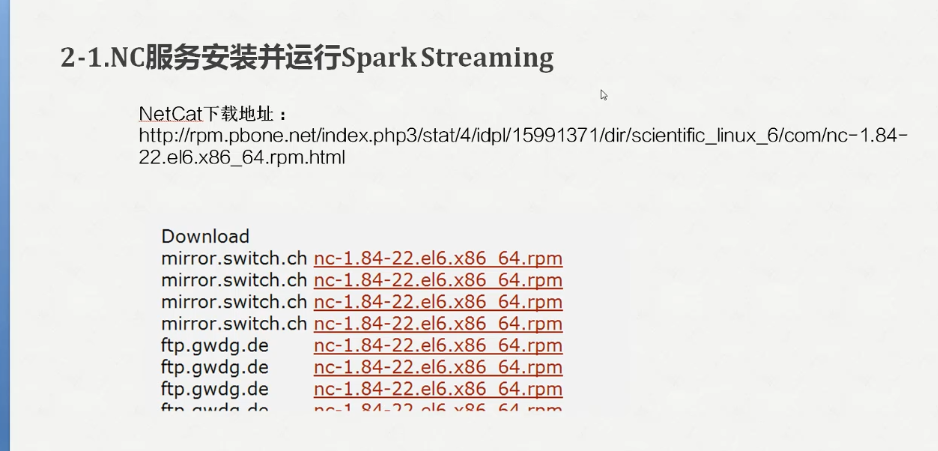
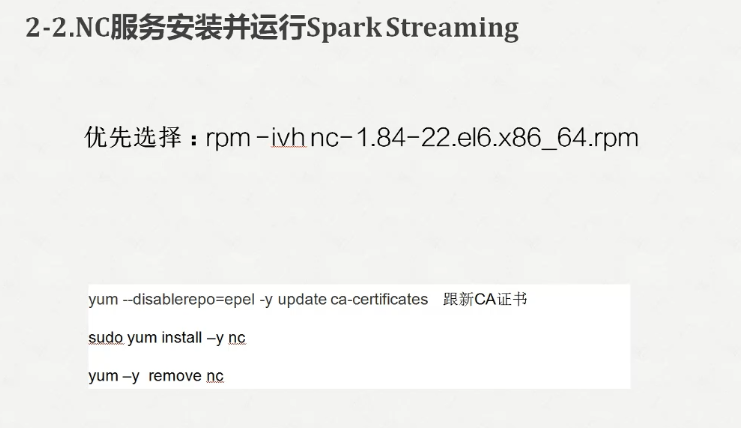
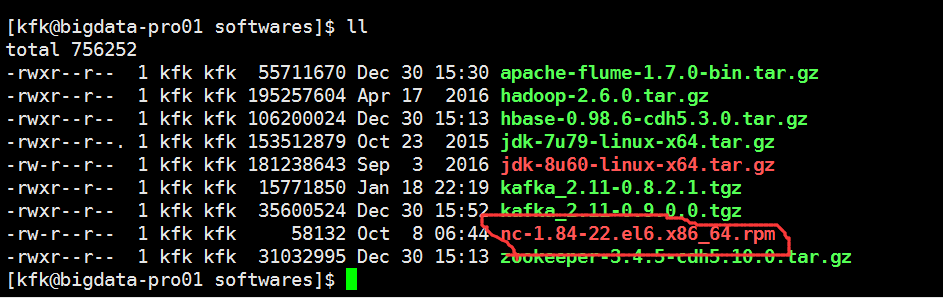

[kfk@bigdata-pro01 softwares]$ sudo rpm -ivh nc-1.84-.el6.x86_64.rpm

Preparing...                ########################################### [%]

   :nc                     ########################################### [%]

[kfk@bigdata-pro01 softwares]$
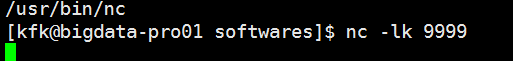
重新启用一个远程连接窗口
bin/run-example streaming.NetworkWordCount localhost

回到这边输入一些信息
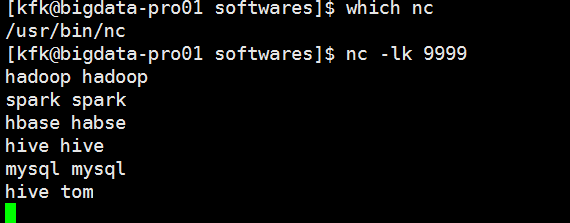
看到这边就有数据接收到了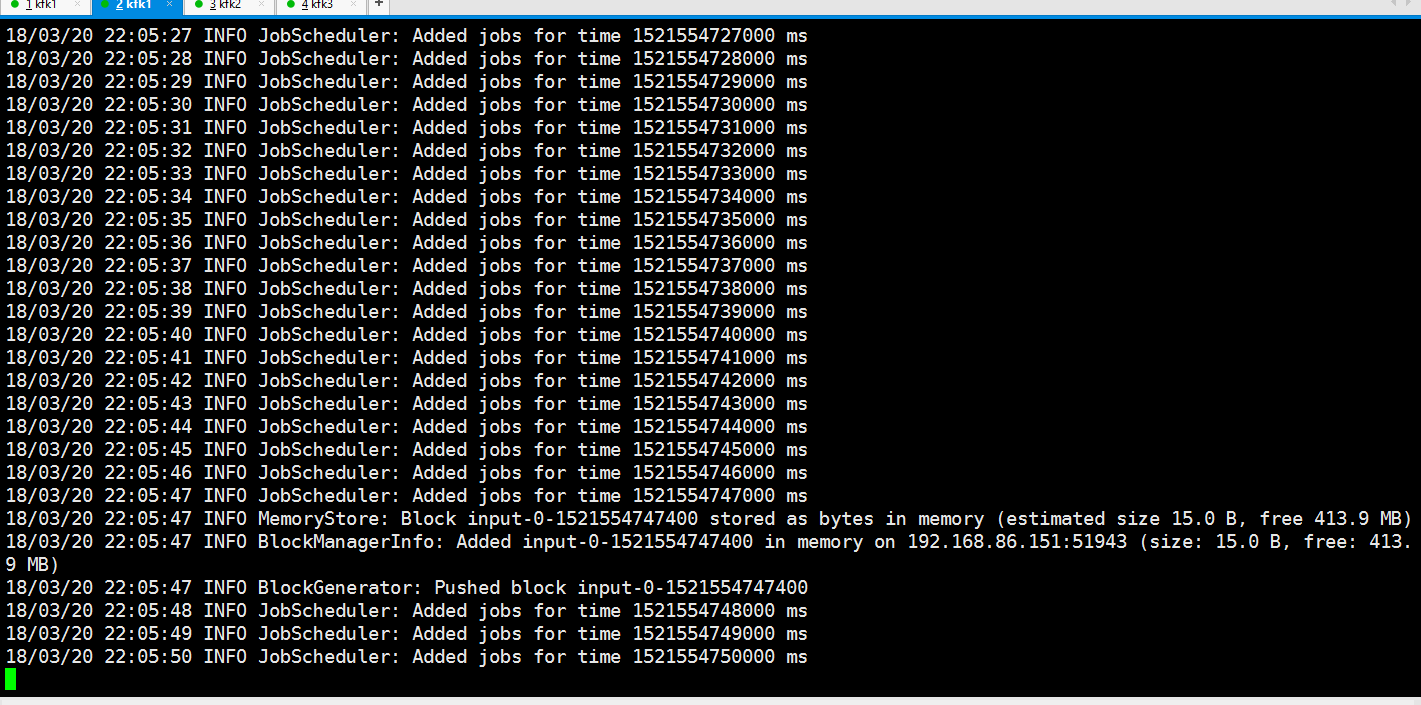
我们退出,换个方式启动
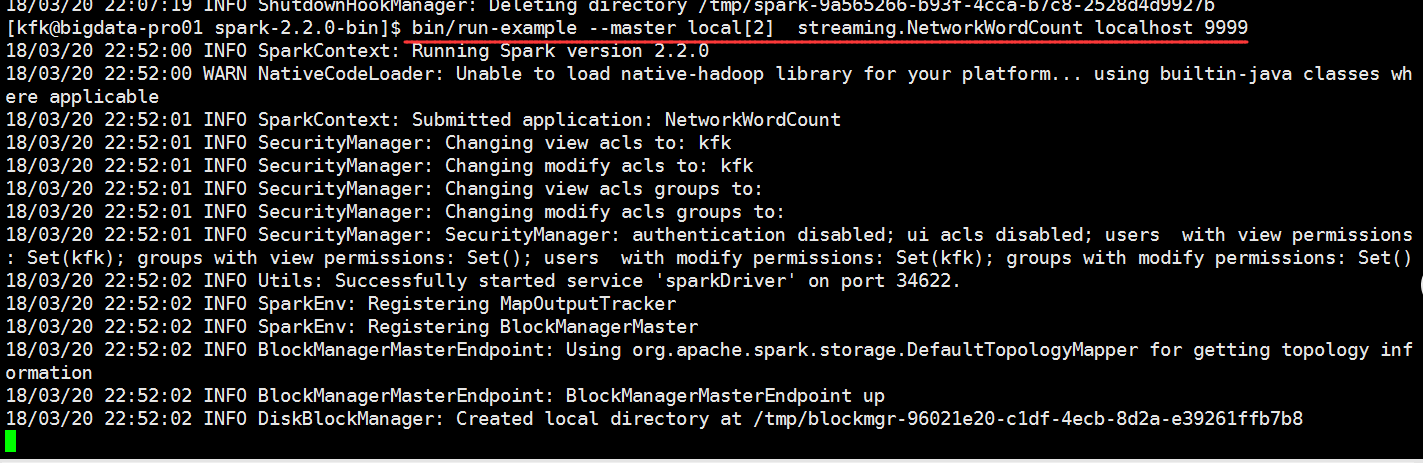
我们在这边再输入一些数据

这边处理得非常快

因为打印的日志信息太多了,我修改一下配置文件(3个节点都修改吧,保守一点了)
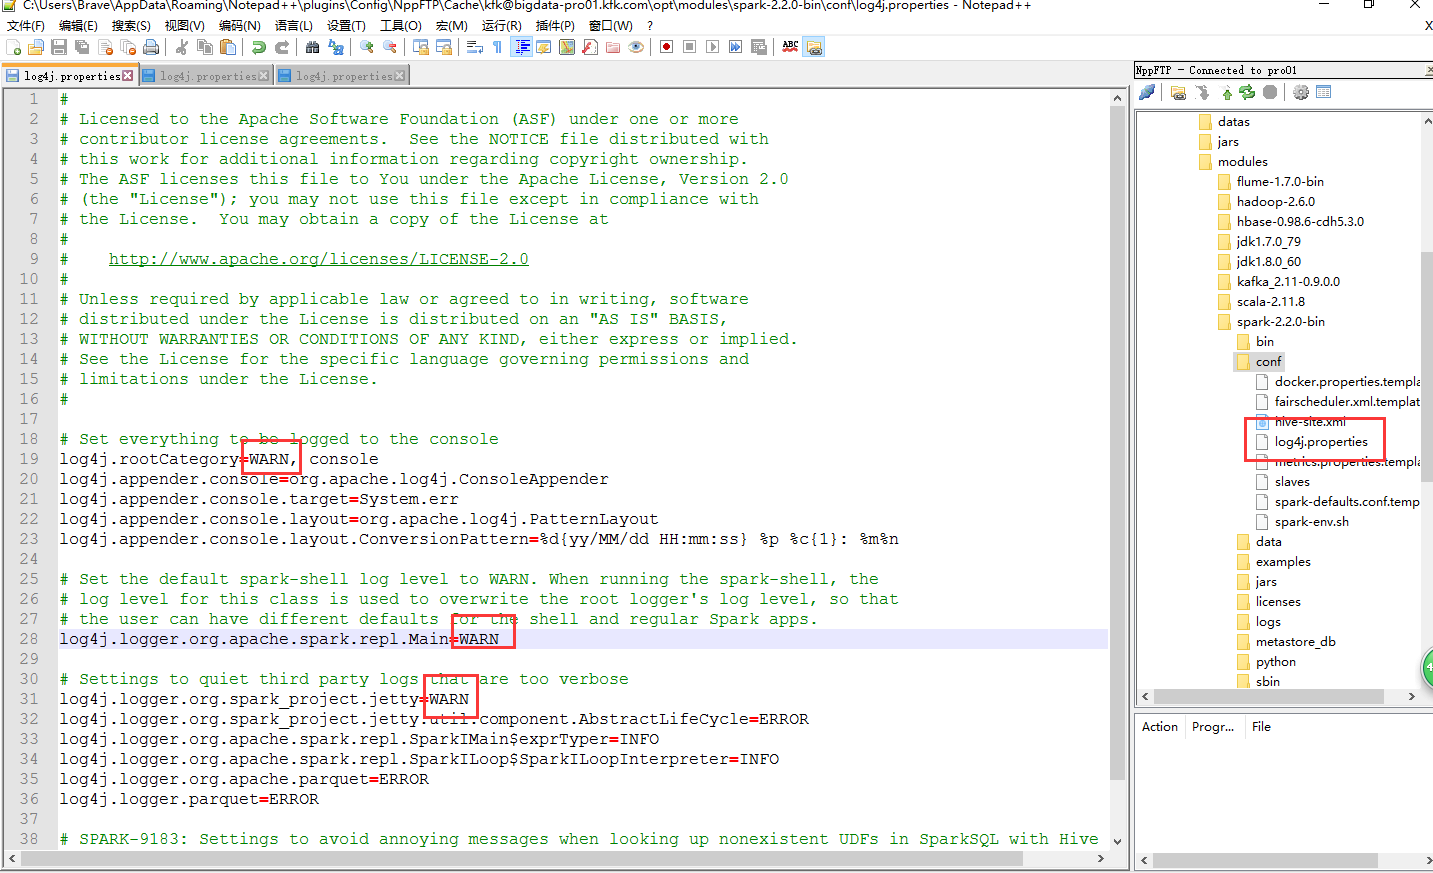
我们在来跑一下

再回到这边我们敲几个字母进去

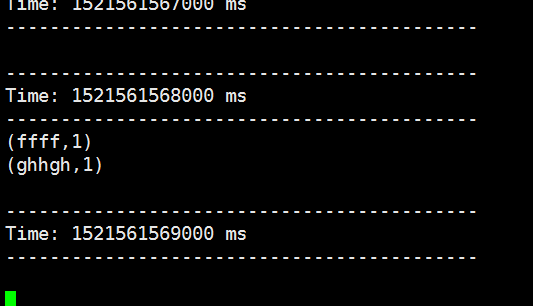
把同样的单词多次输入我们看看是什么结果
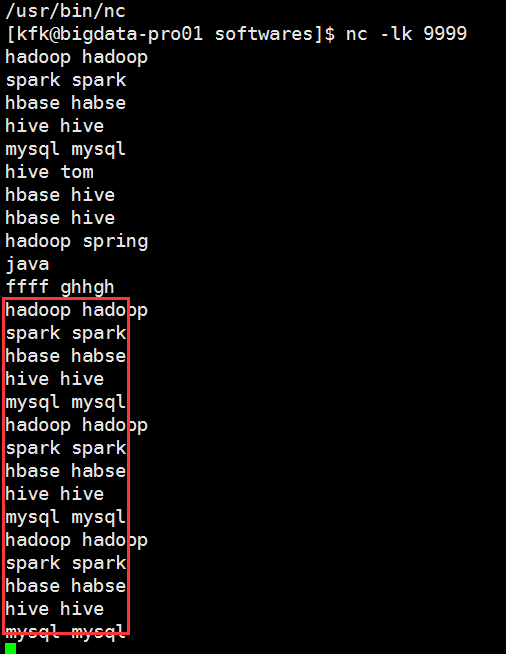
可以看到他会统计
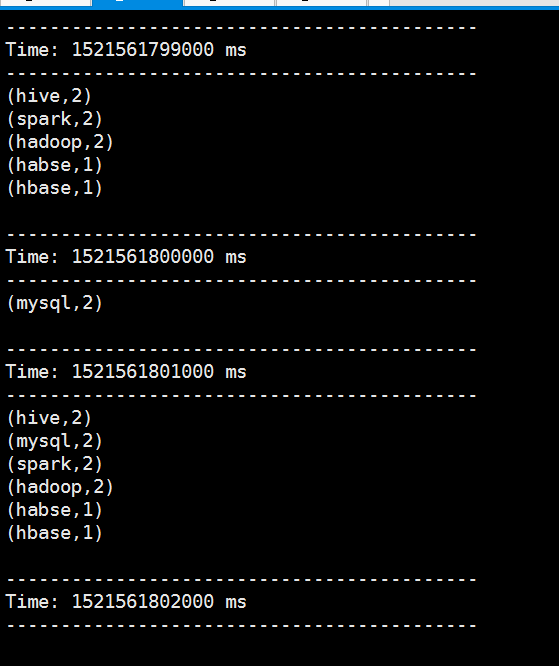
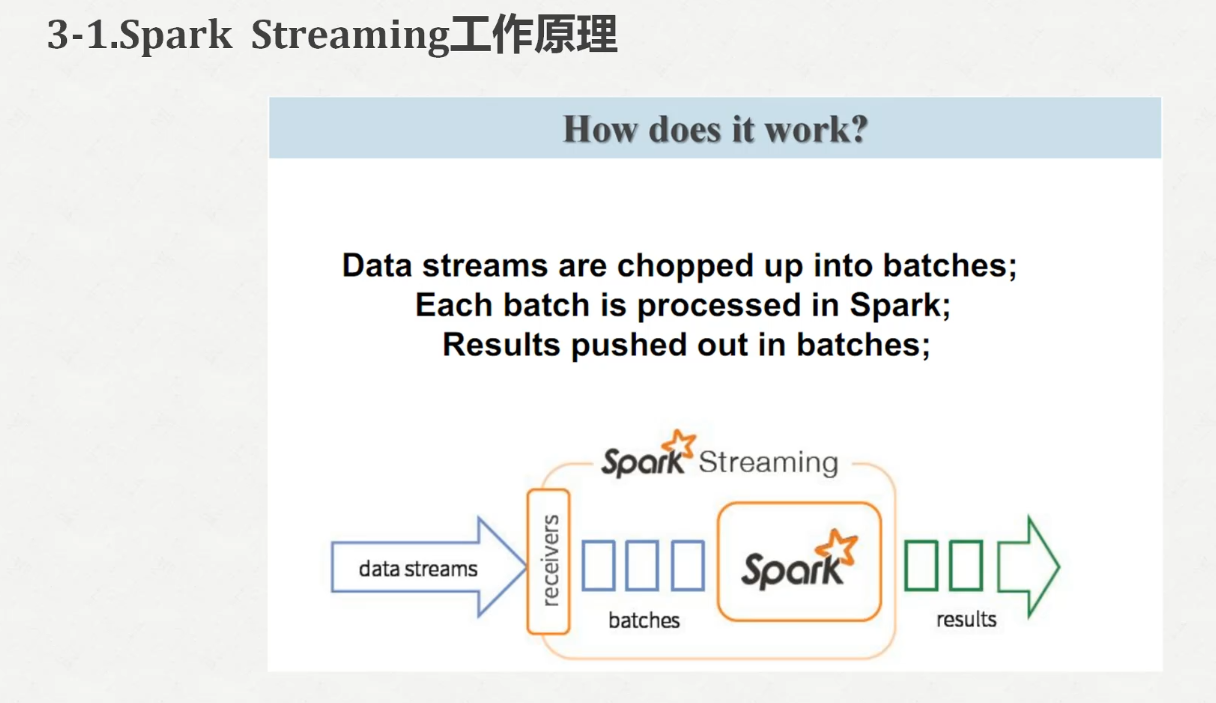
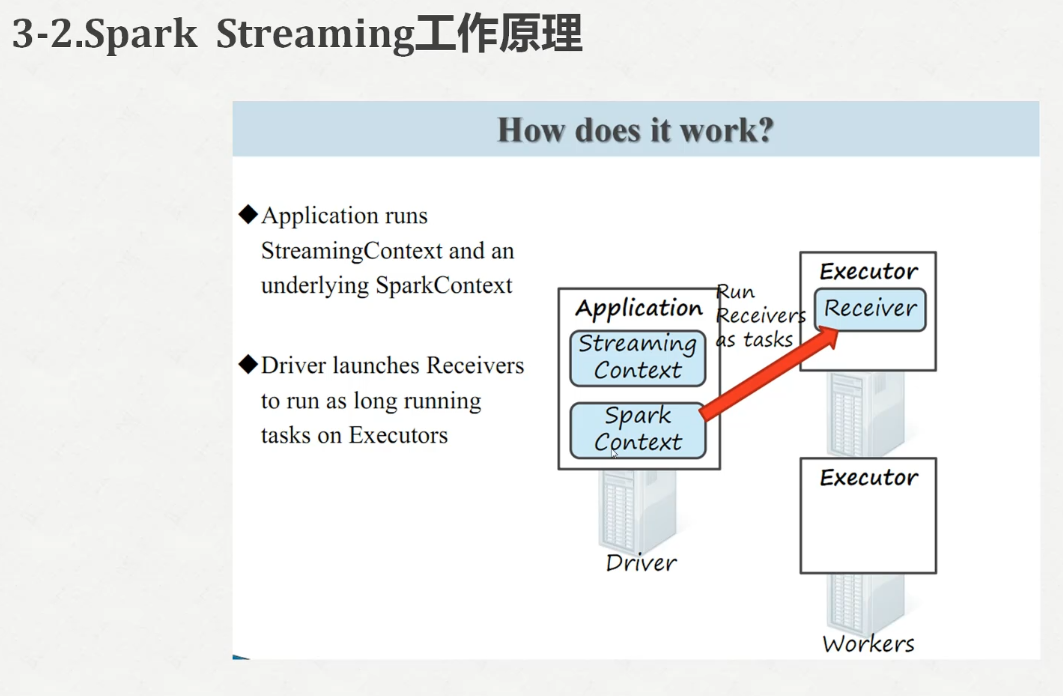
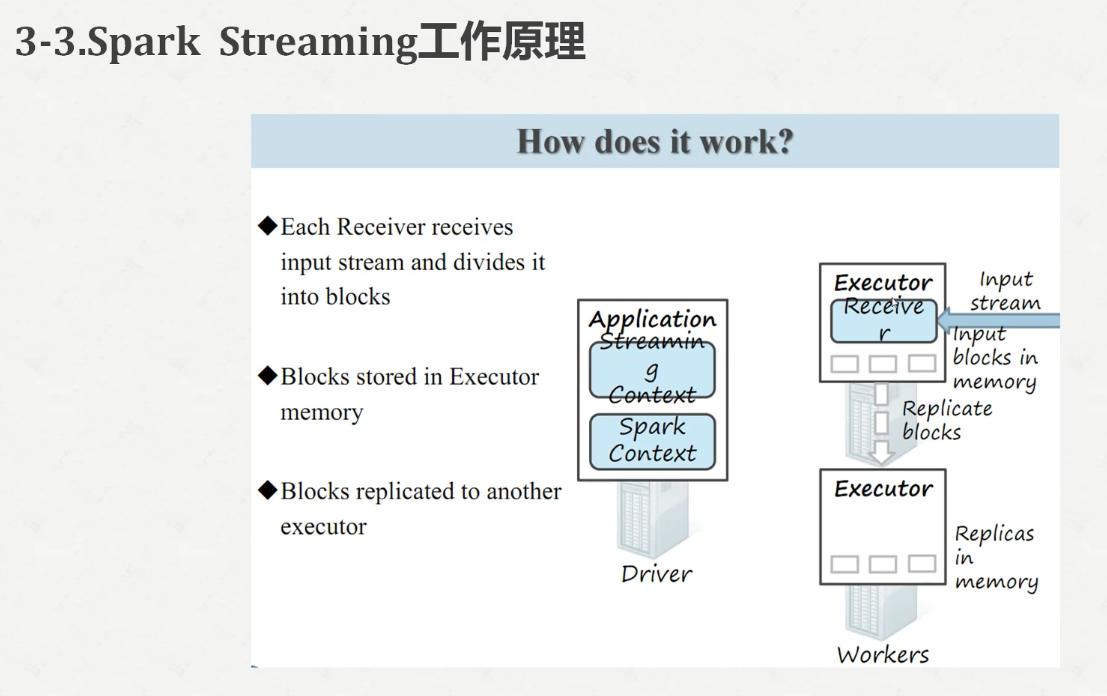


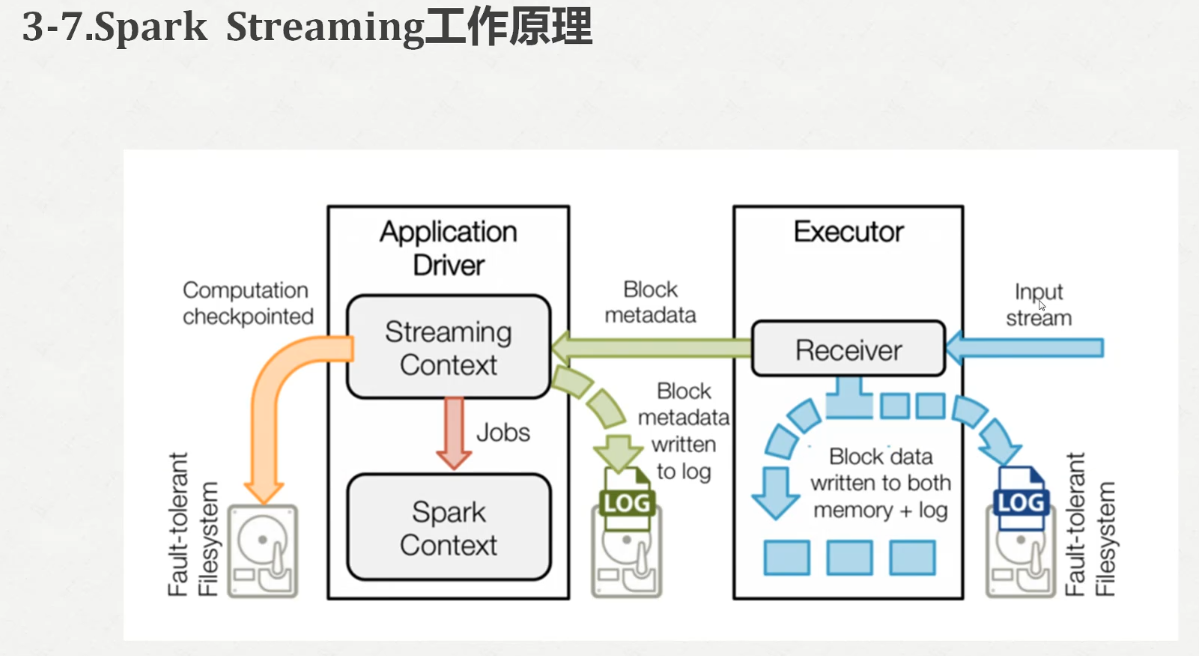


我们启动一下spark-shell,发现报错了

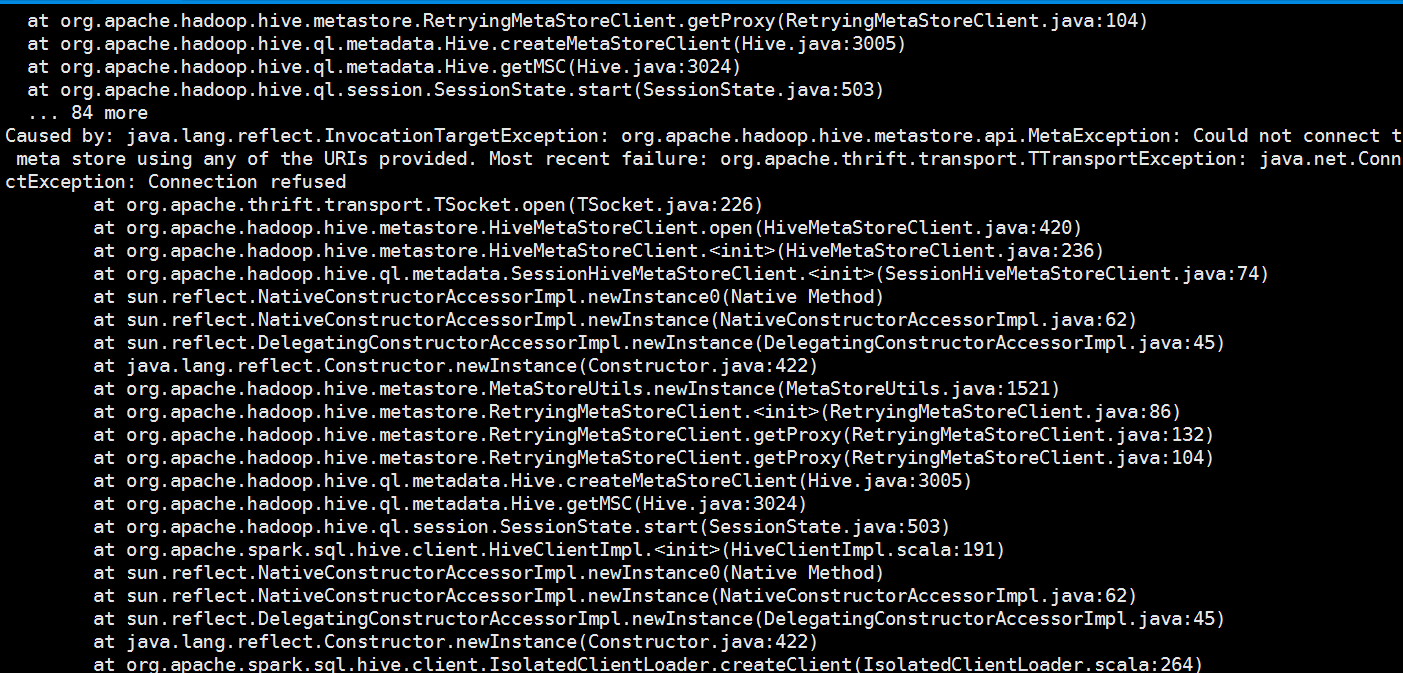
是因为我们前面配置了hive到spark sql 里面,我们先配回来(3个节点都修改)


再启动一下

我们输入代码

scala> import org.apache.spark.streaming._

import org.apache.spark.streaming._

scala> import org.apache.spark.streaming.StreamingContext._

import org.apache.spark.streaming.StreamingContext._

scala> val ssc = new StreamingContext(sc, Seconds())

ssc: org.apache.spark.streaming.StreamingContext = org.apache.spark.streaming.StreamingContext@431f8830

scala> val lines = ssc.socketTextStream("localhost", )

lines: org.apache.spark.streaming.dstream.ReceiverInputDStream[String] = org.apache.spark.streaming.dstream.SocketInputDStream@23f27434

scala> val words = lines.flatMap(_.split(" "))

words: org.apache.spark.streaming.dstream.DStream[String] = org.apache.spark.streaming.dstream.FlatMappedDStream@2c3df478

scala> val pairs = words.map(word => (word, ))

pairs: org.apache.spark.streaming.dstream.DStream[(String, Int)] = org.apache.spark.streaming.dstream.MappedDStream@6d3dc0c5

scala> val wordCounts = pairs.reduceByKey(_ + _)

wordCounts: org.apache.spark.streaming.dstream.DStream[(String, Int)] = org.apache.spark.streaming.dstream.ShuffledDStream@8fa4647

scala> wordCounts.print()

scala>
最后启动一下服务发现报错了
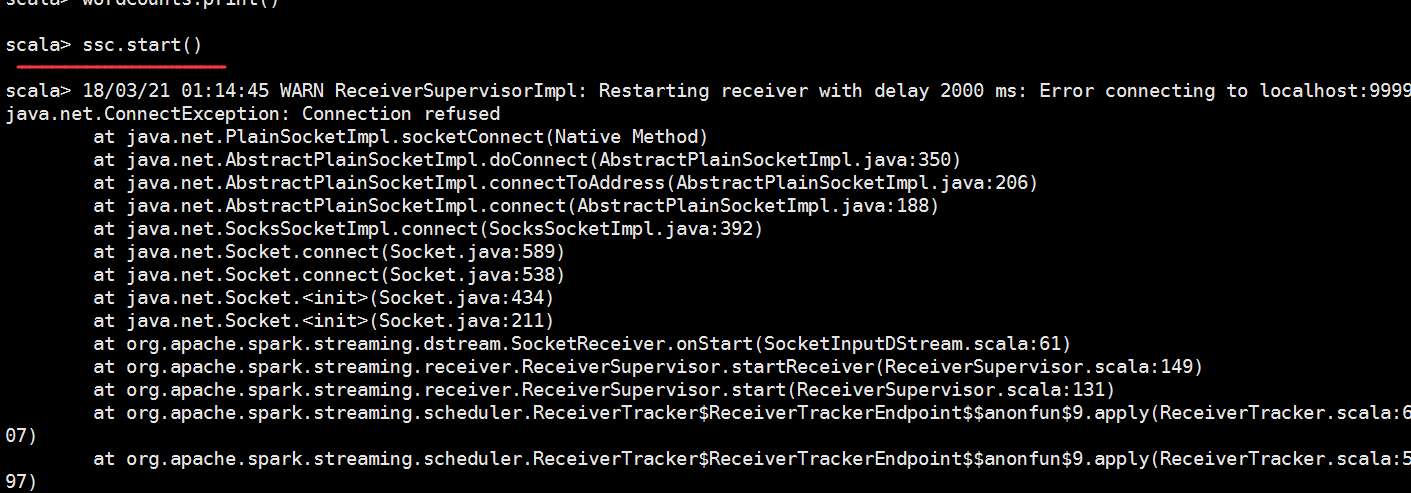
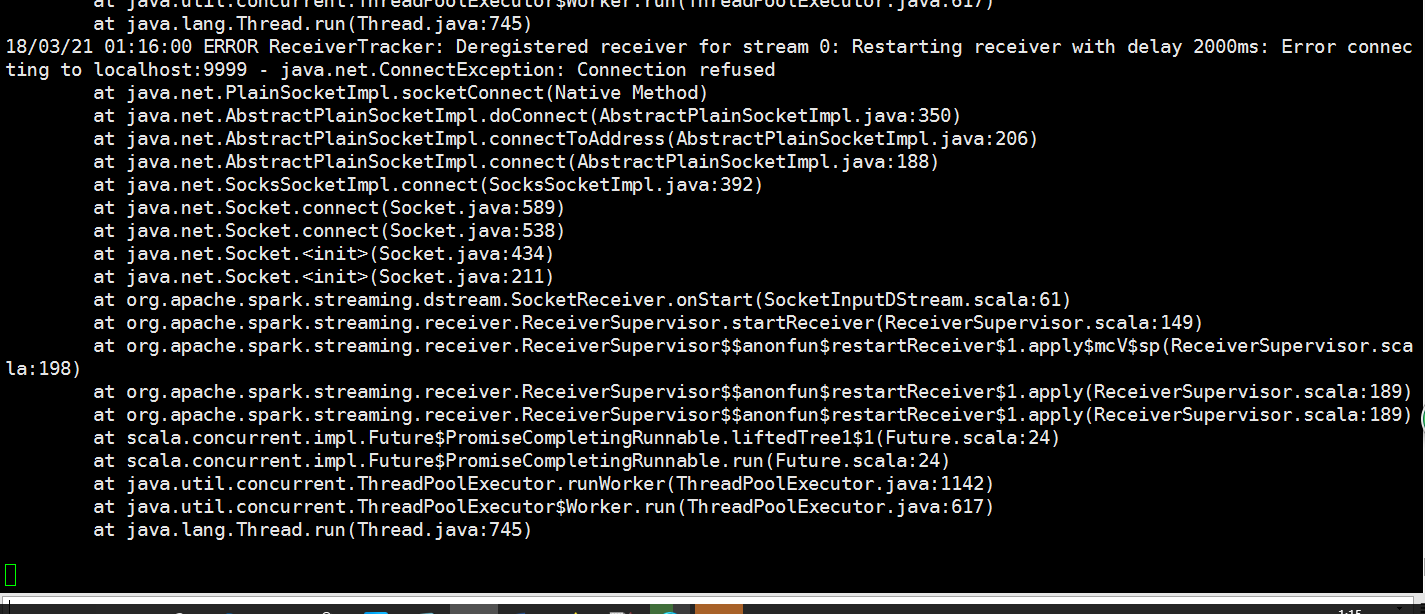
是因为没有启动nc
现在把他启动
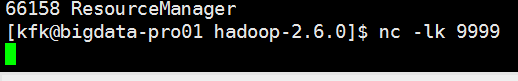
我们敲进去一些数据
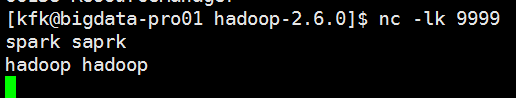

退出再启动一次

再次把代码放进来

我们在nc那边输入数据

回到这边看看结果

打开我们的idea

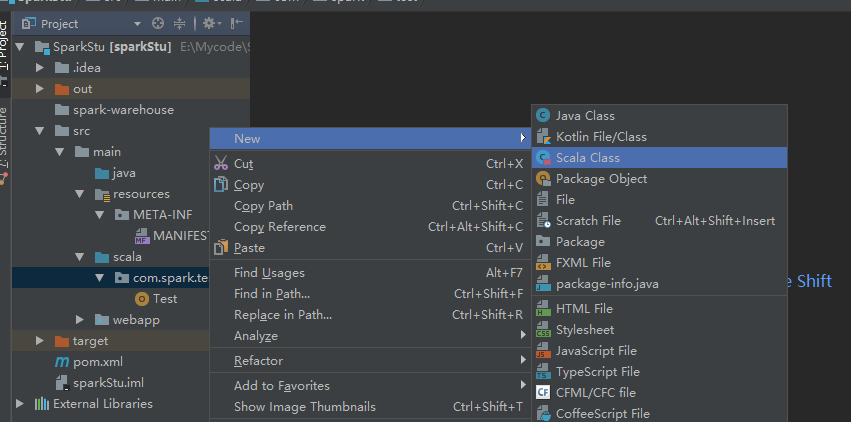


package com.spark.test

import org.apache.spark.sql.SparkSession

import org.apache.spark.streaming._

import org.apache.spark.streaming.StreamingContext._

import org.apache.spark.{SparkConf, SparkContext}

object Test {

  def main(args: Array[String]): Unit = {

   val spark= SparkSession

       .builder

         .master("local[2]")

         .appName("HdfsTest")

           .getOrCreate()

    val ssc = new  StreamingContext(spark.sparkContext, Seconds());

    val lines = ssc.socketTextStream("localhost", )

    val words = lines.flatMap(_.split(" "))

  }

}


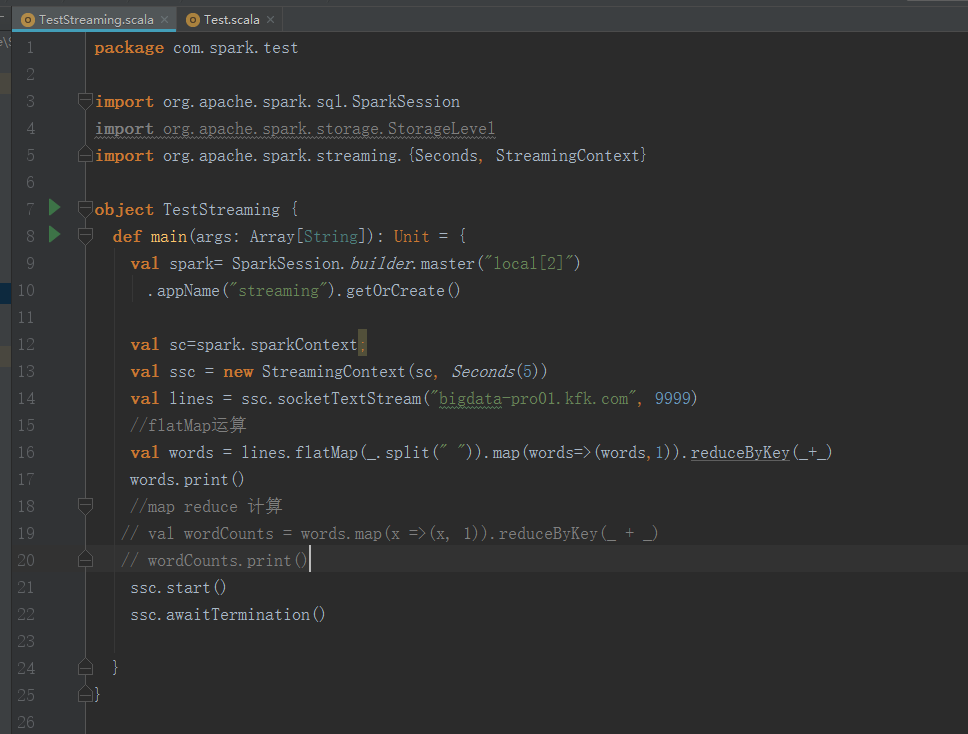
package com.spark.test

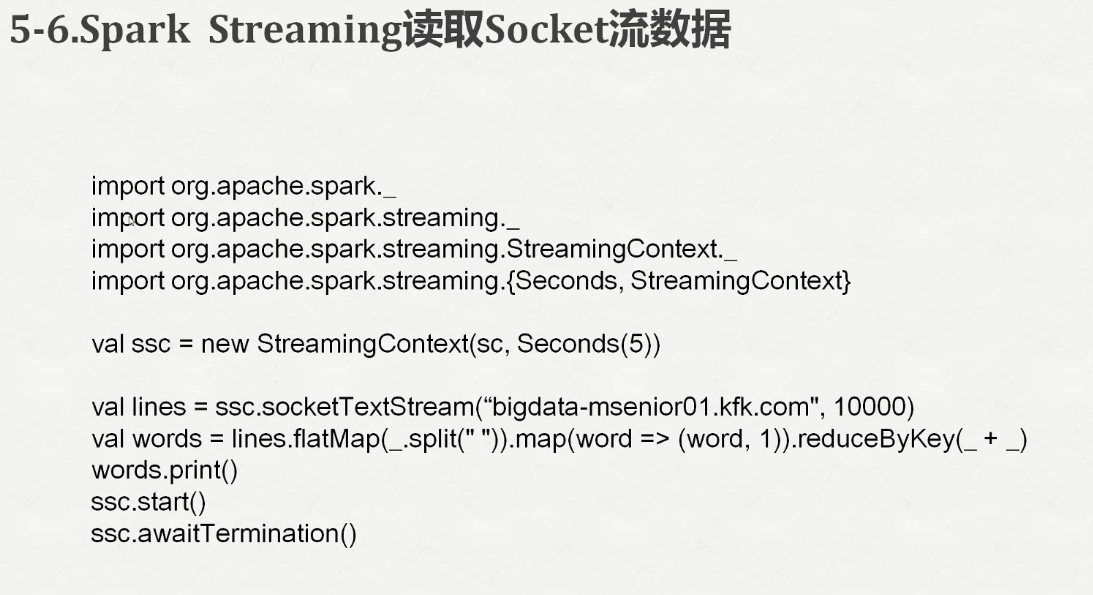
import org.apache.spark.sql.SparkSession

import org.apache.spark.storage.StorageLevel

import org.apache.spark.streaming.{Seconds, StreamingContext}

object TestStreaming {

  def main(args: Array[String]): Unit = {

    val spark= SparkSession.builder.master("local[2]")

      .appName("streaming").getOrCreate()

    val sc=spark.sparkContext;

    val ssc = new StreamingContext(sc, Seconds())

    val lines = ssc.socketTextStream("bigdata-pro01.kfk.com", )

    //flatMap运算

    val words = lines.flatMap(_.split(" ")).map(words=>(words,)).reduceByKey(_+_)

    words.print()

    //map reduce 计算

   // val wordCounts = words.map(x =>(x, 1)).reduceByKey(_ + _)

   // wordCounts.print()

    ssc.start()

    ssc.awaitTermination()

  }

}


这个过程呢要这样操作,先把程序运行,再启动nc,再到nc界面输入单词

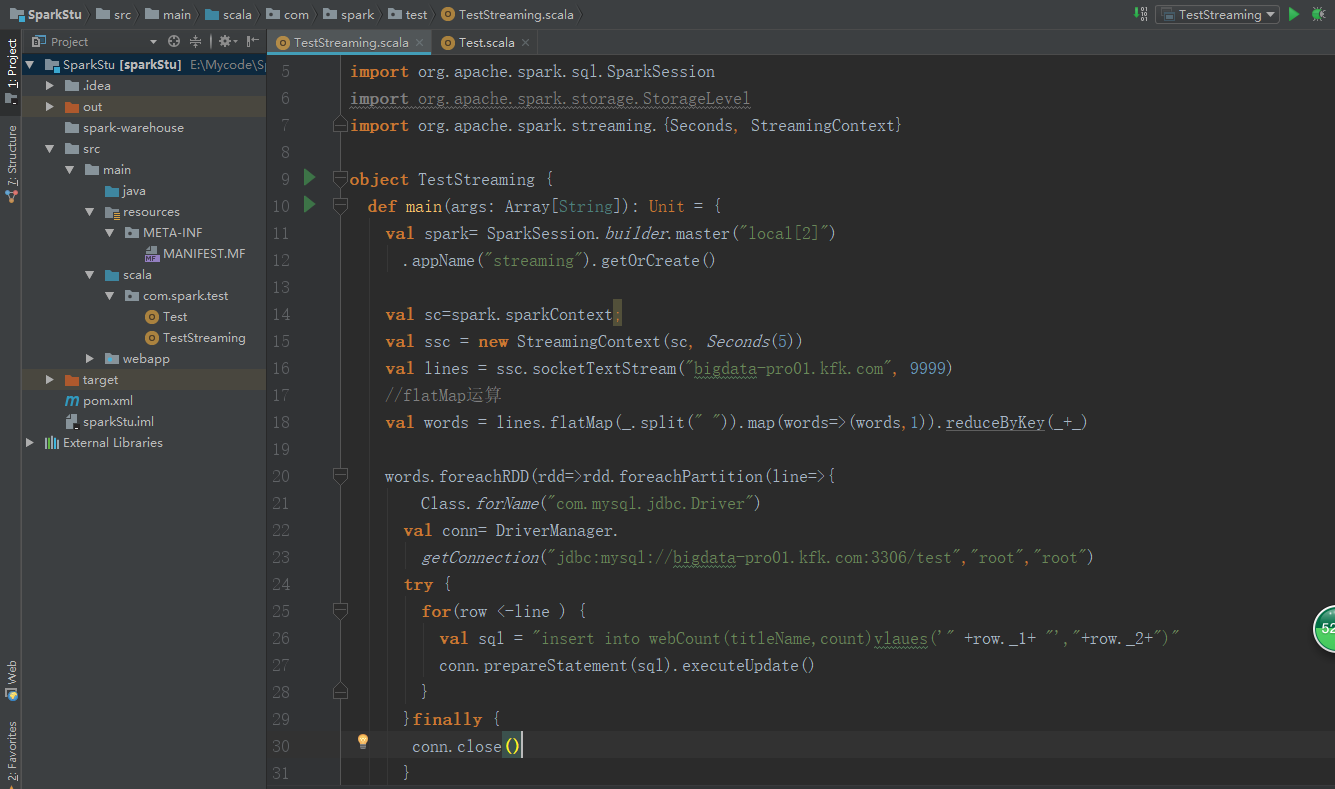
package com.spark.test

import java.sql.DriverManager

import org.apache.spark.sql.SparkSession

import org.apache.spark.storage.StorageLevel

import org.apache.spark.streaming.{Seconds, StreamingContext}

object TestStreaming {

  def main(args: Array[String]): Unit = {

    val spark= SparkSession.builder.master("local[2]")

      .appName("streaming").getOrCreate()

    val sc=spark.sparkContext;

    val ssc = new StreamingContext(sc, Seconds())

    val lines = ssc.socketTextStream("bigdata-pro01.kfk.com", )

    //flatMap运算

    val words = lines.flatMap(_.split(" ")).map(words=>(words,)).reduceByKey(_+_)

    words.foreachRDD(rdd=>rdd.foreachPartition(line=>{

        Class.forName("com.mysql.jdbc.Driver")

      val conn= DriverManager.

        getConnection("jdbc:mysql://bigdata-pro01.kfk.com:3306/test","root","root")

      try {

        for(row <-line ) {

          val sql = "insert into webCount(titleName,count)values('" +row._1+ "',"+row._2+")"

          conn.prepareStatement(sql).executeUpdate()

        }

      }finally {

       conn.close()

      }

    }))

    words.print()

    //map reduce 计算

   // val wordCounts = words.map(x =>(x, 1)).reduceByKey(_ + _)

   // wordCounts.print()

    ssc.start()

    ssc.awaitTermination()

  }

}
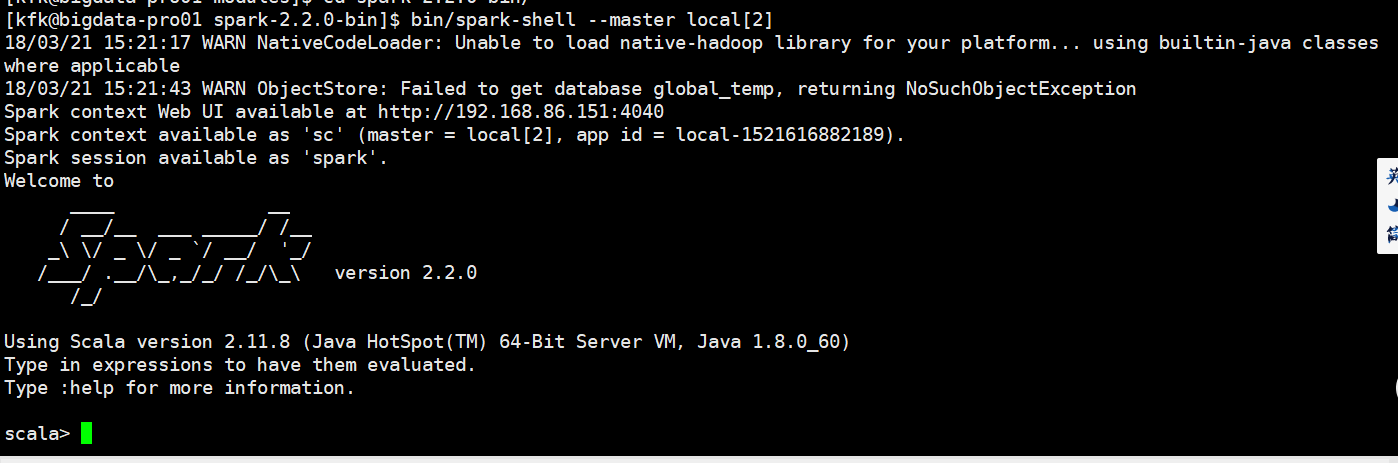
我们把代码拷进来

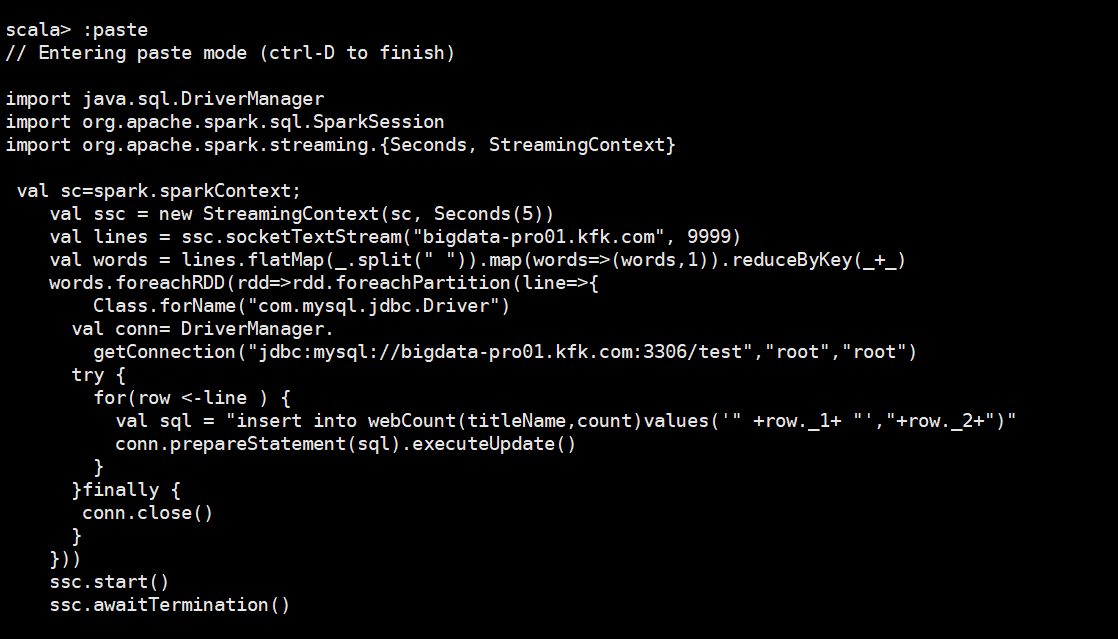
import java.sql.DriverManager

import org.apache.spark.sql.SparkSession

import org.apache.spark.streaming.{Seconds, StreamingContext}

 val sc=spark.sparkContext;

    val ssc = new StreamingContext(sc, Seconds())

    val lines = ssc.socketTextStream("bigdata-pro01.kfk.com", )

    val words = lines.flatMap(_.split(" ")).map(words=>(words,)).reduceByKey(_+_)

    words.foreachRDD(rdd=>rdd.foreachPartition(line=>{

        Class.forName("com.mysql.jdbc.Driver")

      val conn= DriverManager.

        getConnection("jdbc:mysql://bigdata-pro01.kfk.com:3306/test","root","root")

      try {

        for(row <-line ) {

          val sql = "insert into webCount(titleName,count)values('" +row._1+ "',"+row._2+")"

          conn.prepareStatement(sql).executeUpdate()

        }

      }finally {

       conn.close()

      }

    }))

    ssc.start()

    ssc.awaitTermination()
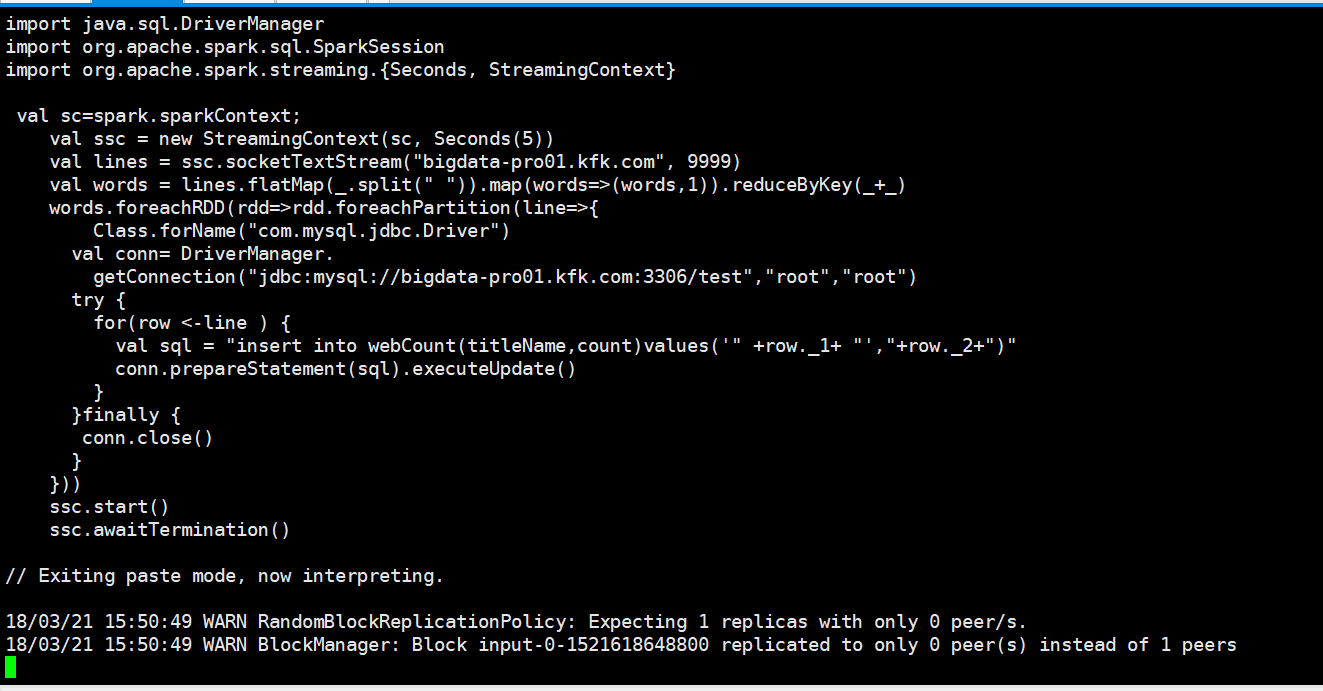
我们输入数据

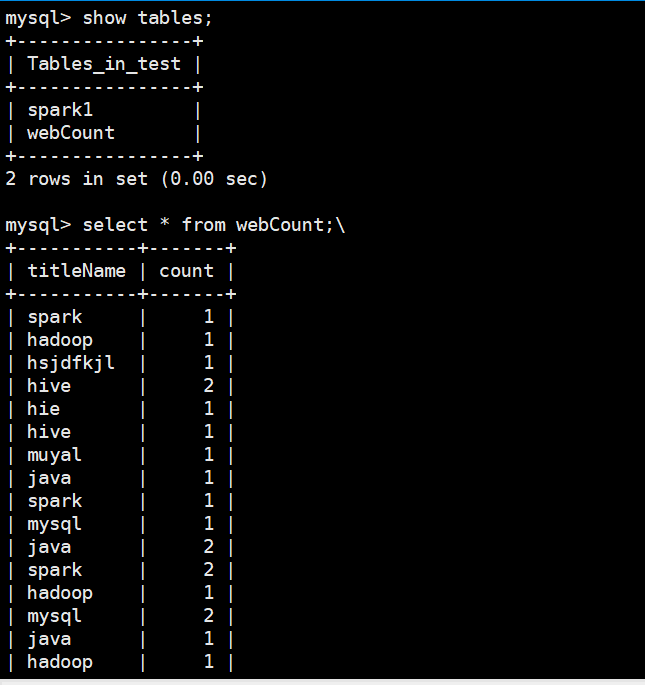
我们通过mysql查看一下表里面的数据
Spark Streaming实时数据分析的更多相关文章
- 新闻实时分析系统 Spark Streaming实时数据分析
1.Spark Streaming功能介绍1)定义Spark Streaming is an extension of the core Spark API that enables scalable ...
- 新闻网大数据实时分析可视化系统项目——19、Spark Streaming实时数据分析
1.Spark Streaming功能介绍 1)定义 Spark Streaming is an extension of the core Spark API that enables scalab ...
- Spark Streaming实时计算框架介绍
随着大数据的发展,人们对大数据的处理要求也越来越高,原有的批处理框架MapReduce适合离线计算,却无法满足实时性要求较高的业务,如实时推荐.用户行为分析等. Spark Streaming是建立在 ...
- 【Streaming】30分钟概览Spark Streaming 实时计算
本文主要介绍四个问题: 什么是Spark Streaming实时计算? Spark实时计算原理流程是什么? Spark 2.X下一代实时计算框架Structured Streaming Spark S ...
- 【转】Spark Streaming 实时计算在甜橙金融监控系统中的应用及优化
系统架构介绍 整个实时监控系统的架构是先由 Flume 收集服务器产生的日志 Log 和前端埋点数据, 然后实时把这些信息发送到 Kafka 分布式发布订阅消息系统,接着由 Spark Streami ...
- Spark练习之通过Spark Streaming实时计算wordcount程序
Spark练习之通过Spark Streaming实时计算wordcount程序 Java版本 Scala版本 pom.xml Java版本 import org.apache.spark.Spark ...
- 大数据Spark+Kafka实时数据分析案例
本案例利用Spark+Kafka实时分析男女生每秒购物人数,利用Spark Streaming实时处理用户购物日志,然后利用websocket将数据实时推送给浏览器,最后浏览器将接收到的数据实时展现, ...
- 【慕课网实战】Spark Streaming实时流处理项目实战笔记十六之铭文升级版
铭文一级: linux crontab 网站:http://tool.lu/crontab 每一分钟执行一次的crontab表达式: */1 * * * * crontab -e */1 * * * ...
- 【慕课网实战】Spark Streaming实时流处理项目实战笔记十五之铭文升级版
铭文一级:[木有笔记] 铭文二级: 第12章 Spark Streaming项目实战 行为日志分析: 1.访问量的统计 2.网站黏性 3.推荐 Python实时产生数据 访问URL->IP信息- ...
随机推荐
- mina学习总结
一.简介: Apache Mina Server 是一个网络通信应用框架,Mina 可以帮助我们快速开发高性能.高扩展性的网络通信应用,Mina 提供了事件驱动.异步(Mina 的异步 IO 默认使用 ...
- hdfs 例子
package hadoop; import java.io.IOException; import java.net.URI; import java.net.URISyntaxException; ...
- 获取laravel项目的路径的内置帮助函数
app_path() app_path函数返回app目录的绝对路径: $path = app_path(); 你还可以使用app_path函数为相对于app目录的给定文件生成绝对路径: $path = ...
- Scala实战
1. Eclipse中设置scala调试器 scala的调试器要选择Scala Application(new debuger)Launcher:开始选择图省事,选择了一个字母少的,亲切的Launch ...
- 多线程中的Lock小结
出处:http://www.cnblogs.com/DarrenChan/p/6528578.html#undefined 1.lock和synchronized的区别 1)Lock不是Java语言内 ...
- 记录一次linux删除mysql
service mysqld status service mysqld stop ps –ef | grep mysql perl-DBD-MySQL-4.013-3.el6.x86_64 //删除 ...
- maven添加自定义jar
mvn install:install-file -Dfile=自定义jar文件路径 -DgroupId=所属组 -DartifactId=项目名 -Dversion=版本 -Dpackaging=j ...
- GTX log 6
5.24-7.2 相关算法 判断两颗二叉树相等 有两种方法:一种是递归比较.另一种是二叉树的遍历. 先说二叉树的遍历.由于先序遍历 再加上 中序遍历能唯一确定一棵二叉树.故,对这两棵树分别进行先序和中 ...
- [转] nginx配置优化+负载均衡+动静分离(附带参数解析)
#指定nginx进程运行用户以及用户组user www www;#nginx要开启的进程数为8worker_processes 8;#全局错误日志文件#debug输出日志最为详细,而crit输出日志 ...
- Linux磁盘监控工具说明
1.1 iostat 系统systat包里的工具,以kB/s为单位统计,2表示以2秒为频率统计一次:iostat –x –k 2 10000 rrqm/s:每秒这个设备相关的读取请求有多少被Merge ...