
利用 ImageAI 在 COCO 上学习目标检测
ImageAI是一个python库,旨在使开发人员能够使用简单的几行代码构建具有包含深度学习和计算机视觉功能的应用程序和系统。 这个 AI Commons 项目https://commons.specpal.science 由 Moses Olafenwa 和 John Olafenwa 开发和维护。为了更好的使用 ImageAI,我将其 Fork 到 CodeXZone/ImageAI。同时,ImageAI 也提供了中文手册:imageai。下面我将借助该教程一步一步的学习目标检测。
利用 cocoz 载入 COCO 数据集
首先,利用 cocoz 载入 COCOZ:
import sys

# 将 cocoapi 添加进入环境变量

sys.path.append(r'D:\API\cocoapi\PythonAPI')

from pycocotools.cocoz import AnnZ, ImageZ, COCOZ

# ------------------

import numpy as np

from matplotlib import pyplot as plt

from IPython import display

def use_svg_display():

    # 用矢量图显示, 效果更好

    display.set_matplotlib_formats('svg')

def show_imgs(imgs, k=4):

    '''

    展示 多张图片

    '''

    n = len(imgs)

    h, w = k, n // k

    assert n == h * w, "图片数量不匹配"

    use_svg_display()

    _, ax = plt.subplots(h, w, figsize=(5, 5))  # 设置图的尺寸

    K = np.arange(n).reshape((h, w))

    for i in range(h):

        for j in range(w):

            img = imgs[K[i, j]]

            ax[i][j].imshow(img)

            ax[i][j].axes.get_yaxis().set_visible(False)

            ax[i][j].set_xticks([])

    plt.show()
dataDir = r'E:\Data\coco\images'   # COCO 数据根目录

dataType = 'train2017'

imgZ = ImageZ(dataDir, dataType)

show_imgs(imgZ[300:316])

物体检测,提取和微调
import sys

sys.path.append('D:/API/ImageAI')

from imageai.Detection import ObjectDetection

import os

execution_path = os.getcwd()

detector = ObjectDetection()  # 创建目标检测实例

detector.setModelTypeAsRetinaNet()

detector.setModelPath(

    os.path.join(execution_path, "resnet50_coco_best_v2.0.1.h5"))

detector.loadModel()  # 载入预训练模型
由于 detector.detectObjectsFromImage 比较容易支持解压后的图片,所以我们可以提取出一张图片来做测试:
input_image = imgZ.Z.extract(imgZ.names[0]) # 输入文件的路径

output_image = os.path.join(execution_path, "image2new.jpg")  # 输出文件的路径

detections = detector.detectObjectsFromImage(

    input_image=input_image, output_image_path=output_image)

for eachObject in detections:

    print(eachObject["name"] + " : ", eachObject["percentage_probability"])

    print("--------------------------------")
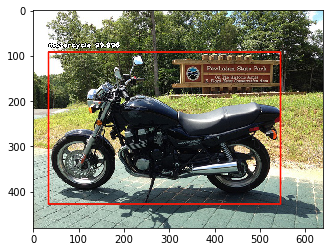
motorcycle :  99.99607801437378

--------------------------------
detectObjectsFromImage() 函数返回一个字典列表,每个字典包含图像中检测到的对象信息,字典中的对象信息有 name(对象类名)和 percentage_probability(概率)以及 box_points(图片的左上角与右下角的坐标)。
detections
[{'name': 'motorcycle',

  'percentage_probability': 99.99607801437378,

  'box_points': array([ 34,  92, 546, 427])}]
下面我们看看其标注框:
img = plt.imread(output_image)

plt.imshow(img)

plt.show()
为了直接使用压缩文件,我们可以修改 detectObjectsFromImage 的默认参数 input_type='file' 为 input_type='array':
input_image = imgZ[202]  # 输入文件的路径

output_image = os.path.join(execution_path, "image2.jpg")  # 输出文件的路径

detections = detector.detectObjectsFromImage(

    input_image=input_image, output_image_path=output_image, input_type='array')

for eachObject in detections:

    print(eachObject["name"] + " : ", eachObject["percentage_probability"])

    print("--------------------------------")

img = plt.imread(output_image)

plt.imshow(img)

plt.show()
tennis racket :  54.25310730934143

--------------------------------

person :  99.85058307647705

--------------------------------

detections, objects_path = detector.detectObjectsFromImage(

    input_image=imgZ[900], input_type = 'array',

    output_image_path=os.path.join(execution_path, "image3new.jpg"),

    extract_detected_objects=True)

for eachObject, eachObjectPath in zip(detections, objects_path):

    print(eachObject["name"] + " : ", eachObject["percentage_probability"])

    print("Object's image saved in ", eachObjectPath)

    print("--------------------------------")
person :  56.35678172111511

Object's image saved in  D:\API\CVX\draft\image3new.jpg-objects\person-1.jpg

--------------------------------

person :  75.83483457565308

Object's image saved in  D:\API\CVX\draft\image3new.jpg-objects\person-2.jpg

--------------------------------

person :  60.49004793167114

Object's image saved in  D:\API\CVX\draft\image3new.jpg-objects\person-3.jpg

--------------------------------

person :  85.2730393409729

Object's image saved in  D:\API\CVX\draft\image3new.jpg-objects\person-4.jpg

--------------------------------

person :  83.12703967094421

Object's image saved in  D:\API\CVX\draft\image3new.jpg-objects\person-5.jpg

--------------------------------

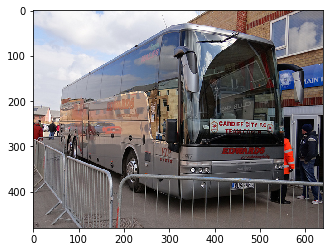
bus :  99.7751772403717

Object's image saved in  D:\API\CVX\draft\image3new.jpg-objects\bus-6.jpg

--------------------------------
extract_detected_objects=True 将会把检测到的对象提取并保存为单独的图像;这将使函数返回 2 个值,第一个是字典数组,每个字典对应一个检测到的对象信息,第二个是所有提取出对象的图像保存路径,并且它们按照对象在第一个数组中的顺序排列。我们先看看原图:
plt.imshow(imgZ[900])

plt.show()
显示识别出来的对象:
show_imgs([plt.imread(fname) for fname in objects_path], 2)

还有一个十分重要的参数 minimum_percentage_probability 用于设定预测概率的阈值,其默认值为 50(范围在 \(0-100\)之间)。如果保持默认值,这意味着只有当百分比概率大于等于 50 时,该函数才会返回检测到的对象。使用默认值可以确保检测结果的完整性,但是在检测过程中可能会跳过许多对象。下面我们看看修改后的效果:
detections = detector.detectObjectsFromImage(

    input_image=imgZ[900],

    input_type='array',

    output_image_path=os.path.join(execution_path, "image3new.jpg"),

    minimum_percentage_probability=70)

for eachObject in detections:

    print(eachObject["name"] + " : ", eachObject["percentage_probability"])

    print("--------------------------------")
person :  75.83483457565308

--------------------------------

person :  85.2730393409729

--------------------------------

person :  83.12703967094421

--------------------------------

bus :  99.7751772403717

--------------------------------
我们将 minimum_percentage_probability 设置为 70,此时仅仅只能检测到 4 个。
利用 ImageAI 在 COCO 上学习目标检测的更多相关文章
- GPU上创建目标检测Pipeline管道
GPU上创建目标检测Pipeline管道 Creating an Object Detection Pipeline for GPUs 今年3月早些时候,展示了retinanet示例,这是一个开源示例 ...
- 论文学习-深度学习目标检测2014至201901综述-Deep Learning for Generic Object Detection A Survey
目录 写在前面 目标检测任务与挑战 目标检测方法汇总 基础子问题 基于DCNN的特征表示 主干网络(network backbone) Methods For Improving Object Rep ...
- zz深度学习目标检测2014至201901综述
论文学习-深度学习目标检测2014至201901综述-Deep Learning for Generic Object Detection A Survey 发表于 2019-02-14 | 更新 ...
- 深度学习 目标检测算法 SSD 论文简介
深度学习 目标检测算法 SSD 论文简介 一.论文简介: ECCV-2016 Paper:https://arxiv.org/pdf/1512.02325v5.pdf Slides:http://w ...
- (转)深度学习目标检测指标mAP
深度学习目标检测指标mAP https://github.com/rafaelpadilla/Object-Detection-Metrics 参考上面github链接中的readme,有详细描述
- 基于候选区域的深度学习目标检测算法R-CNN,Fast R-CNN,Faster R-CNN
参考文献 [1]Rich feature hierarchies for accurate object detection and semantic segmentation [2]Fast R-C ...
- 深度学习目标检测综述推荐之 Xiaogang Wang ISBA 2015
一.INTRODUCTION部分 (1)先根据时间轴讲了历史 (2)常见的基础模型 (3)讲了深度学习的优势 那就是feature learning,而不用人工划分的feature engineeri ...
- 深度学习目标检测:RCNN,Fast,Faster,YOLO,SSD比较
转载出处:http://blog.csdn.net/ikerpeng/article/details/54316814 知乎的图可以放大,更清晰,链接:https://www.zhihu.com/qu ...
- 深度学习与CV教程(12) | 目标检测 (两阶段,R-CNN系列)
作者:韩信子@ShowMeAI 教程地址:http://www.showmeai.tech/tutorials/37 本文地址:http://www.showmeai.tech/article-det ...
随机推荐
- 解题:CF1130E Wrong Answer
题面 巧妙构造题 这种题一定要限制一个条件,使得在这个条件下能推出要叉的代码的式子 令序列$a$的第一个元素为负,其余元素为正,且保证序列中至少有两个元素,那么Alice的代码将会从第二个元素开始计算 ...
- 【CF884D】Boxes And Balls k叉哈夫曼树
题目大意:给定一个大小为 N 的集合,每次可以从中挑出 2 个或 3 个数进行合并,合并的代价是几个数的权值和,求将这些数合并成 1 个的最小代价是多少. 引理:K 叉哈夫曼树需要保证 \((n-1) ...
- box-sizing border-box 的理解
http://blog.csdn.net/isaisai/article/details/20449827 -webkit-box-sizing: border-box; 则div 设置的宽高将包含 ...
- linux command ------ unlink 和 rm 的区别
unlink 不能用于删除文件夹,rm 可以删除文件和文件夹 当删除文件时,rm 和 unlink 是完全一样的.
- Flask-SQLAlchemy 无法创建Sqlite 数据库???
<Flask web 开发>第五章数据库照书中的方法无法创建表,没有python的命令提示符,只是运行程序输入db.create_all()后文件夹里也没有data.sqlite文件 解决 ...
- CSS 笔记(一)
学习了张鑫旭大神的浮动教程,记一下笔记. 浮动最开始是为了文字环绕图片效果. 浮动会破坏父元素的包裹. 清除浮动:在父元素加上clearfix(after不兼容ie6 7,zoom为ie6 7下方法) ...
- webpack插件去除没用到的css
去除没用到的css需要用到purifycss-webpack插件,而这个插件又依赖于purify-css 1.安装 npm i purifycss-webpack purify-css -D 2.加入 ...
- 样本标准差分母为何是n-1
sklearn实战-乳腺癌细胞数据挖掘 https://study.163.com/course/introduction.htm?courseId=1005269003&utm_campai ...
- log4j常见配置
依赖jar <dependency> <groupId>log4j</groupId> <artifactId>log4j</artifactId ...
- 蓝桥杯 带分数 DFS应用
问题描述 100 可以表示为带分数的形式:100 = 3 + 69258 / 714. 还可以表示为:100 = 82 + 3546 / 197. 注意特征:带分数中,数字1~9分别出现且只出现一次( ...