
深度学习目标检测:RCNN,Fast,Faster,YOLO,SSD比较
转载出处:http://blog.csdn.net/ikerpeng/article/details/54316814
知乎的图可以放大,更清晰,链接:https://www.zhihu.com/question/35887527/answer/140239982
这篇博文很简单,我就画了一个图,将各自的要点进行比较说明。
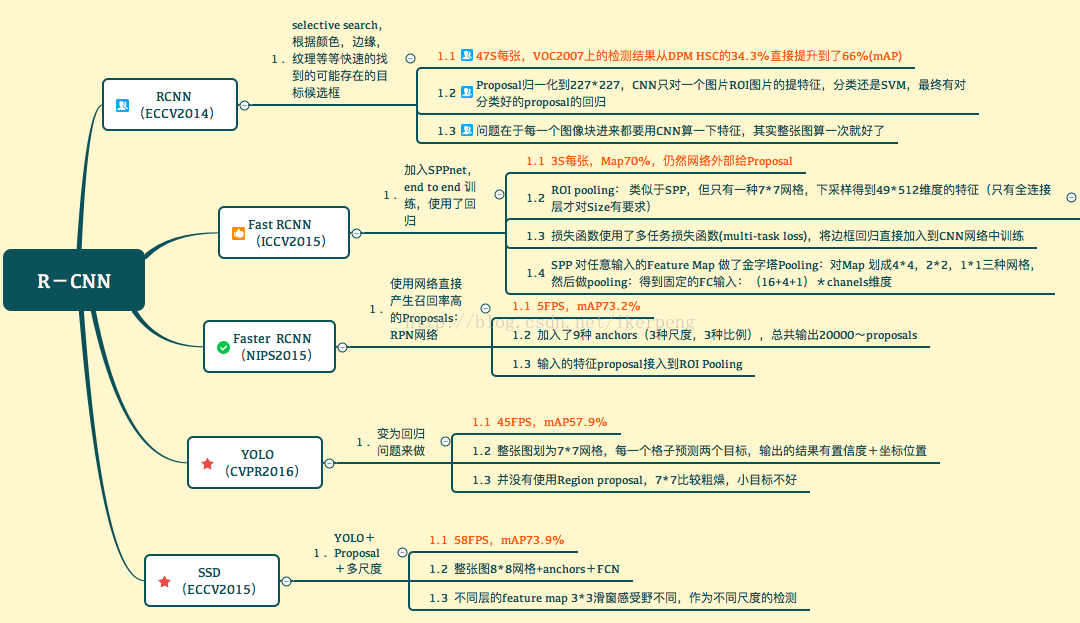
相信这样看过去就一目了然了,但是需要说明的还是: YOLO可能不应该放在这里,但是为了和SSD进行比较还是放了。另外,YOLO出了第二版本了,所以放在这边也没有问题。
个人觉得,分析比较Faster Yolo SSD这几种算法,有一个问题要先回答,Yolo SSD为什么快?
最主要的原因还是提proposal(最后输出将全连接换成全卷积也是一点)。其实总结起来我认为有两种方式:1.RPN,2. 暴力划分。RPN的设计相当于是一个sliding window 对最后的特征图每一个位置都进行了估计,由此找出anchor上面不同变换的proposal,设计非常经典,代价就是sliding window的代价。相比较 yolo比较暴力 ,直接划为7*7的网格,估计以网格为中心两个位置也就是总共98个”proposal“。快的很明显,精度和格子的大小有关。SSD则是结合:不同layer输出的输出的不同尺度的 Feature Map提出来,划格子,多种尺度的格子,在格子上提“anchor”。结果显而易见。
需要说明一个核心: 目前虽然已经有更多的RCNN,但是Faster RCNN当中的RPN仍然是一个经典的设计。下面来说一下RPN: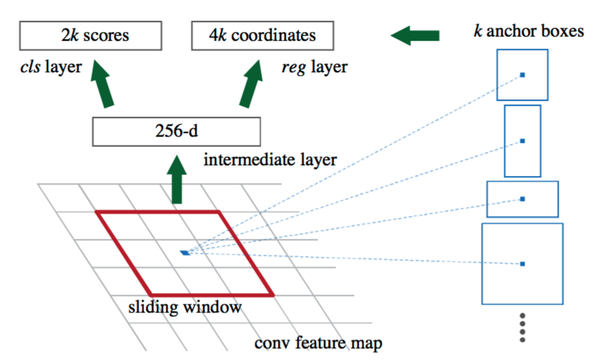
在Faster RCNN当中,一张大小为224*224的图片经过前面的5个卷积层,输出256张大小为13*13的 特征图(你也可以理解为一张13*13*256大小的特征图,256表示通道数)。接下来将其输入到RPN网络,输出可能存在目标的reign WHk个(其中WH是特征图的大小,k是anchor的个数)。
实际上,这个RPN由两部分构成:一个卷积层,一对全连接层分别输出分类结果(cls layer)以及 坐标回归结果(reg layer)。卷积层:stride为1,卷积核大小为3*3,输出256张特征图(这一层实际参数为3*3*256*256)。相当于一个sliding window 探索输入特征图的每一个3*3的区域位置。当这个13*13*256特征图输入到RPN网络以后,通过卷积层得到13*13个 256特征图。也就是169个256维的特征向量,每一个对应一个3*3的区域位置,每一个位置提供9个anchor。于是,对于每一个256维的特征,经过一对 全连接网络(也可以是1*1的卷积核的卷积网络),一个输出 前景还是背景的输出2D;另一个输出回归的坐标信息(x,y,w, h,4*9D,但实际上是一个处理过的坐标位置)。于是,在这9个位置附近求到了一个真实的候选位置。
深度学习目标检测:RCNN,Fast,Faster,YOLO,SSD比较的更多相关文章
- 论文学习-深度学习目标检测2014至201901综述-Deep Learning for Generic Object Detection A Survey
目录 写在前面 目标检测任务与挑战 目标检测方法汇总 基础子问题 基于DCNN的特征表示 主干网络(network backbone) Methods For Improving Object Rep ...
- 深度学习 目标检测算法 SSD 论文简介
深度学习 目标检测算法 SSD 论文简介 一.论文简介: ECCV-2016 Paper:https://arxiv.org/pdf/1512.02325v5.pdf Slides:http://w ...
- zz深度学习目标检测2014至201901综述
论文学习-深度学习目标检测2014至201901综述-Deep Learning for Generic Object Detection A Survey 发表于 2019-02-14 | 更新 ...
- (转)深度学习目标检测指标mAP
深度学习目标检测指标mAP https://github.com/rafaelpadilla/Object-Detection-Metrics 参考上面github链接中的readme,有详细描述
- 基于候选区域的深度学习目标检测算法R-CNN,Fast R-CNN,Faster R-CNN
参考文献 [1]Rich feature hierarchies for accurate object detection and semantic segmentation [2]Fast R-C ...
- 深度学习目标检测综述推荐之 Xiaogang Wang ISBA 2015
一.INTRODUCTION部分 (1)先根据时间轴讲了历史 (2)常见的基础模型 (3)讲了深度学习的优势 那就是feature learning,而不用人工划分的feature engineeri ...
- 深度学习论文笔记:Fast R-CNN
知识点 mAP:detection quality. Abstract 本文提出一种基于快速区域的卷积网络方法(快速R-CNN)用于对象检测. 快速R-CNN采用多项创新技术来提高训练和测试速度,同时 ...
- 深度剖析目标检测算法YOLOV4
深度剖析目标检测算法YOLOV4 目录 简述 yolo 的发展历程 介绍 yolov3 算法原理 介绍 yolov4 算法原理(相比于 yolov3,有哪些改进点) YOLOV4 源代码日志解读 yo ...
- 利用 ImageAI 在 COCO 上学习目标检测
ImageAI是一个python库,旨在使开发人员能够使用简单的几行代码构建具有包含深度学习和计算机视觉功能的应用程序和系统. 这个 AI Commons 项目https://commons.spec ...
随机推荐
- python并发编程之多线程2------------死锁与递归锁,信号量等
一.死锁现象与递归锁 进程也是有死锁的 所谓死锁: 是指两个或两个以上的进程或线程在执行过程中,因争夺资源而造成的一种互相等待的现象,若无外力作用, 它们都将无法推进下去.此时称系统处于死锁状态或系统 ...
- LeetCode(112):路径总和
Easy! 题目描述: 给定一个二叉树和一个目标和,判断该树中是否存在根节点到叶子节点的路径,这条路径上所有节点值相加等于目标和. 说明: 叶子节点是指没有子节点的节点. 示例: 给定如下二叉树,以及 ...
- javascript 自动填充功能
javascript 自动填充功能 javascript: (function(){ $("#zipcode").val("zip");$("#pho ...
- Jmeter卡住解决方案
windows环境下,修改jmeter.bat: set HEAP=-Xms256m -Xmx256m set NEW=-XX:NewSize=128m -XX:MaxNewSize=128m 改为: ...
- 繁简字转换(C#)
1.首先引入: using Microsoft.VisualBasic; 2.转换方法: //繁体转简体 public static string Traditional2Simplified(str ...
- 【C++ Primer | 07】泛型算法
定制操作 #include <iostream> #include <string> #include <vector> #include <algorith ...
- 【C#】wpf中的xmlns命名空间为什么是一个网址,代表了什么意思(转载)
原文:https://blog.csdn.net/catshitone/article/details/71213371 新建一个wpf的项目,我们先来看下它默认的命名空间都是哪些? 可以看到xmln ...
- [转] Nodejs 进阶:Express 常用中间件 body-parser 实现解析
写在前面 body-parser是非常常用的一个express中间件,作用是对post请求的请求体进行解析.使用非常简单,以下两行代码已经覆盖了大部分的使用场景. app.use(bodyParser ...
- Temporal Segment Networks
摘要 解决问题 用CNN框架有效提取video长时序特征 在UCF101等训练集受限的情况下训练网络 贡献 TSN网络,基于长时间时序结构模型.稀疏时序采样策略,视频层监督有效学习整个视频. HMDB ...
- 查询Linux系统中glibc的版本
编写一个简单的程序 #include <stdio.h> int main() { printf("Hello world\n"); ; } 编译 gcc test.c ...