
[Python机器学习]鸢尾花分类 机器学习应用
1、问题简述
- 花瓣的长度和宽度以及花萼的长度和宽度,所有测量结果的单位都是厘米。
2、测试代码
 #!/usr/bin/env python

 # -*- coding: utf-8 -*-

 # @File  : Iris.py

 # @Author: 赵路仓

 # @Date  : 2020/2/26

 # @Desc  :

 # @Contact : 398333404@qq.com

 import numpy as np

 import matplotlib.pyplot as plt

 import pandas as pd

 import mglearn

 import pandas as pd

 from sklearn.datasets import load_iris  # 鸢尾花(Iris)数据集,这是机器学习和统计学中一个经典的数据集

 from sklearn.model_selection import train_test_split

 iris_dataset = load_iris()  # load_iris 返回的 iris 对象是一个 Bunch 对象,与字典非常相似,里面包含键和值

 print("Key or iris_dataset:\n{}".format(iris_dataset.keys()))  # 打印

 print(iris_dataset['DESCR'][:193] + "\n...")  # DESCR 键对应的值是数据集的简要说明。target_names 键对应的值是一个字符串数组 里面包含我们要预测的花的品种

 print("Target names: {}".format(iris_dataset['target_names']))  # 三种花的名字类型

 print("Feature names: {}".format(iris_dataset['feature_names']))  # 三种花的特征,花瓣的长度 宽度 及 花萼的长度 宽度

 print("Type of data: {}".format(type(iris_dataset['data'])))  # data 数组的每一行对应一朵花,列代表每朵花的四个测量数据

 print("Shape of data: {}".format(iris_dataset['data'].shape))  # 数组中包含 150 朵不同的花的测量数据

 print("First five rows of data:\n{}".format(iris_dataset['data'][:5]))  # 前五朵花的数据

 print("Type of target: {}".format(type(iris_dataset['target'])))  # 是一个一维数组,每朵花对应其中的一个数据

 print("Shape of target: {}".format(iris_dataset['target'].shape))  #

 print("Target:\n{}".format(iris_dataset['target']))  # 品种转为0 1 2三个整数,代表三个种类

 X_train, X_test, Y_train, Y_test = train_test_split(iris_dataset['data'], iris_dataset['target'], random_state=0)

 print("X_train shape:{}".format(X_train.shape))

 print("Y_train shape:{}".format(Y_train.shape))

 print("X_test shape:{}".format(X_test.shape))

 print("Y_test shape:{}".format(Y_test.shape))

 # 利用X_train的数据创建DataFrame

 # 利用iris_dataset.feature_names的字符对数据进行标记

 iris_dataframe=pd.DataFrame(X_train,columns=iris_dataset.feature_names)  # 横坐标 以及横坐标名称

 # 利用DataFrame创建散点图矩阵,按y_trian着色

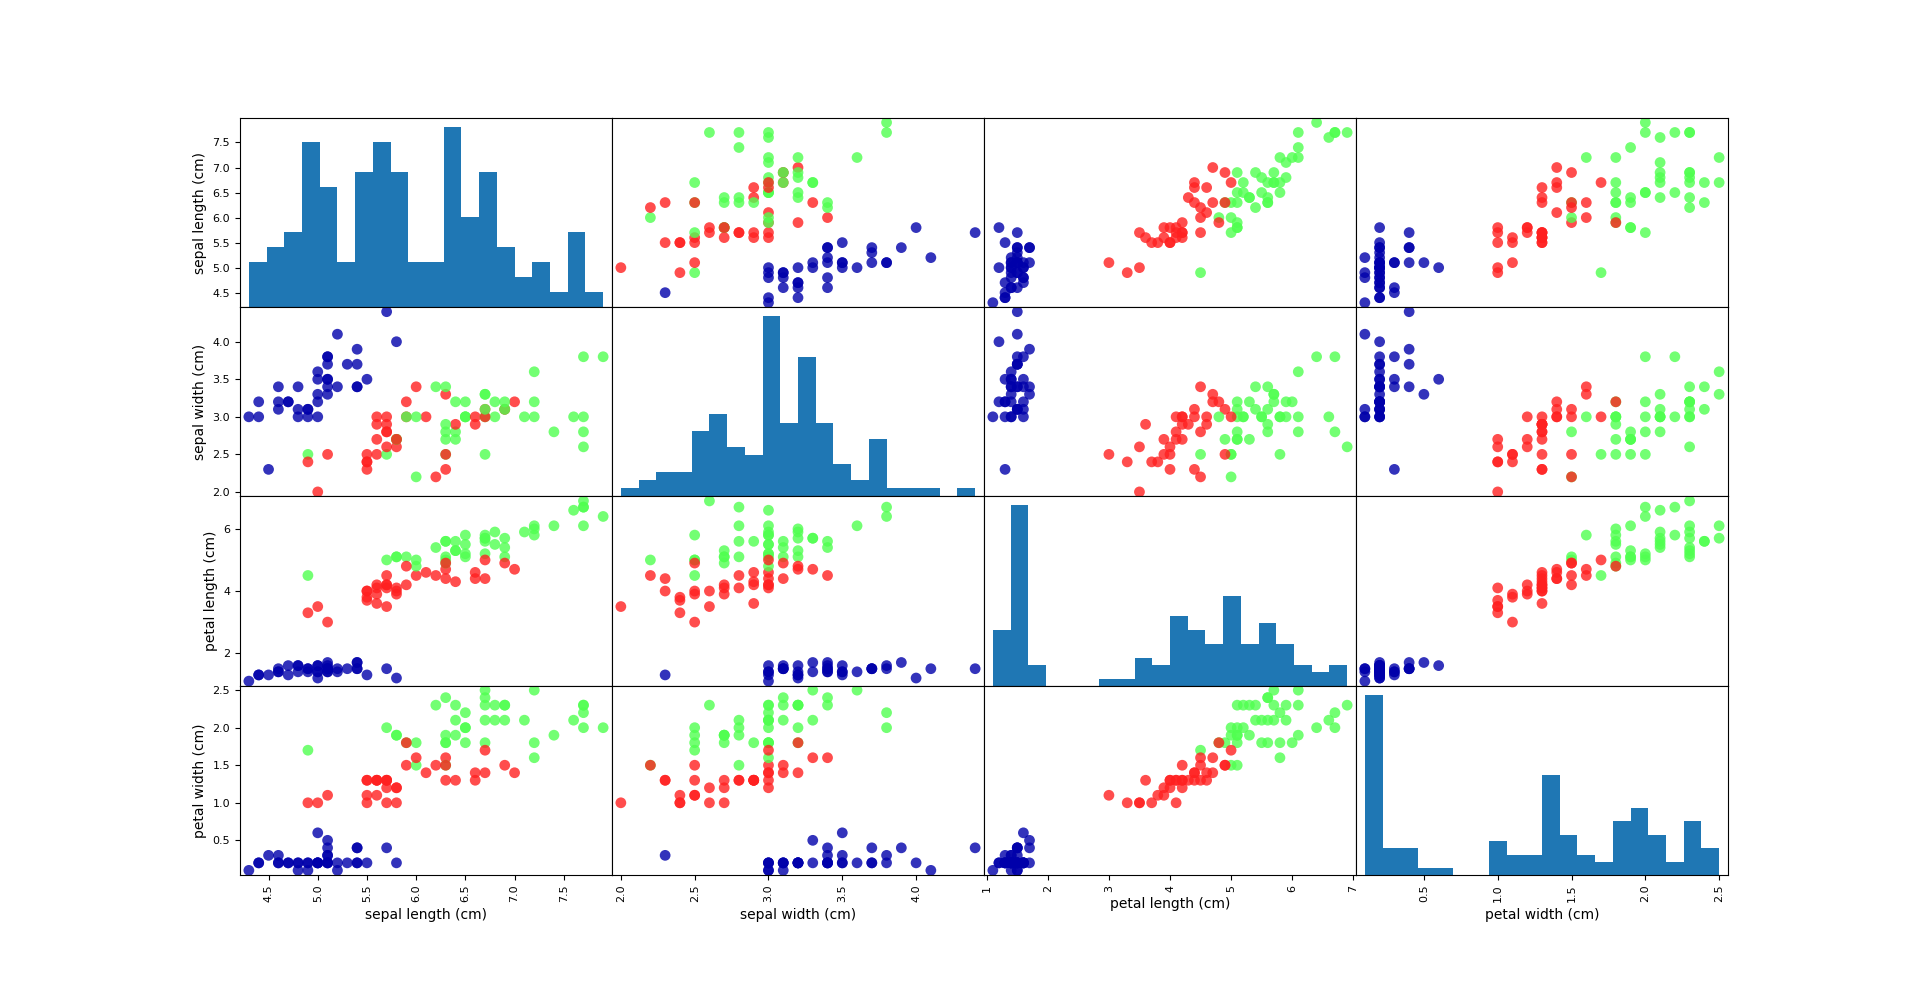
 grr=pd.plotting.scatter_matrix(iris_dataframe, c=Y_train, figsize=(15, 15), marker='o',hist_kwds={'bins': 20}, s=60, alpha=.8, cmap=mglearn.cm3)

 plt.show()
注:其中data数组的每一行代表一朵花,列代表每朵花的四个测量数据,一共150朵不同的花。而target是一个一维数组,每朵花代表其中的以个数据,用0、1、2三个整数代表三个不同的花品种。
3、衡量是否成功:训练数据和测试数据
首先,不能用构建模型的数据用于评估模型,因为模型是适配构建模型数据的,若用来测试匹配必定是100%。因此,要用新数据来测试模型。
X_train, X_test, Y_train, Y_test = train_test_split(iris_dataset['data'], iris_dataset['target'], random_state=0)

print("X_train shape:{}".format(X_train.shape))

print("Y_train shape:{}".format(Y_train.shape))

print("X_test shape:{}".format(X_test.shape))

print("Y_test shape:{}".format(Y_test.shape))
4、观察数据
 # 利用X_train的数据创建DataFrame

 # 利用iris_dataset.feature_names的字符对数据进行标记

 iris_dataframe=pd.DataFrame(X_train,columns=iris_dataset.feature_names)  # 横坐标 以及横坐标名称

 # 利用DataFrame创建散点图矩阵,按y_trian着色

 grr=pd.plotting.scatter_matrix(iris_dataframe, c=Y_train, figsize=(15, 15), marker='o',hist_kwds={'bins': 20}, s=60, alpha=.8, cmap=mglearn.cm3)

 plt.show()
数据显示结果:
[Python机器学习]鸢尾花分类 机器学习应用的更多相关文章
- [Python]基于K-Nearest Neighbors[K-NN]算法的鸢尾花分类问题解决方案
看了原理,总觉得需要用具体问题实现一下机器学习算法的模型,才算学习深刻.而写此博文的目的是,网上关于K-NN解决此问题的博文很多,但大都是调用Python高级库实现,尤其不利于初级学习者本人对模型的理 ...
- Python数据预处理:机器学习、人工智能通用技术(1)
Python数据预处理:机器学习.人工智能通用技术 白宁超 2018年12月24日17:28:26 摘要:大数据技术与我们日常生活越来越紧密,要做大数据,首要解决数据问题.原始数据存在大量不完整.不 ...
- 探索 Python、机器学习和 NLTK 库 开发一个应用程序,使用 Python、NLTK 和机器学习对 RSS 提要进行分类
挑战:使用机器学习对 RSS 提要进行分类 最近,我接到一项任务,要求为客户创建一个 RSS 提要分类子系统.目标是读取几十个甚至几百个 RSS 提要,将它们的许多文章自动分类到几十个预定义的主题领域 ...
- 小姐姐带你一起学:如何用Python实现7种机器学习算法(附代码)
小姐姐带你一起学:如何用Python实现7种机器学习算法(附代码) Python 被称为是最接近 AI 的语言.最近一位名叫Anna-Lena Popkes的小姐姐在GitHub上分享了自己如何使用P ...
- 什么是机器学习的分类算法?【K-近邻算法(KNN)、交叉验证、朴素贝叶斯算法、决策树、随机森林】
1.K-近邻算法(KNN) 1.1 定义 (KNN,K-NearestNeighbor) 如果一个样本在特征空间中的k个最相似(即特征空间中最邻近)的样本中的大多数属于某一个类别,则该样本也属于这个类 ...
- 搭建基于python +opencv+Beautifulsoup+Neurolab机器学习平台
搭建基于python +opencv+Beautifulsoup+Neurolab机器学习平台 By 子敬叔叔 最近在学习麦好的<机器学习实践指南案例应用解析第二版>,在安装学习环境的时候 ...
- Python实现鸢尾花数据集分类问题——基于skearn的NaiveBayes
Python实现鸢尾花数据集分类问题——基于skearn的NaiveBayes 代码如下: # !/usr/bin/env python # encoding: utf-8 __author__ = ...
- Python实现鸢尾花数据集分类问题——基于skearn的LogisticRegression
Python实现鸢尾花数据集分类问题——基于skearn的LogisticRegression 一. 逻辑回归 逻辑回归(Logistic Regression)是用于处理因变量为分类变量的回归问题, ...
- Python实现鸢尾花数据集分类问题——基于skearn的SVM
Python实现鸢尾花数据集分类问题——基于skearn的SVM 代码如下: # !/usr/bin/env python # encoding: utf-8 __author__ = 'Xiaoli ...
随机推荐
- 10、VLAN
VLAN综述:1.分段2.灵活性3.安全性 一个VLAN=一个广播域=逻辑网段(子网) VLAN运作:1.每个逻辑的VLAN就象一个独立的物理桥2.交换机上的每一个端口都可以分配给不同的VLAN3.默 ...
- (5千字)由浅入深讲解动态规划(JS版)-钢条切割,最大公共子序列,最短编辑距离
斐波拉契数列 首先我们来看看斐波拉契数列,这是一个大家都很熟悉的数列: // f = [1, 1, 2, 3, 5, 8] f(1) = 1; f(2) = 1; f(n) = f(n-1) + f( ...
- DOCKER 学习笔记7 Docker Machine 建立虚拟机实战,以及错误总结
前言 通过以上6小节的学习,已经可以使用DOCKER 熟练的部署应用程序了.大家都可以发现使用 DOCKER 带来的方便之处,因为现在的话,只是在一台服务器上部署,这样部署,我们只需要一条命令,需要的 ...
- 深度学习中的特征(feature)指的是什么?
一般在machine learning意义上,我们常说的feature,是一种对数据的表达.当然,要衡量一种feature是否是合适的表达,要根据数据,应用,ML的模型,方法....很多方面来看.一般 ...
- DaSiamRPN学习
9月14日,2018年视觉目标跟踪挑战赛(Visual-Object-Tracking Challenge 2018)的结果在ECCV Workshop上揭晓.VOT2018共设三项任务:Baseli ...
- CyclicBarrier与CountDownLatch区别
阻塞与唤醒方式的区别 CountDownLatch计数方式 CountDownLatch是减计数.调用await()后线程阻塞.调用countDown()方法后计数减一,当计数为零时,调用await( ...
- Spark RDD基本概念、宽窄依赖、转换行为操作
目录 RDD概述 RDD的内部代码 案例 小总结 转换.行动算子 宽.窄依赖 Reference 本文介绍一下rdd的基本属性概念.rdd的转换/行动操作.rdd的宽/窄依赖. RDD:Resilie ...
- javascript原生ajax请求
class Ajax{ constructor(url, method, data, callback_suc, callback_err, callback_run){ this.RT = true ...
- SAXParseException Content is not allowed in Prolog (前言中不允许有内容)
解析 XML 文件的时候,如 Mybatis 的 Mapper 文件,有时会出现 org.xml.sax.SAXParseException 前言中不允许有内容 的异常,英文就是 Content is ...
- 标准 I/O 和管道
1.标准输入和输出1>程序:指令+数据(指令服务于数据) 读入数据:input 输出数据:output 2>三种 I/O 设备 Linux 给程序提供三种 I/O 设备 标准输入(STDI ...