
[Python爬虫] 之四:Selenium 抓取微博数据
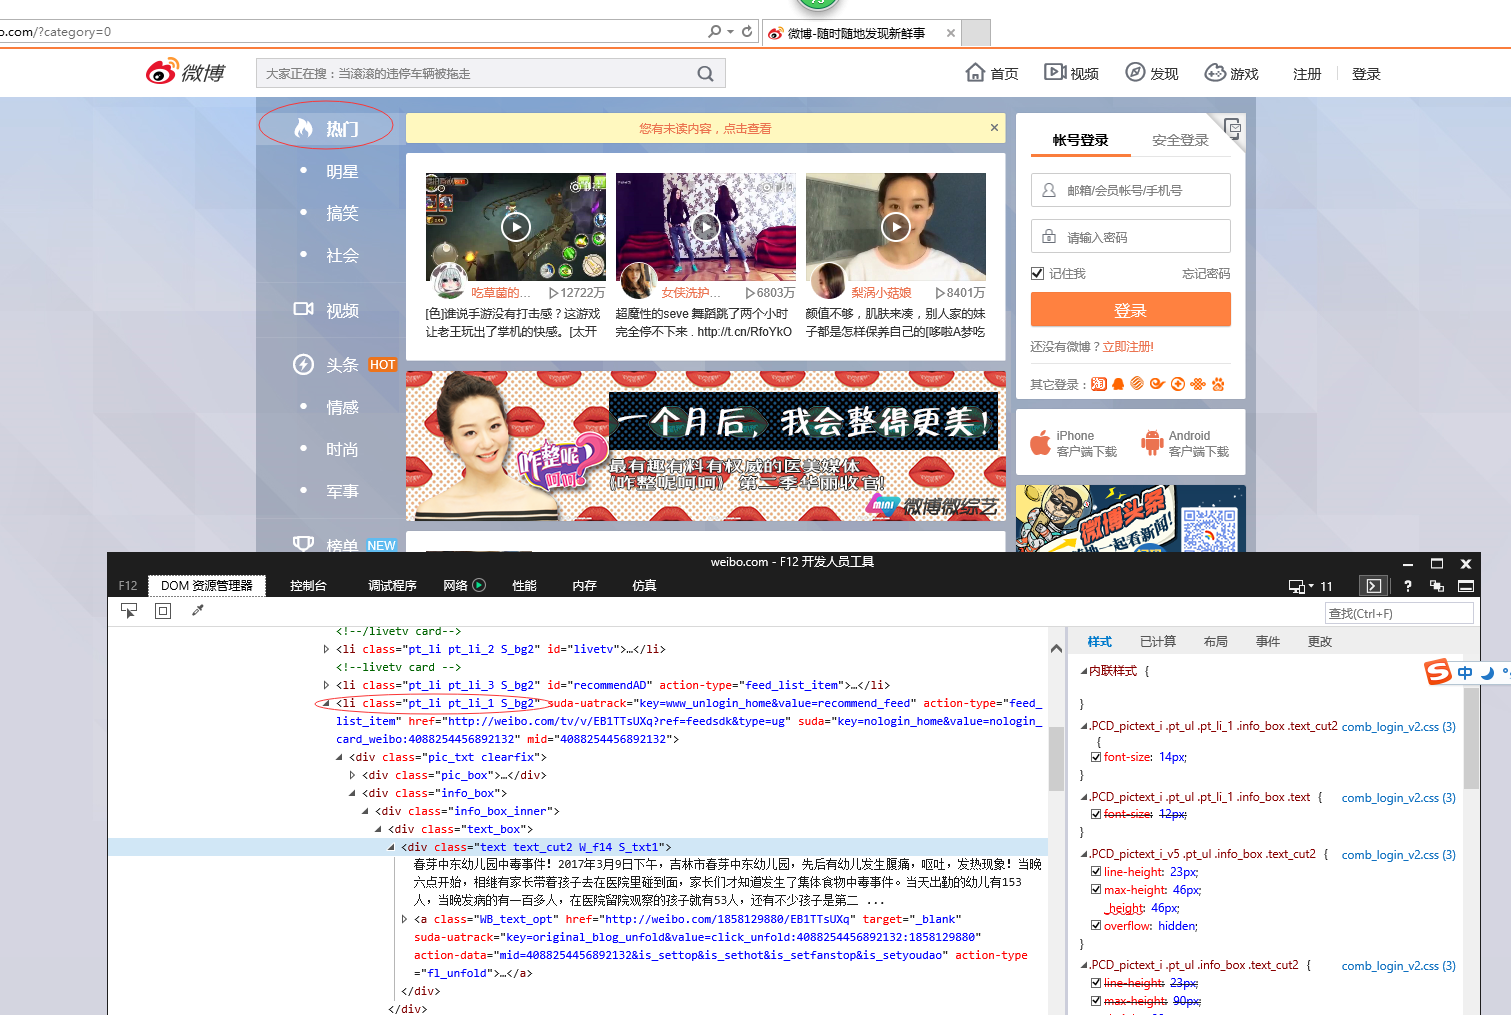
抓取代码:
# coding=utf-8
import os
import re
from selenium import webdriver
import selenium.webdriver.support.ui as ui
from selenium.webdriver.common.keys import Keys
import time
from selenium.webdriver.common.action_chains import ActionChains
import IniFile
class weibo:

    def __init__(self):
        #通过配置文件获取IEDriverServer.exe路径
        configfile = os.path.join(os.getcwd(),'config.conf')
        cf = IniFile.ConfigFile(configfile)
        IEDriverServer = cf.GetValue("section", "IEDriverServer")
        #每抓取一页数据延迟的时间,单位为秒,默认为5秒
        self.pageDelay = 5
        pageInteralDelay = cf.GetValue("section", "pageInteralDelay")
        if pageInteralDelay:
            self.pageDelay = int(pageInteralDelay)

        os.environ["webdriver.ie.driver"] = IEDriverServer
        self.driver = webdriver.Ie(IEDriverServer)

    def scroll_top(self):
        '''
        滚动条拉到顶部
        :return:
        '''
        if self.driver.name == "chrome":
            js = "var q=document.body.scrollTop=0"

        else:
            js = "var q=document.documentElement.scrollTop=0"
        return self.driver.execute_script(js)

    def scroll_foot(self):
        '''
        滚动条拉到底部
        :return:
        '''

        if self.driver.name == "chrome":
            js = "var q=document.body.scrollTop=10000"

        else:
            js = "var q=document.documentElement.scrollTop=10000"
        return self.driver.execute_script(js)

    def printTopic(self,topic):
        print '原始数据: %s' % topic
        print ' '
        author_time_nums_index = topic.rfind('@')
        ht = topic[:author_time_nums_index]
        ht = ht.replace('\n', '')
        print '话题:     %s' % ht

        author_time_nums = topic[author_time_nums_index:]
        author_time = author_time_nums.split('ñ')[0]
        nums = author_time_nums.split('ñ')[1]
        pattern1 = re.compile(r'\d{1,2}分钟前|今天\s{1}\d{2}:\d{2}|\d{1,2}月\d{1,2}日\s{1}\d{2}:\d{2}')
        time1 = re.findall(pattern1, author_time)

        print '话题作者: %s' % author_time.split(' ')[0]
        # print '时间:     %s' % author_time.split(' ')[1]
        print '时间:     %s' % time1[0]
        print '点赞量:   %s' % nums.split(' ')[0]
        print '评论量:   %s' % nums.split(' ')[1]
        print '转发量:   %s' % nums.split(' ')[2]
        print ' '

    def CatchData(self,listClass,firstUrl):
        '''
        抓取数据
        :param id: 要获取元素标签的ID
        :param firstUrl: 首页Url
        :return:
        '''
        start = time.clock()
        #加载首页
        wait = ui.WebDriverWait(self.driver, 20)
        self.driver.get(firstUrl)
        #打印标题
        print self.driver.title

        # # 聚焦元素
        # target = self.driver.find_element_by_id('J_ItemList')
        # self.driver.execute_script("arguments[0].scrollIntoView();", target)

        #滚动5次滚动条
        Scrollcount = 5
        while Scrollcount > 0:
            Scrollcount = Scrollcount -1
            self.scroll_foot() #滚动一次滚动条,定位查找一次
            total = 0
            for className in listClass:
                time.sleep(10)
                wait.until(lambda driver: self.driver.find_elements_by_xpath(className))
                Elements = self.driver.find_elements_by_xpath(className)
                for element in Elements:
                    print ' '
                    txt =  element.text.encode('utf8')
                    self.printTopic(txt)
                    total = total + 1

        self.driver.close()
        self.driver.quit()
        end = time.clock()

        print ' '
        print "共抓取了: %d 个话题" % total
        print "整个过程用时间: %f 秒" % (end - start)

# #测试抓取微博数据
obj = weibo()
#pt_li pt_li_2 S_bg2
#pt_li pt_li_1 S_bg2
# firstUrl = "http://weibo.com/?category=0"
firstUrl = "http://weibo.com/?category=1760"
listClass = []
listClass.append("//li[@class='pt_li pt_li_1 S_bg2']")
listClass.append("//li[@class='pt_li pt_li_2 S_bg2']")
obj.CatchData(listClass,firstUrl)
登录窗口
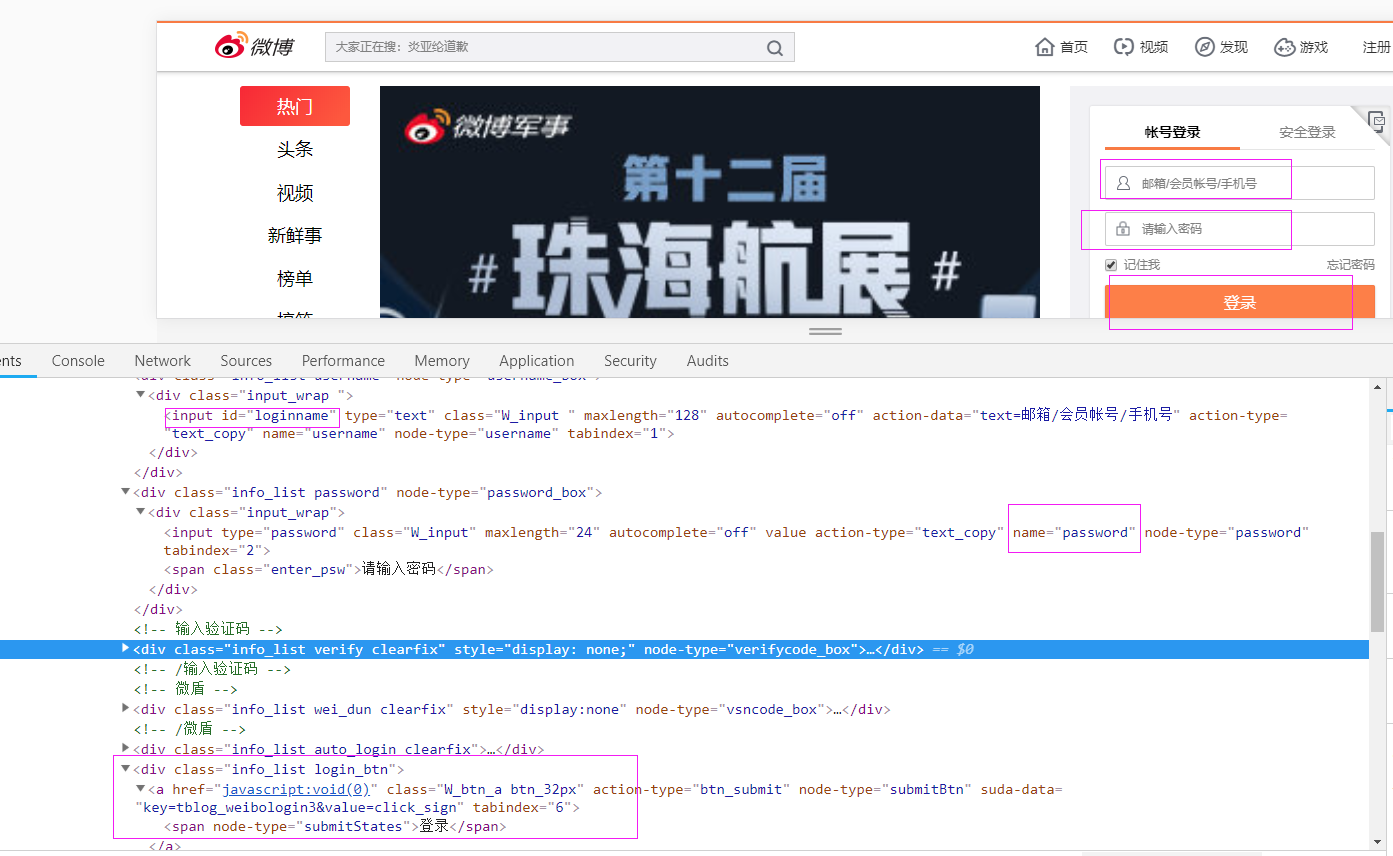
 def longon(self):

        flag = True

        try:

            self.driver.get('https://weibo.com/')

            self.driver.maximize_window()

            time.sleep(2)

            accname = self.driver.find_element_by_id("loginname")

            accname.send_keys('username')

            accpwd = self.driver.find_element_by_name("password")

            accpwd.send_keys('password')

            submit = self.driver.find_element_by_xpath("//div[@class='info_list login_btn']/a")

            submit.click()

            time.sleep(2)

        except Exception as e1:

            message = str(e1.args)

            flag = False

        return flag
[Python爬虫] 之四:Selenium 抓取微博数据的更多相关文章
- [Python爬虫] 之八:Selenium +phantomjs抓取微博数据
基本思路:在登录状态下,打开首页,利用高级搜索框输入需要查询的条件,点击搜索链接进行搜索.如果数据有多页,每页数据是20条件,读取页数 然后循环页数,对每页数据进行抓取数据. 在实践过程中发现一个问题 ...
- 用python+selenium抓取微博24小时热门话题的前15个并保存到txt中
抓取微博24小时热门话题的前15个,抓取的内容请保存至txt文件中,需要抓取排行.话题和阅读数 #coding=utf-8 from selenium import webdriver import ...
- 如何让Python爬虫一天抓取100万张网页
前言 文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者: 王平 源自:猿人学Python PS:如有需要Python学习资料的 ...
- 一个月入门Python爬虫,轻松爬取大规模数据
Python爬虫为什么受欢迎 如果你仔细观察,就不难发现,懂爬虫.学习爬虫的人越来越多,一方面,互联网可以获取的数据越来越多,另一方面,像 Python这样的编程语言提供越来越多的优秀工具,让爬虫变得 ...
- 芝麻HTTP:Python爬虫实战之抓取爱问知识人问题并保存至数据库
本次为大家带来的是抓取爱问知识人的问题并将问题和答案保存到数据库的方法,涉及的内容包括: Urllib的用法及异常处理 Beautiful Soup的简单应用 MySQLdb的基础用法 正则表达式的简 ...
- python爬虫——用selenium爬取京东商品信息
1.先附上效果图(我偷懒只爬了4页) 2.京东的网址https://www.jd.com/ 3.我这里是不加载图片,加快爬取速度,也可以用Headless无弹窗模式 options = webdri ...
- python爬虫 前程无忧网页抓取
Python爬虫视频教程零基础小白到scrapy爬虫高手-轻松入门 https://item.taobao.com/item.htm?spm=a1z38n.10677092.0.0.482434a6E ...
- Python爬虫:如何爬取分页数据?
上一篇文章<Python爬虫:爬取人人都是产品经理的数据>中说了爬取单页数据的方法,这篇文章详细解释如何爬取多页数据. 爬取对象: 有融网理财项目列表页[履约中]状态下的前10页数据,地址 ...
- Python爬虫之一 PySpider 抓取淘宝MM的个人信息和图片
ySpider 是一个非常方便并且功能强大的爬虫框架,支持多线程爬取.JS动态解析,提供了可操作界面.出错重试.定时爬取等等的功能,使用非常人性化. 本篇通过做一个PySpider 项目,来理解 Py ...
随机推荐
- (9) go 时间日期
1. var t = time.Now() println(t.String())//2019-04-26 13:38:02.5100554 +0800 CST m=+0.000000001 2. 月 ...
- powershell 获取 CPU 物理 / 逻辑核心数
转载请注明: 仰望高端玩家的小清新 http://www.cnblogs.com/luruiyuan/ 获取 CPU 逻辑核心数的方法为:总逻辑核心数 = 物理核心数 * 每核逻辑核心数 其中 ...
- Wannafly挑战赛7 B - codeJan与旅行
题目描述 codeJan 非常喜欢旅行.现在有 n 个城市排在一条线上,并且 codeJan 的位置不和任何一个城市的位置重叠.codeJan 想要游览 m 个城市,同时因为时间是不断变化的,游览一个 ...
- 洛谷P2471 [SCOI2007] 降雨量 [RMQ,模拟]
题目传送门 降雨量 题目背景 07四川省选 题目描述 我们常常会说这样的话:“X年是自Y年以来降雨量最多的”.它的含义是X年的降雨量不超过Y年,且对于任意Y<Z<X,Z年的降雨量严格小于X ...
- Good Bye 2017 部分题解
D. New Year and Arbitrary Arrangement 分析 \(dp[i][j]\) 表示已有 \(i\) 个 \(a\) 和 \(j\) 个 \(ab\) 的情况下继续构造能得 ...
- 通过JS实现HTML的转义与反转义
function HTMLEncode(html) { var temp = document.createElement("div"); (temp.textContent != ...
- 【51Nod 1363】最小公倍数之和
http://www.51nod.com/onlineJudge/questionCode.html#!problemId=1363 \[ \begin{aligned} &\sum_{i=1 ...
- [BZOJ4340][BJOI2015]隐身术(后缀数组)
考虑到K很小,于是可以暴搜每次用的是哪种操作,跳过AB相等的字符可以用SA求LCP加速. 主要流程就是,枚举B的每个后缀,对每个后缀统计合法前缀个数.DFS搜索每次决策,用SA跳过相同字符,当A或B匹 ...
- 【20181023T3】“新”的家园【虚图】
打死也不告诉你这个名字是我编的 题面 [错解] 哎最短路欸 哎floyd+dijkstra有30分 骗分骗分 [正解] 我们发现n和m(不是E)不是一个数量级的 也就是说,在做传统最短路的时候,很多时 ...
- Centos7 下mysql大小写敏感问题
在Centos7 下mysql大小写敏感问题,会导致程序运行时找不到对应的表. 解决办法: 第一步:编辑/etc/my.cnf文件,在[mysqld]节下 添加 lower_case_table_na ...