
爬虫之scrapy简介
Scrapy框架与原始爬虫的区别
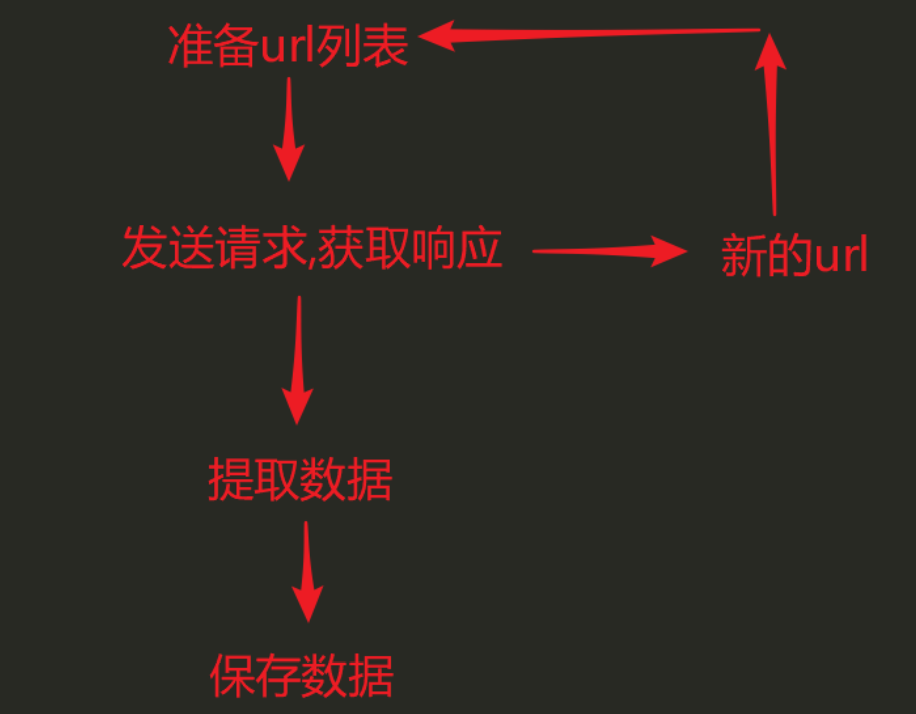
原始爬虫
效率低、同步、阻塞
Scrapy框架
效率高、异步、非阻塞

Scrapy的概念
- 爬虫框架
- 开发速度快
- 稳定性高
- 性能优越
scrapy的流程
- 爬虫模块(Spiders) --> 准备起始URL(Request) --> 爬虫中间件 --> 引擎 --> 调度器(Scheduler):请求去重, 缓存请求(队列)
- 调度器 --> 请求(Request) --> 引擎 --> 下载器中间件 --> 下载器:发送请求, 获取响应, 把响应封装为Response对象
- 下载器 -Response --> 下载器中间件 --> 引擎 --> 爬虫中间件 --> 爬虫模块:解析响应数据, 提取数据, 提取请求
- 爬虫模块 --> 数据 --> 引擎 --> 管道(Pipeline):保存数据
- 爬虫模块 --> 请求 --> 爬虫中间件 --> 引擎 --> 调度器
scrapy各个组件作用
- 引擎模块:调度各个模块, 以及模块间数据传递.
- 调度器模块:请求去重, 缓存请求(队列)
- 下载器: 发送请求, 获取响应数据
- 爬虫模块:解析响应数据, 提取数据, 提取请求
- 管道模块:处理数据, 比如:保存数据
- 下载器中间件: 在引擎和下载器之间, 把请求交给下载器之前, 可以对请求进行处理, 比如设置代理, 设置随机请求头.
- 爬虫中间件: 在引擎和爬虫之间, 可以请求和响应数据进行过滤.
ScrapyShell
使用格式:scrapy shell URL
作用
- 可以用于测试response常见属性和方法
- 可用于用于测试/调试XPATH
response中重要属性
- response.body:响应的二进制数据
- response.text: 响应的文本字符串数据
- response.url: 响应的URL
- response.request.headers: 响应对应的请求的请求头
settings.py中的设置信息
- ROBOTSTXT_OBEY 是否遵守robots协议,默认是遵守
- DOWNLOAD_DELAY 下载延迟,默认0.5~1.5的随机延迟
- COOKIES_ENABLED 是否开启cookie,即每次请求带上前一次的cookie,默认是开启的
- DEFAULT_REQUEST_HEADERS 设置默认请求头
- DOWNLOADER_MIDDLEWARES 下载中间件
- LOG_LEVEL 控制日志输出的级别
- 日志等级: DEBUG,INFO,WARNING,ERROR,CRITICAL
- LOG_FILE 设置log日志文件的保存路径, 如果设置该参数,终端将不再显示日志信息
回调函数之间数据的传递
yield scrapy.Requst(url,[callback,method,headers,body,cookies,meta,dont_filter])
- callback:表示当前的url的响应交给哪个函数去处理
- meta:实现数据在不同的解析函数中传递,设置代理IP
- meta={'xx':yy}:在callback函数中使用response.meta['xx']获取传递过来的yy的数据
- dont_filter:默认为False,会过滤请求的url地址,即请求过的url地址不会继续被请求,对需要重复请求的url地址可以把它设置为True
- method:指定POST或GET请求
- headers:接收一个字典,其中不包括cookies
- cookies:接收一个字典,专门放置cookies
- body:接收字符串格式:name=aa&age=bb
scrapy中间件
- 先书写middlewares文件内部的process_request方法
- 再在setting文件中打开配置信息
DOWNLOADER_MIDDLEWARES = {

   'middle.middlewares.MiddleDownloaderMiddleware': 543,

}
USER_AGENT_LIST = [

    '',

    '',

    '...',]

PROXY_LIST = [

    '14.106.27.137:8118',

    '27.193.49.150:8118',

    '12.86.54.194:8118',

    '115.218.132.203:8118',

    '182.96.203.11:49225',

    '114.249.112.65:9000',

    '43.248.122.251:8123',

]
Downloader Middlewares默认的方法
process_request(self, request, spider)
- 当每个request通过下载中间件时,该方法被调用。
- 返回None值:继续请求
- 返回Response对象:不再请求,把response返回给引擎
- 返回Request对象:把request对象交给引擎 -> 调度器进行后续的请求
process_response(self, request, response, spider)
- 当下载器完成http请求,传递响应给引擎的时候调用
- 返回Resposne:交给process_response来处理
- 返回Request对象:交给调取器继续请求
    def process_request(self, request, spider):

        # 处理请求的下载器中间件

        # Called for each request that goes through the downloader

        # 每当有一个request经过下载中间件的时候,那么此方法就会被调用

        # 随机获取一个user_agent

        # USER_AGENT_LIST/PROXY_LIST:setting中配置

        """

        随机User-Agent下载器中间件

            1.在settings.py中准备USER_AGENT_LIST列表

            2.实现 process_request`方法

            3.随机中USER_AGENT_LIST, 选出一个UserAgent设置给request

                request.headers['User-Agent']

        在settings.py中配置中间件

        """

        ua = random.choice(USER_AGENT_LIST)

        request.headers['User-Agent'] = ua

        """

        代理IP下载器中间件

            request.meta['proxy']

        """

        p = random.choice(PROXY_LIST)

        request.meta['proxy'] = p

        # return None 这个请求继续执行

        # return request 换了一个新的请求,把request对象交给引擎 -> 调度器进行后续的请求

        # return response 根本不会再发送请求,把response返回给引擎

        return None
爬虫之scrapy简介的更多相关文章
- 网络爬虫框架Scrapy简介
作者: 黄进(QQ:7149101) 一. 网络爬虫 网络爬虫(又被称为网页蜘蛛,网络机器人),是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本:它是一个自动提取网页的程序,它为搜索引擎从万维 ...
- Python爬虫框架Scrapy安装使用步骤
一.爬虫框架Scarpy简介Scrapy 是一个快速的高层次的屏幕抓取和网页爬虫框架,爬取网站,从网站页面得到结构化的数据,它有着广泛的用途,从数据挖掘到监测和自动测试,Scrapy完全用Python ...
- 97、爬虫框架scrapy
本篇导航: 介绍与安装 命令行工具 项目结构以及爬虫应用简介 Spiders 其它介绍 爬取亚马逊商品信息 一.介绍与安装 Scrapy一个开源和协作的框架,其最初是为了页面抓取 (更确切来说, ...
- 爬虫(scrapy第一篇)
---------------------------------------------------------------------------------------------------- ...
- 爬虫框架Scrapy 之(一) --- scrapy初识
Scrapy框架简介 scrapy是基于Twisted的一个第三方爬虫框架,许多功能已经被封装好,方便提取结构性的数据.其可以应用在数据挖掘,信息处理等方面.提供了许多的爬虫的基类,帮我们更简便使用爬 ...
- 爬虫框架 Scrapy
一 介绍 crapy一个开源和协作的框架,其最初是为了页面抓取 (更确切来说, 网络抓取 )所设计的,使用它可以以快速.简单.可扩展的方式从网站中提取所需的数据.但目前Scrapy的用途十分广泛,可用 ...
- Python 爬虫七 Scrapy
Scrapy Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架. 其可以应用在数据挖掘,信息处理或存储历史数据等一系列的程序中.其最初是为了页面抓取 (更确切来说, 网络抓取 )所设 ...
- 5、爬虫之scrapy框架
一 scrapy框架简介 1 介绍 Scrapy一个开源和协作的框架,其最初是为了页面抓取 (更确切来说, 网络抓取 )所设计的,使用它可以以快速.简单.可扩展的方式从网站中提取所需的数据.但目前Sc ...
- 05 爬虫之scrapy
一 scrapy框架简介 01 什么是scrapy: Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架,非常出名,非常强悍.所谓的框架就是一个已经被集成了各种功能(高性能异步下载,队 ...
随机推荐
- Nepxion Discovery【探索】微服务企业级解决方案
Nepxion Discovery[探索]微服务企业级解决方案] Nepxion Discovery[探索]使用指南,基于Spring Cloud Greenwich版.Finchley版和Hoxto ...
- 分库分表(3) ---SpringBoot + ShardingSphere 实现读写分离
分库分表(3)---ShardingSphere实现读写分离 有关ShardingSphere概念前面写了两篇博客: 1.分库分表(1) --- 理论 2. 分库分表(2) --- ShardingS ...
- win10下VSCode+CMake+Clang+GCC环境搭建
win10下VSCode+CMake+Clang+GCC环境搭建 win10下VSCode+CMake+Clang+GCC环境搭建 安装软件 VSCode插件安装 新建文件夹, 开始撸代码 main. ...
- [ASP.NET Core 3框架揭秘] 依赖注入:控制反转
ASP.NET Core框架建立在一些核心的基础框架之上,这些基础框架包括依赖注入.文件系统.配置选项和诊断日志等.这些框架不仅仅是支撑ASP.NET Core框架的基础,我们在进行应用开发的时候同样 ...
- python编程基础之二十三
集合:和数学里面完全一样的,不允许有重复元素,如果添加重复元素,就会被过滤,可以进行交并差的运算 集合是可变对象 本质:无需且无重复的数据结构 创建集合 s1 = set() 括号里面可以放可迭代 ...
- winsock完成端口套接字重用注意事项
刚申请到博客,第一篇随笔(๑•̀ㅂ•́)و✧ 关于DisconnectEx的一个问题,目前主要发现在windows10中出现了这个问题,winserver2008 win7都没有这个问题. 被Disc ...
- GDAL集成对KML文件的支持
目录 1. 正文 1.1. 编译LibKML 1.1.1. 第三方库支持 1.1.2. 编译错误 1.2. 配置GDAL 1.3. 链接问题 2. 参考 1. 正文 GDAL可以支持将KML作为矢量文 ...
- MySQL常用sql语句-----数据表的查询操作
常用的sql语句如下,应对工作足以 1.查询指定字段 select c_id,c_age,c_name from t_student; select c_id as 编号,c_name as 姓名,c ...
- python 之 pygame
学习pygame如果不了解pygame是什么的可以产考百度或者去官网去看介绍pygame急忙趁着三分的热度,整理一下关于pygame的相关内容,顺便复习一下Markdown编辑器 pygame的介绍 ...
- 玩转 RTC时钟库 DS1302
1.前言 最近博主在弄8266编程的时候,偶然发现两个全新时钟模块压仓货: DS1302 DS3231 为了避免资源浪费以及重复编写代码,博主还是抱着尝试的心态去寻找能够同时兼容 DS ...