
Python基于皮尔逊系数实现股票预测
 # -*- coding: utf-8 -*-

 """

 Created on Mon Dec  2 14:49:59 2018

 @author: zhen

 """

 import matplotlib.pyplot as plt

 import numpy as np

 import pandas as pd

 from datetime import datetime

 def normal(a):  #最大值最小值归一化

     return (a - np.min(a)) / (np.max(a) - np.min(a)+0.000001)

 def normalization(x): # np.std:计算矩阵的标准差(方差的算术平方根)

     return (x - np.mean(x)) / np.std(x)

 def corrcoef(a,b):

     corrc = np.corrcoef(a,b) # 计算皮尔逊相关系数,用于度量两个变量之间的相关性,其值介于-1到1之间

     corrc = corrc[0,1]

     return (16 * ((1 - corrc) / (1 + corrc)) ** 1) # ** 表示乘方

 startTimeStamp = datetime.now() # 获取当前时间

 # 加载数据

 filename = 'C:/Users/zhen/.spyder-py3/sh000300_2017.csv'

 # 获取第一,二列的数据

 all_date = pd.read_csv(filename,usecols=[0, 1, 3], dtype = 'str')

 all_date = np.array(all_date)

 data = all_date[:, 0]

 times = all_date[:, 1]

 data_points = pd.read_csv(filename,usecols=[3])

 data_points = np.array(data_points)

 data_points = data_points[:,0] #数据

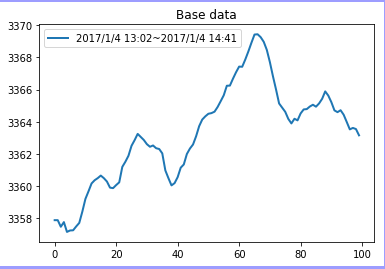
 topk = 10 #只显示top-10

 baselen = 100

 basebegin = 361

 basedata = data[basebegin]+' '+times[basebegin]+'~'+data[basebegin+baselen-1]+' '+times[basebegin+baselen-1]

 base = data_points[basebegin:basebegin+baselen]#一天的数据是240个点

 length = len(data_points) #数据长度

 # 分割片段

 subseries = []

 dateseries = []

 for j in range(0,length):

     if (j < (basebegin - baselen) or j > (basebegin + baselen - 1)) and j <length - baselen:

         subseries.append(data_points[j:j+baselen])

         dateseries.append(j) #开始位置

 # 片段搜索

 listdistance = []

 for i in range(0, len(subseries)):

     tt = np.array(subseries[i])

     distance = corrcoef(base, tt)

     listdistance.append(distance)

 # 排序

 index = np.argsort(listdistance,kind='quicksort') #排序,返回排序后的索引序列

 # 显示,要匹配的数据

 plt.figure(0)

 plt.plot((base),label = basedata, linewidth='')

 plt.legend(loc='upper left')

 plt.title('Base data')

 # 原始数据

 plt.figure(1)

 num = index[0]

 length = len(subseries[num])

 begin = data[dateseries[num]]+' '+times[dateseries[num]]

 end = data[dateseries[num]+length-1]+' '+times[dateseries[num]+length-1]

 label = begin+'~'+end

 plt.plot((subseries[num]), label=label, linewidth='')

 plt.legend(loc='upper left')

 plt.title('Similarity data')

 # 结果集对比

 plt.figure(2)

 plt.plot(normalization(base),label= basedata,linewidth='')

 length = len(subseries[num])

 begin = data[dateseries[num]] + ' ' + times[dateseries[num]]

 end = data[dateseries[num] + length - 1] + ' ' + times[dateseries[num] + length - 1]

 label = begin + '~' + end

 plt.plot(normalization(subseries[num]), label=label, linewidth='')

 plt.legend(loc='lower right')

 plt.title('normal similarity search')

 plt.show()

 endTimeStamp=datetime.now()

 print('run time', (endTimeStamp-startTimeStamp).seconds, "s")
结果:


Python基于皮尔逊系数实现股票预测的更多相关文章
- 从欧几里得距离、向量、皮尔逊系数到http://guessthecorrelation.com/
一.欧几里得距离就是向量的距离公式 二.皮尔逊相关系数反应的就是线性相关 游戏http://guessthecorrelation.com/ 的秘诀也就是判断一组点的拟合线的斜率y/x ------- ...
- 皮尔逊相似度计算的例子(R语言)
编译最近的协同过滤算法皮尔逊相似度计算.下顺便研究R简单使用的语言.概率统计知识. 一.概率论和统计学概念复习 1)期望值(Expected Value) 由于这里每一个数都是等概率的.所以就当做是数 ...
- Pearson(皮尔逊)相关系数及MATLAB实现
转自:http://blog.csdn.net/wsywl/article/details/5727327 由于使用的统计相关系数比较频繁,所以这里就利用几篇文章简单介绍一下这些系数. 相关系数:考察 ...
- pandas通过皮尔逊积矩线性相关系数(Pearson's r)计算数据相关性
皮尔逊积矩线性相关系数(Pearson's r)用于计算两组数组之间是否有线性关联,举个例子: a = pd.Series([1,2,3,4,5,6,7,8,9,10]) b = pd.Series( ...
- Pearson(皮尔逊)相关系数
Pearson(皮尔逊)相关系数:也叫pearson积差相关系数.衡量两个连续变量之间的线性相关程度. 当两个变量都是正态连续变量,而且两者之间呈线性关系时,表现这两个变量之间相关程度用积差相关系数, ...
- 皮尔逊(Pearson)系数矩阵——numpy
一.原理 注意 专有名词.(例如:极高相关) 二.代码 import numpy as np f = open('../file/Pearson.csv', encoding='utf-8') dat ...
- np.corrcoef()方法计算数据皮尔逊积矩相关系数(Pearson's r)
上一篇通过公式自己写了一个计算两组数据的皮尔逊积矩相关系数(Pearson's r)的方法,但np已经提供了一个用于计算皮尔逊积矩相关系数(Pearson's r)的方法 np.corrcoef() ...
- 皮尔逊残差 | Pearson residual
参考:Pearson Residuals 这些概念到底是写什么?怎么产生的? 统计学功力太弱了!
- Spark Mllib里的如何对两组数据用皮尔逊计算相关系数
不多说,直接上干货! import org.apache.spark.mllib.stat.Statistics 具体,见 Spark Mllib机器学习实战的第4章 Mllib基本数据类型和Mlli ...
随机推荐
- mysql 开发进阶篇系列 47 物理备份与恢复(xtrabackup 的完全备份恢复,恢复后重启失败总结)
一. 完全备份恢复说明 xtrabackup二进制文件有一个xtrabackup --copy-back选项,它将备份复制到服务器的datadir目录下.下面是通过 --target-dir 指定完全 ...
- MySQL表行数查询最佳实践
日常应用运维工作中,Dev或者db本身都需要统计表的行数,以此作为应用或者维护的一个信息参考.也许很多人会忽略select count(*) from table_name类似的sql对数据库性能的影 ...
- .Net程序员学用Oracle系列(19):导出、导入(备份、还原)
1.传统的导出/导入工具 1.1.EXP 命令详解 1.2.IMP 命令详解 1.3.EXP/IMP 使用技巧 2.新的导出/导入工具 2.1.EXPDP/IMPDP 参数说明 2.2.EXPDP/I ...
- Long类型时间如何转换成视频时长?
数据库中存放的视频时长是一个Long类型的毫秒/秒时间,现在需要把这个时间转换成标准的视频时长格式,在我看来这应该是一个很常用的转化有一个很常用的转换方法工具才对,可是我百度找了许久,没有一个简单直观 ...
- 菜鸟系列docker——docker镜像上(3)
1. 镜像image 镜像和容器的关系就和安装包和程序的关系一样,有了镜像才可以启动容器,容器是镜像的一个运行实例. 1.1 镜像的结构 通过第二节仓库,可能很多看官已经查看到镜像是分层的,接下来将对 ...
- Hibernate学习(八)———— Hibernate检索策略(类级别,关联级别,批量检索)详解
序言 很多看起来很难的东西其实并不难,关键是看自己是否花费了时间和精力去看,如果一个东西你能看得懂,同样的,别人也能看得懂,体现不出和别人的差距,所以当你觉得自己看了很多书或者学了很多东西的时候,你要 ...
- [EOJ629] 两开花
Description 给定一棵以 \(1\) 为根 \(n\) 个节点的树. 定义 \(f(k)\) :从树上等概率随机选出 \(k\) 个节点,这 \(k\) 个点的虚树大小的期望. 一个点 \( ...
- 从零开始学安全(二十一)●PHPSPL异常
- [日常] HTTP的媒体类型
HTTP的媒体类型 1.MIME类型的数据格式标签(MultIpurpose Internet Mail Extension) 2.最初用于电子邮件系统之间搬移,多用途互联网邮件扩展 3.MIME类型 ...
- java集合框架-List集合ArrayList和LinkedList详解
List 集合源码剖析 ✅ ArrayList 底层是基于数组,(数组在内存中分配连续的内存空间)是对数组的升级,长度是动态的. 数组默认长度是10,当添加数据超越当前数组长度时,就会进行扩容,扩容长 ...