
Pearson(皮尔逊)相关系数及MATLAB实现
转自:http://blog.csdn.net/wsywl/article/details/5727327
由于使用的统计相关系数比较频繁,所以这里就利用几篇文章简单介绍一下这些系数。
相关系数:考察两个事物(在数据里我们称之为变量)之间的相关程度。
如果有两个变量:X、Y,最终计算出的相关系数的含义可以有如下理解:
(1)、当相关系数为0时,X和Y两变量无关系。
(2)、当X的值增大(减小),Y值增大(减小),两个变量为正相关,相关系数在0.00与1.00之间。
(3)、当X的值增大(减小),Y值减小(增大),两个变量为负相关,相关系数在-1.00与0.00之间。
相关系数的绝对值越大,相关性越强,相关系数越接近于1或-1,相关度越强,相关系数越接近于0,相关度越弱。
通常情况下通过以下取值范围判断变量的相关强度:
相关系数 0.8-1.0 极强相关
0.6-0.8 强相关
0.4-0.6 中等程度相关
0.2-0.4 弱相关
0.0-0.2 极弱相关或无相关
Pearson(皮尔逊)相关系数
1、简介
皮尔逊相关也称为积差相关(或积矩相关)是英国统计学家皮尔逊于20世纪提出的一种计算直线相关的方法。
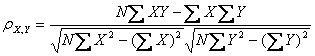
假设有两个变量X、Y,那么两变量间的皮尔逊相关系数可通过以下公式计算:
公式一:
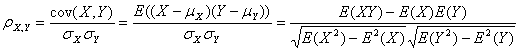
公式二:
公式三:
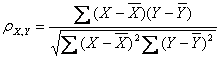
公式四:
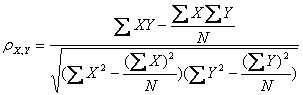
以上列出的四个公式等价,其中E是数学期望,cov表示协方差,N表示变量取值的个数。
2、适用范围
当两个变量的标准差都不为零时,相关系数才有定义,皮尔逊相关系数适用于:
(1)、两个变量之间是线性关系,都是连续数据。
(2)、两个变量的总体是正态分布,或接近正态的单峰分布。
(3)、两个变量的观测值是成对的,每对观测值之间相互独立。
3、Matlab实现
皮尔逊相关系数的Matlab实现(依据公式四实现):
- function coeff = myPearson(X , Y)
- % 本函数实现了皮尔逊相关系数的计算操作
- %
- % 输入:
- % X:输入的数值序列
- % Y:输入的数值序列
- %
- % 输出:
- % coeff:两个输入数值序列X,Y的相关系数
- %
- if length(X) ~= length(Y)
- error('两个数值数列的维数不相等');
- return;
- end
- fenzi = sum(X .* Y) - (sum(X) * sum(Y)) / length(X);
- fenmu = sqrt((sum(X .^2) - sum(X)^2 / length(X)) * (sum(Y .^2) - sum(Y)^2 / length(X)));
- coeff = fenzi / fenmu;
- end %函数myPearson结束
也可以使用Matlab中已有的函数计算皮尔逊相关系数:
- coeff = corr(X , Y);
4、参考内容
Pearson(皮尔逊)相关系数及MATLAB实现的更多相关文章
- Pearson(皮尔逊)相关系数
Pearson(皮尔逊)相关系数:也叫pearson积差相关系数.衡量两个连续变量之间的线性相关程度. 当两个变量都是正态连续变量,而且两者之间呈线性关系时,表现这两个变量之间相关程度用积差相关系数, ...
- np.corrcoef()方法计算数据皮尔逊积矩相关系数(Pearson's r)
上一篇通过公式自己写了一个计算两组数据的皮尔逊积矩相关系数(Pearson's r)的方法,但np已经提供了一个用于计算皮尔逊积矩相关系数(Pearson's r)的方法 np.corrcoef() ...
- pandas通过皮尔逊积矩线性相关系数(Pearson's r)计算数据相关性
皮尔逊积矩线性相关系数(Pearson's r)用于计算两组数组之间是否有线性关联,举个例子: a = pd.Series([1,2,3,4,5,6,7,8,9,10]) b = pd.Series( ...
- 皮尔逊(Pearson)系数矩阵——numpy
一.原理 注意 专有名词.(例如:极高相关) 二.代码 import numpy as np f = open('../file/Pearson.csv', encoding='utf-8') dat ...
- 皮尔逊相似度计算的例子(R语言)
编译最近的协同过滤算法皮尔逊相似度计算.下顺便研究R简单使用的语言.概率统计知识. 一.概率论和统计学概念复习 1)期望值(Expected Value) 由于这里每一个数都是等概率的.所以就当做是数 ...
- 皮尔逊残差 | Pearson residual
参考:Pearson Residuals 这些概念到底是写什么?怎么产生的? 统计学功力太弱了!
- Spark Mllib里的如何对两组数据用皮尔逊计算相关系数
不多说,直接上干货! import org.apache.spark.mllib.stat.Statistics 具体,见 Spark Mllib机器学习实战的第4章 Mllib基本数据类型和Mlli ...
- 从欧几里得距离、向量、皮尔逊系数到http://guessthecorrelation.com/
一.欧几里得距离就是向量的距离公式 二.皮尔逊相关系数反应的就是线性相关 游戏http://guessthecorrelation.com/ 的秘诀也就是判断一组点的拟合线的斜率y/x ------- ...
- Python基于皮尔逊系数实现股票预测
# -*- coding: utf-8 -*- """ Created on Mon Dec 2 14:49:59 2018 @author: zhen "&q ...
随机推荐
- ubuntu下apache2 安装 配置 卸载 CGI设置 SSL设置
一.安装.卸载apache2 apache2可直接用命令安装 sudo apt-get install apache2 卸载比较麻烦,必须卸干净,否则会影响ap ...
- struts请求源码的跟踪
最近工作任务不是很紧,时间也不能白白浪费,以前常用的struts2框架源码没去了解过,所以就跟踪一下struts2的整个执行过程.由于本人也是抱着学习的态度来阅读掩码,若文章在表述和代码方面如有不妥之 ...
- 聚合及UML表示
聚合聚合是一种特别类型的关联,用于描述“总体到局部”的关系. 聚合分成: 基本聚合与合成聚合 基本聚合: 基本聚合一般也简称为聚合(Aggregation).在基本的聚合关系中, 部分类(B) ...
- Flash Download Failed-"Cortex-M3"
rror:Flash Download Failed-"Cortex-M3"出现一般有两种情况: 1.SWD模式下,Debug菜单中,Reset菜单选项(Autodetect/HW ...
- linux 文件系统解析及相关命令
简介 文件系统就是分区或磁盘上的所有文件的逻辑集合. 文件系统不仅包含着文件中的数据而且还有文件系统的结构,所有Linux 用户和程序看到的文件.目录.软连接及文件保护信息等都存储在其中. 不同Lin ...
- Linux下Redis开机自启(Centos)
废话少说,直接来步骤: 1.设置redis.conf中daemonize为yes,确保守护进程开启. 2.编写开机自启动脚本 vi /etc/init.d/redis 脚本内容如下: # chkcon ...
- C++变量和函数
变量可根据作用域和类型分为 (动态)全局变量,静态全局变量,(动态)局部变量,静态局部变量 全局变量:定义在函数外,在源程序其他cpp文件中访问需要extern修饰 静态局部变量:生命周期相比局部变量 ...
- TeX Live安装配置等默认目录
TeX Live默认目录情况: TEXDIR (the main TeX directory): !! default location: /usr/local/texlive/2015 ...
- IBM云的商业动作之我见(1):IBM 收购 OpenStack 托管私有云公司 Blue Box [IBM Acquired Blue Box]
2015-06-10 IBM 刚刚(2015/06/03)宣布收购 Blue Box 公司.本文就聊聊这点事. 1. Blue Box 是做什么的?它是一家中小型托管私有云提供商. 1.1 公司的简单 ...
- Java之线程处理之二
No.1编写一个打印机类 写两个方法 public class Printer { public void print1() { System.out.print("微"); Sy ...