
Scrapy-redis<数据库篇>
scrapy-redis爬虫数据库连接部分——windows准备做salve,Linux准备做master开展工作
首先处理简单的windows熟悉的环境——安装Redis服务和Redis可视化~可视化也可以省略,但作为新手推荐使用:
1、安装redis服务:链接: https://pan.baidu.com/s/1EA0I-gx9NEU78vjZeZVqJA 提取码: 4s4i ——直接next下去
2、安装redis可视化:链接: https://pan.baidu.com/s/1KQh_g2o0tQijHQRFpKjcng 提取码: ny9c
安装redis可视化~:
1、确保redis安装完成,确保redis服务正常开启
2、正常打开界面:
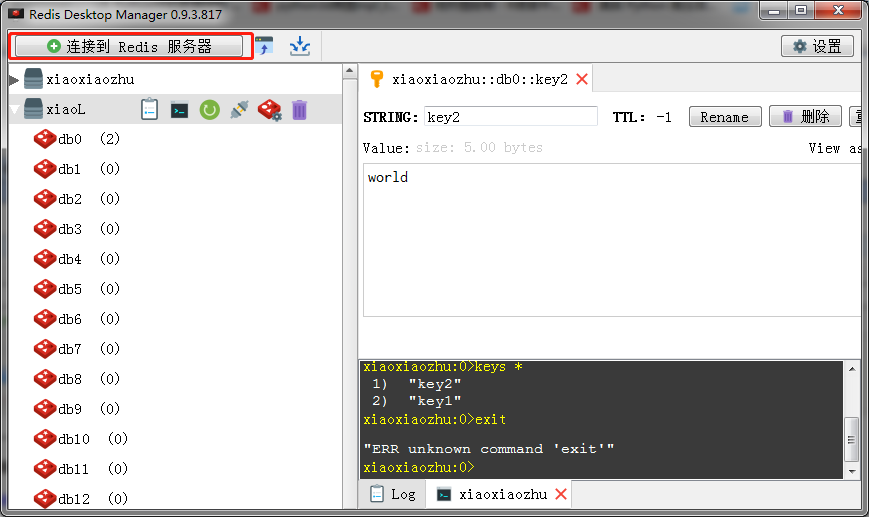

名字自定义~
验证为redis的密码~安装之后默认是空的就是这个——requirepass,直接连接,即可连接上windows本地的redis数据库
然后进行测试即可,测试详细内容百度。
不安装可视化的~就直接redis操作即可。
接下来是Linux服务里面安装redis:https://redis.io/download

安装完之后~直接进入redis-5.0.4文件夹:cd redis-5.0.4——>修改redis.conf文件:gedit redis.conf
修改三个属性:1.注释bind 127.0.0.1,以便其它ip访问,2.修改protected-mode yes,该改为no,3.设置密码 requirepass,默认是注释掉的,打开后设置密码。Over!
然后开始服务:sec/redis-server redis.conf
如果访问不了:
1、在linux下的防火墙中开放6379端口(与centos7以下版本开放端口的方式有区别):firewall-cmd --zone=public --add-port=6379/tcp --permanent
2、重启防火墙:systemctl restart firewalld
3、启动redis:src/redis-server redis.conf
此时开始测试:打开另一个黑窗口,进入redis文件夹,输入:src/redis-cli,回车,先输入keys *,出现: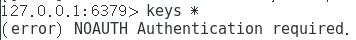 ,则输入你的密码即可:auth "密码";
这时候无错误情况下Linux下的Redis安装完成。
直接进入RedisDesktop里面连接服务,需要输入Linux的ip地址,Linux的ip地址查询:ifconfig -a ,windows的ip地址查询:ipconfig;
名字自取——ip地址输入——端口输入正确,无改变的情况下是6379——输入redis设置的密码;
结束windows下连接Linux下redis服务
Scrapy-redis<数据库篇>的更多相关文章
- 基于Python,scrapy,redis的分布式爬虫实现框架
原文 http://www.xgezhang.com/python_scrapy_redis_crawler.html 爬虫技术,无论是在学术领域,还是在工程领域,都扮演者非常重要的角色.相比于其他 ...
- Scrapy+redis实现分布式爬虫
概述 什么是分布式爬虫 需要搭建一个由n台电脑组成的机群,然后在每一台电脑中执行同一组程序,让其对同一网络资源进行联合且分布的数据爬取. 原生Scrapy无法实现分布式的原因 原生Scrapy中调度器 ...
- scrapy+redis去重实现增量抓取
class ProjectnameDownloaderMiddleware(object): # Not all methods need to be defined. If a method is ...
- 爬虫--scrapy+redis分布式爬取58同城北京全站租房数据
作业需求: 1.基于Spider或者CrawlSpider进行租房信息的爬取 2.本机搭建分布式环境对租房信息进行爬取 3.搭建多台机器的分布式环境,多台机器同时进行租房数据爬取 建议:用Pychar ...
- Redis与Scrapy
Redis与Scrapy Redis与Scrapy Redis is an open source, BSD licensed, advanced key-value cache and store. ...
- python - scrapy 爬虫框架 ( redis去重 )
1. 使用内置,并加以修改 ( 自定义 redis 存储的 keys ) settings 配置 # ############### scrapy redis连接 ################# ...
- Python分布式爬虫打造搜索引擎完整版-基于Scrapy、Redis、elasticsearch和django打造一个完整的搜索引擎网站
Python分布式爬虫打造搜索引擎 基于Scrapy.Redis.elasticsearch和django打造一个完整的搜索引擎网站 https://github.com/mtianyan/Artic ...
- scrapy简单分布式爬虫
经过一段时间的折腾,终于整明白scrapy分布式是怎么个搞法了,特记录一点心得. 虽然scrapy能做的事情很多,但是要做到大规模的分布式应用则捉襟见肘.有能人改变了scrapy的队列调度,将起始的网 ...
- 第三百六十五节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的基本查询
第三百六十五节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的基本查询 1.elasticsearch(搜索引擎)的查询 elasticsearch是功能 ...
- 四十四 Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)的基本查询
1.elasticsearch(搜索引擎)的查询 elasticsearch是功能非常强大的搜索引擎,使用它的目的就是为了快速的查询到需要的数据 查询分类: 基本查询:使用elasticsearch内 ...
随机推荐
- [ Java面试题 ]算法篇
1.堆和栈在内存中的区别是什么? 概念: 栈(stack)是为执行线程留出的内存空间.当函数被调用的时候,栈顶为局部变量和一些 bookkeeping 数据预留块.当函数执行完毕,块就没有用了,可能在 ...
- 如何深度复制一个javascript对象
前言 最近有人问我,如何将一个对象复制一份,因为他遇到了一个需求,需要将后端获取的数据,保存一份,原始数据会因为交互而发生变化,最终需要对比两份数据的异同. 他是一个刚入行的小朋友,他的实现方式就是新 ...
- js文件引用的问题顺带复习css引用
js文件包含在<script>块中用scr引用,css在link和@import来引用,css不是本篇的重点,直接引用一个博主的总结: “ 区别1:link是XHTML标签,除了加载CSS ...
- Android 框架练成 教你打造高效的图片加载框架
转载请标明出处:http://blog.csdn.net/lmj623565791/article/details/41874561,本文出自:[张鸿洋的博客] 1.概述 优秀的图片加载框架不要太多, ...
- Cookie防篡改机制
一.为什么Cookie需要防篡改 为什么要做Cookie防篡改,一个重要原因是 Cookie中存储有判断当前登陆用户会话信息(Session)的会话票据-SessionID和一些用户信息. 当发起一个 ...
- attr和prop的区别以及在企业开发中应该如何抉择
attr和prop有很多相同的地方,比如都可以操作标签的属性节点,而且获取的时候都只可以获取到相同节点的第一个,例如这样: $('span').attr('class');和$('span').pro ...
- string_array.go
package app import ( "strings" ) type StringArray []string func (a *StringArray) Set(s ...
- nsq理解
核心概念 在讨论NSQ如何在实践中使用前,先理解NSQ队列的架构原理是非常值得的.它的设计很简单,可以通过几个核心概念来理解. Topic --一个topic就是程序发布消息的一个逻辑键,当程序第一次 ...
- bzoj 2500 幸福的道路 树上直径+set
首先明确:树上任意一点的最长路径一定是直径的某一端点. 所以先找出直径,求出最长路径,然后再求波动值<=m的最长区间 #include<cstdio> #include<cst ...
- Spring事务(一) Markdown 版
事务 事务的特性(ACID) 原子性(Atomicity) 原子性要求事务所包含的全部操作是一个不可分割的整体,这些操作要么全部提交成功,要么只要其中一个操作失败,就全部"成仁" ...