
深入理解HashMap上篇
前言: HashMap是Java程序员使用频率最高的用于映射(键值对)处理的数据类型。随着JDK(Java Developmet Kit)版本的更新,JDK1.8对HashMap底层的实现进行了优化,例如引入红黑树的数据结构和扩容的优化等。最近刚好有时间,刚好把HashMap相关的内容和之前做唯品会网关的一些经验整理一下。
一.HashMap的概述
1.1 HashMap的数据结构
HashMap的内存结构和原理,以及线程安全都是面试的热点问题。Java中的数据结构基本可以用数组+链表的解决。
- 数组的优缺点:通过下标索引方便查找,但是在数组中插入或删除一个元素比较困难。
- 链表的优缺点:由于在链表中查找一个元素需要以遍历链表的方式去查找,而插入,删除快速。因此链表适合
快速插入和删除的场景,不利于查找。
而HashMap就是综合了上述的两种数据结构的优点,HashMap由Entry数组+链表组成,如下图所示:
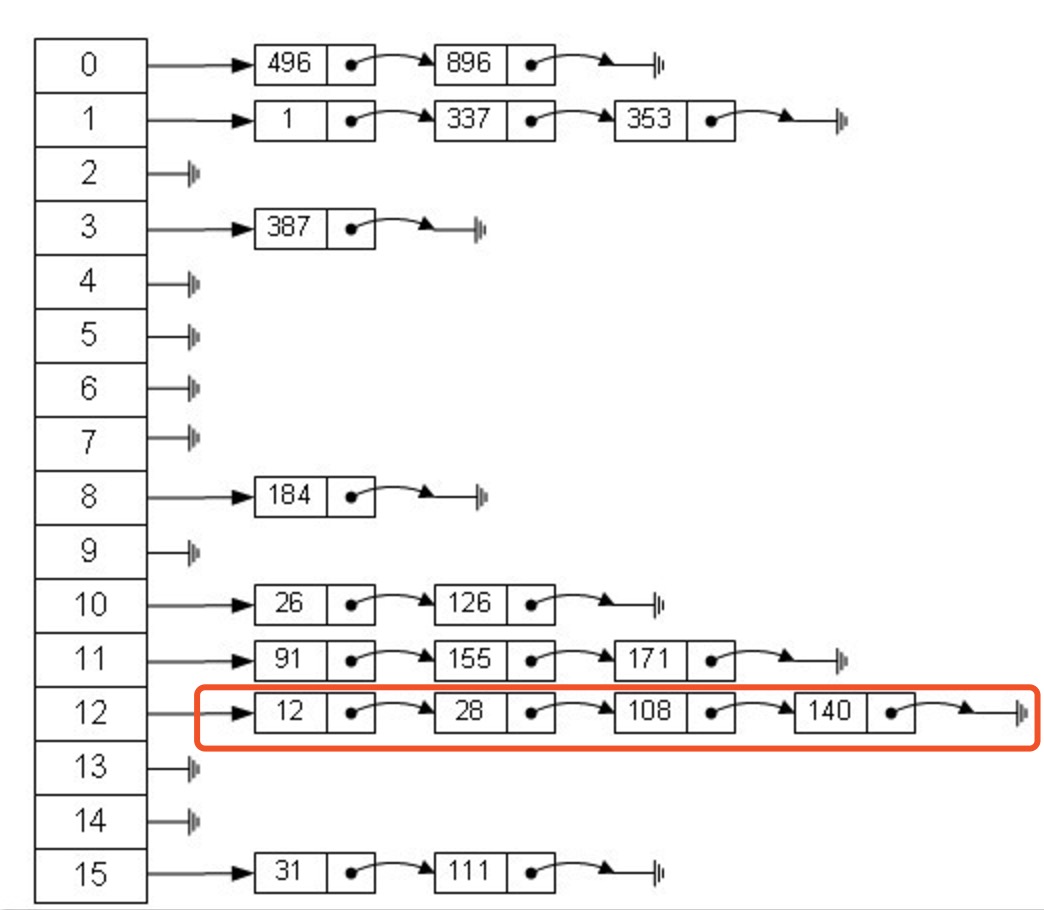
从上图我们可以发现HashMap是由Entry数组+链表组成的,一个长度为16的数组中,每个元素存储的是一个链表的头结点。那么这些元素是按照什么样的规则存储到数组中呢。一般情况是通过hash(key)%len获得,也就是元素的key的哈希值对数组长度取模得到。比如上述哈希表中,12%16=12,28%16=12,108%16=12,140%16=12。所以12、28、108以及140都存储在数组下标为12的位置。
1.2 HashMap的存取实现简单说明
1.2.1 HashMap put方法实现
1.首先HashMap里面实现一个静态内部类Entry,其重要的属性有 key , value, next,从属性key,value我们就能很明显的看出来Entry就是HashMap键值对实现的一个基础bean,我们上面说到HashMap的基础就是一个线性数组,这个数组就是Entry[],Map里面的内容都保存在Entry[]里面。
static class Entry<K,V> implements Map.Entry<K,V> {

      final K key;//Key-value结构的key

      V value;//存储值

      Entry<K,V> next;//指向下一个链表节点

      final int hash;//哈希值

}
2.既然是线性数组,为什么能随机存取?这里HashMap用了一个小算法,大致是这样实现:
//存储时:

// 这个hashCode方法这里不详述,只要理解每个key的hash是一个固定的int值

int hash = key.hashCode();

int index = hash % Entry[].length;

Entry[index] = value;

//取值时:

int hash = key.hashCode();

int index = hash % Entry[].length;

return Entry[index];
到这里我们轻松的理解了HashMap通过键值对实现存取的基本原理
3.疑问:如果两个key通过hash%Entry[].length得到的index相同,会不会有覆盖的危险?
这里HashMap里面用到链式数据结构的一个概念。上面我们提到过Entry类里面有一个next属性,作用是指向下一个Entry。打个比方, 第一个键值对A进来,通过计算其key的hash得到的index=0,记做:Entry[0] = A。一会后又进来一个键值对B,通过计算其index也等于0,现在怎么办?HashMap会这样做:B.next = A,Entry[0] = B,如果又进来C,index也等于0,那么C.next = B,Entry[0] = C;这样我们发现index=0的地方其实存取了A,B,C三个键值对,他们通过next这个属性链接在一起。所以疑问不用担心。也就是说数组中存储的是最后插入的元素。到这里为止,HashMap的大致实现,我们应该已经清楚了。
当然HashMap里面也包含一些优化方面的实现,这里也说一下。比如:Entry[]的长度一定后,随着map里面数据的越来越长,这样同一个index的链就会很长,会不会影响性能?HashMap里面设置一个因素(也称为因子),随着map的size越来越大,Entry[]会以一定的规则加长长度。
二.HashMap非线程安全
2.1 HashMap进行Put操作
2.1.1 Jdk8以下HashMap的Put操作
put操作主要是判空,对key的hashcode执行一次HashMap自己的哈希函数,得到bucketindex位置,还有对重复key的覆盖操作。
在HashMap做put操作的时候会调用到以下的方法,addEntry和createEntry
public V put(K key, V value) {

        if (key == null)

            return putForNullKey(value);

        //得到key的hashcode,同时再做一次hash操作

        int hash = hash(key.hashCode());

        //对数组长度取余,决定下标位置

        int i = indexFor(hash, table.length);

        /**

          * 首先找到数组下标处的链表结点,

          * 判断key对一个的hash值是否已经存在,如果存在将其替换为新的value

          */

        for (Entry<K,V> e = table[i]; e != null; e = e.next) {

            Object k;

            //Hash碰撞的解决

            if (e.hash == hash && ((k = e.key) == key || key.equals(k))) {

                V oldValue = e.value;

                e.value = value;

                e.recordAccess(this);

                return oldValue;

            }

        }

        modCount++;

        addEntry(hash, key, value, i);

        return null;

    }
涉及到的几个方法:
static int hash(int h) {

        h ^= (h >>> 20) ^ (h >>> 12);

        return h ^ (h >>> 7) ^ (h >>> 4);

    }

static int indexFor(int h, int length) {

        return h & (length-1);

    }
现在假如A线程和B线程同时进入addEntry,然后计算出了相同的哈希值对应了相同的数组位置,因为此时该位置还没数据,然后对同一个数组位置调用createEntry,两个线程会同时得到现在的头结点,然后A写入新的头结点之后,B也写入新的头结点,那B的写入操作就会覆盖A的写入操作造成A的写入操作丢失。
2.1.2 jdk8中HashMap的Put操作
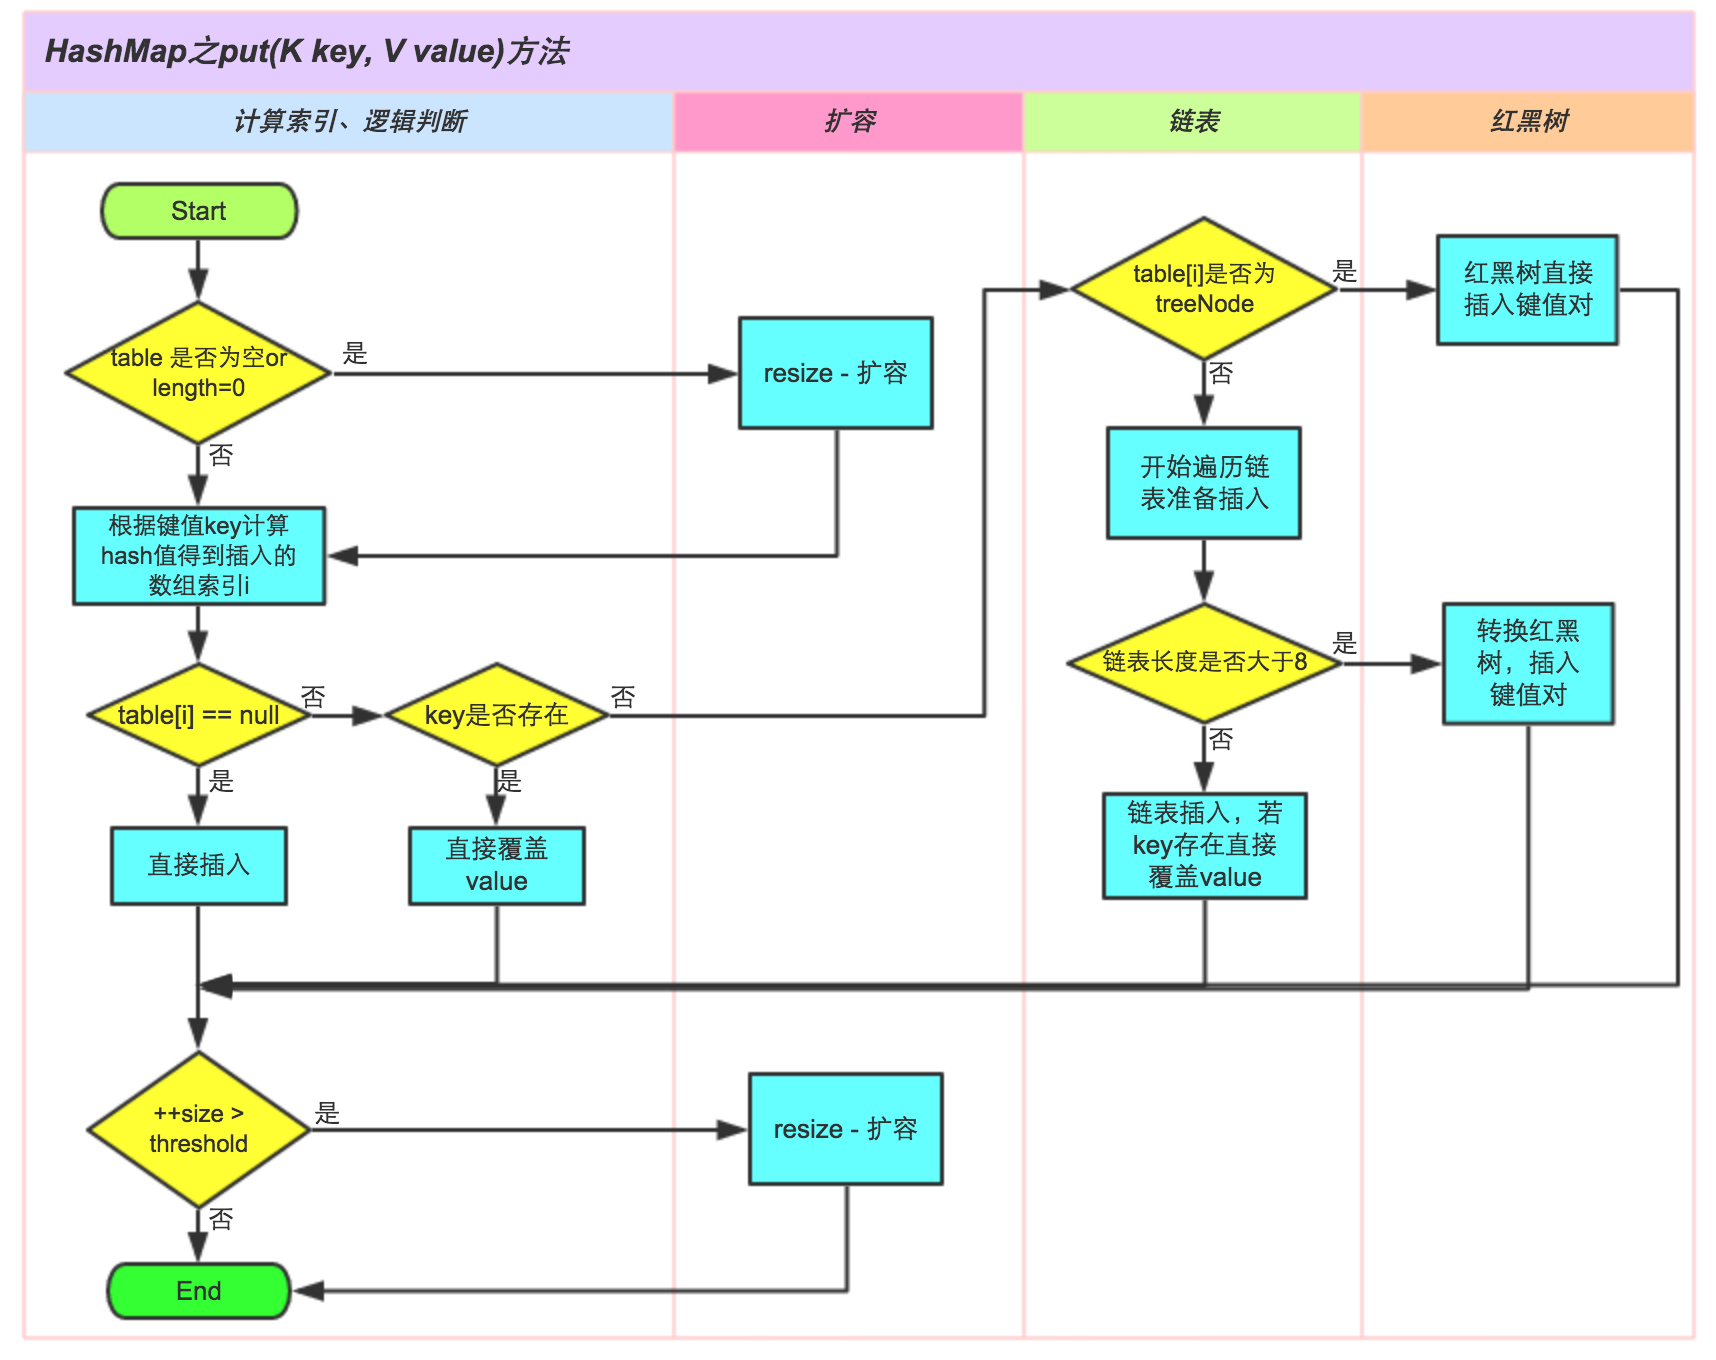
①.判断键值对数组table[i]是否为空或为null,否则执行resize()进行扩容;
②.根据键值key计算hash值得到插入的数组索引i,如果table[i]==null,直接新建节点添加,转向⑥,如果table[i]不为空,转向③;
③.判断table[i]的首个元素是否和key一样,如果相同直接覆盖value,否则转向④,这里的相同指的是hashCode以及equals;
④.判断table[i] 是否为treeNode,即table[i] 是否是红黑树,如果是红黑树,则直接在树中插入键值对,否则转向⑤;
⑤.遍历table[i],判断链表长度是否大于8,大于8的话把链表转换为红黑树,在红黑树中执行插入操作,否则进行链表的插入操作;遍历过程中若发现key已经存在直接覆盖value即可;
⑥.插入成功后,判断实际存在的键值对数量size是否超多了最大容量threshold,如果超过,进行扩容。
JDK1.8HashMap的put方法源码如下:
   public V put(K key, V value) {

      // 对key的hashCode()做hash

      return putVal(hash(key), key, value, false, true);

  }

  final V putVal(int hash, K key, V value, boolean onlyIfAbsent,

                 boolean evict) {

     Node<K,V>[] tab; Node<K,V> p; int n, i;

      // 步骤①:tab为空则创建

     if ((tab = table) == null || (n = tab.length) == 0)

         n = (tab = resize()).length;

     // 步骤②:计算index,并对null做处理

     if ((p = tab[i = (n - 1) & hash]) == null)

         tab[i] = newNode(hash, key, value, null);

     else {

         Node<K,V> e; K k;

         // 步骤③:节点key存在,直接覆盖value

         if (p.hash == hash &&

             ((k = p.key) == key || (key != null && key.equals(k))))

             e = p;

         // 步骤④:判断该链为红黑树

         else if (p instanceof TreeNode)

             e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value);

         // 步骤⑤:该链为链表

         else {

             for (int binCount = 0; ; ++binCount) {

                 if ((e = p.next) == null) {

                     p.next = newNode(hash, key,value,null);

                        //链表长度大于8转换为红黑树进行处理

                     if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st

                         treeifyBin(tab, hash);

                     break;

                 }

                    // key已经存在直接覆盖value

                 if (e.hash == hash &&

                     ((k = e.key) == key || (key != null && key.equals(k))))

                            break;

                 p = e;

             }

         }

         if (e != null) { // existing mapping for key

             V oldValue = e.value;

             if (!onlyIfAbsent || oldValue == null)

                 e.value = value;

             afterNodeAccess(e);

             return oldValue;

         }

     }

     ++modCount;

     // 步骤⑥:超过最大容量 就扩容

     if (++size > threshold)

         resize();

     afterNodeInsertion(evict);

     return null;

}
2.2 HashMap进行Get操作
public V get(Object key) {

        if (key == null)

            return getForNullKey();

        int hash = hash(key.hashCode());

        /**

          * 先定位到数组元素,再遍历该元素处的链表

          * 判断的条件是key的hash值相同,并且链表的存储的key值和传入的key值相同

          */

        for (Entry<K,V> e = table[indexFor(hash, table.length)];e != null;e = e.next) {

            Object k;

            if (e.hash == hash && ((k = e.key) == key || key.equals(k)))

                return e.value;

        }

        return null;
看一下链表的结点数据结构,保存了四个字段,包括key,value,key对应的hash值以及链表的下一个节点:
static class Entry<K,V> implements Map.Entry<K,V> {

      final K key;//Key-value结构的key

      V value;//存储值

      Entry<K,V> next;//指向下一个链表节点

      final int hash;//哈希值

}
2.3 HashMap扩容的时候
扩容(resize)就是重新计算容量,向HashMap对象里不停的添加元素,而HashMap对象内部的数组无法装载更多的元素时,对象就需要扩大数组的长度,以便能装入更多的元素。当然Java里的数组是无法自动扩容的,方法是使用一个新的数组代替已有的容量小的数组,就像我们用一个小桶装水,如果想装更多的水,就得换大水桶。
还是上面那个addEntry方法中,有个扩容的操作,这个操作会新生成一个新的容量的数组,然后对原数组的所有键值对重新进行计算和写入新的数组,之后指向新生成的数组。来看一下扩容的源码:
//用新的容量来给table扩容

void resize(int newCapacity) {

    Entry[] oldTable = table; //引用扩容前的Entry数组

    int oldCapacity = oldTable.length; //保存old capacity

    // 如果旧的容量已经是系统默认最大容量了(扩容前的数组大小如果已经达到最大(2^30)了 ),那么将阈值设置成整形的最大值,退出 ,

    if (oldCapacity == MAXIMUM_CAPACITY) {

        threshold = Integer.MAX_VALUE;

        return;

    }

    //初始化一个新的Entry数组

    Entry[] newTable = new Entry[newCapacity];

    //将数据转移到新的Entry数组里

    transfer(newTable, initHashSeedAsNeeded(newCapacity));

    //HashMap的table属性引用新的Entry数组

    table = newTable;

    //设置阈值

    threshold = (int)Math.min(newCapacity * loadFactor, MAXIMUM_CAPACITY + 1);

}
这里就是使用一个容量更大的数组来代替已有的容量小的数组,transfer()方法将原有Entry数组的元素拷贝到新的Entry数组里。
那么问题来了,当多个线程同时进来,检测到总数量超过门限值的时候就会同时调用resize操作,各自生成新的数组并rehash后赋给该map底层的数组table,结果最终只有最后一个线程生成的新数组被赋给table变量,其他线程的均会丢失。而且当某些线程已经完成赋值而其他线程刚开始的时候,就会用已经被赋值的table作为原始数组,这样也会有问题。所以在扩容操作的时候也有可能会引起一些并发的问题。
2.4 删除数据的时候
  //根据指定的key删除Entry,返回对应的value

public V remove(Object key) {

    Entry<K,V> e = removeEntryForKey(key);

    return (e == null ? null : e.value);

}

//根据指定的key,删除Entry,并返回对应的value

final Entry<K,V> removeEntryForKey(Object key) {

    if (size == 0) {

        return null;

    }

    int hash = (key == null) ? 0 : hash(key);

    int i = indexFor(hash, table.length);

    Entry<K,V> prev = table[i];

    Entry<K,V> e = prev;

    while (e != null) {

        Entry<K,V> next = e.next;

        Object k;

        if (e.hash == hash &&

            ((k = e.key) == key || (key != null && key.equals(k)))) {

            modCount++;

            size--;

            if (prev == e) //如果删除的是table中的第一项的引用

                table[i] = next;//直接将第一项中的next的引用存入table[i]中

            else

                prev.next = next; //否则将table[i]中当前Entry的前一个Entry中的next置为当前Entry的next

            e.recordRemoval(this);

            return e;

        }

        prev = e;

        e = next;

    }

    return e;

}
删除这一块可能会出现两种线程安全问题,第一种是一个线程判断得到了指定的数组位置i并进入了循环,此时,另一个线程也在同样的位置已经删掉了i位置的那个数据了,然后第一个线程那边就没了。但是删除的话,没了倒问题不大。
再看另一种情况,当多个线程同时操作同一个数组位置的时候,也都会先取得现在状态下该位置存储的头结点,然后各自去进行计算操作,之后再把结果写会到该数组位置去,其实写回的时候可能其他的线程已经就把这个位置给修改过了,就会覆盖其他线程的修改。
总之HashMap是非线程安全的,在高并发的场合使用的话,要用Collections.synchronizedMap进行包装一下。
三.参考文章
https://zhuanlan.zhihu.com/p/21673805
http://www.importnew.com/7099.html
http://www.admin10000.com/document/3322.html
http://www.cnblogs.com/chenssy/p/3521565.html
http://xujin.org/java/hm01/
深入理解HashMap上篇的更多相关文章
- 深入理解HashMap+ConcurrentHashMap的扩容策略
前言 理解HashMap和ConcurrentHashMap的重点在于: (1)理解HashMap的数据结构的设计和实现思路 (2)在(1)的基础上,理解ConcurrentHashMap的并发安全的 ...
- Map 综述(一):彻头彻尾理解 HashMap
转载自:https://blog.csdn.net/justloveyou_/article/details/62893086 摘要: HashMap是Map族中最为常用的一种,也是 Java Col ...
- 深入理解HashMap
转自:http://annegu.iteye.com/blog/539465 Hashmap是一种非常常用的.应用广泛的数据类型,最近研究到相关的内容,就正好复习一下.网上关于hashmap的文章很多 ...
- 深入理解HashMap的扩容机制
什么时候扩容: 网上总结的会有很多,但大多都总结的不够完整或者不够准确.大多数可能值说了满足我下面条件一的情况. 扩容必须满足两个条件: 1. 存放新值的时候当前已有元素的个数必须大于等于阈值 2. ...
- 集合之深入理解HashMap
Hashmap是一种非常常用的.应用广泛的数据类型 1.hashmap的数据结构 要知道hashmap是什么,首先要搞清楚它的数据结构,在java编程语言中,最基本的结构就是两种,一个是数组,另外一个 ...
- 通过源码理解HashMap的并发问题
最近在学习有关于Java的基础知识,在学习到HashMap的相关知识的时候,了解了HashMap的并发中会出现的问题,在此记录,加深理解(这篇文章是基于Java1.7的,主要是为了更加直观,更新版本的 ...
- 深入理解HashMap和CurrentHashMap
原文链接:https://segmentfault.com/a/1190000015726870 前言 Map 这样的 Key Value 在软件开发中是非常经典的结构,常用于在内存中存放数据. 本篇 ...
- 理解HashMap的原理
HashMap内部数据结构 HashMap内部采用数组和链表结合的方式来存取数据(见下图).这种方式有什么好处呢? 我们知道,数组操作对于检索是O(1)的,能够很快的根据数组的下标定位对 ...
- 深入理解HashMap(原理,查找,扩容)
面试的时候闻到了Hashmap的扩容机制,之前只看到了Hasmap的实现机制,补一下基础知识,讲的非常好 原文链接: http://www.iteye.com/topic/539465 Hashmap ...
随机推荐
- Linux进程管理(第二版) --进程管理命令
进程管理命令 一.查看用户信息.5.15 分钟内的系统的,优先值越小,优先权越大 ] 1.nice 指定程序运行的优先级 格式 nice -n command 例如 nice -5 myprogrem ...
- SharePoint 2007 单列表模糊查询SPD定制
应用场景:项目中总会遇到一些列表,存着是用户.项目等数据,而我们需要查询有哪些项目,这时候,就需要用到模糊查询了,而这样的查询,基本不需要跨列表,所以,也没必要配置复杂的搜索,用Designer(简称 ...
- 网络最短路径Dijkstra算法
最近在学习算法,看到有人写过的这样一个算法,我决定摘抄过来作为我的学习笔记: <span style="font-size:18px;">/* * File: shor ...
- The 13th tip of DB Query Analyzer, powerful processing EXCEL file
The 13thtip of DB Query Analyzer, powerful processing EXCEL file MA Genfeng (Guangdong UnitollServic ...
- 讲解Oracle面试过程中常见的二十个问题
1.冷备份和热备份的不同点以及各自的优点 解答:热备份针对归档模式的数据库,在数据库仍旧处于工作状态时进行备份.而冷备份指在数据库关闭后,进行备份,适用于所有模式的数据库.热备份的优点在于当备 ...
- Linux中使用export命令设置环境变量
Linux export 命令 2011-08-31 22:36:39| 分类: 命令总结|举报|字号 订阅 功能说明:设置或显示环境变量. ######################## ...
- Spring温故而知新 - bean的装配
Spring装配机制 Spring提供了三种主要的装配机制: 1:通过XML进行显示配置 2:通过Java代码显示配置 3:自动化装配 自动化装配 Spring中IOC容器分两个步骤来完成自动化装配: ...
- 百度AI技术QQ群
百度语音QQ群 648968704 视频分析QQ群 632473158 DuerOSQQ群 604592023 图像识别QQ群 649285136 文字识别QQ群 631977213 理解与交互技术U ...
- linux定时清理数据库过期记录
cron服务是Linux的内置服务,但它不会开机自动启动.可以用以下命令启动和停止服务: /sbin/service crond start//没打开的话首先要打开. /sbin/service cr ...
- 使用Rapidxml读取xml文件
现有xml文件如上,写在一个string中.需要获取节点上元素的类别和属性信息,并存储到结构体表中. 结构体如下: 得到的结果如下: