
clickhouse--表引擎
表引擎
表引擎(即表的类型)决定了:
1)数据的存储方式和位置,写到哪里以及从哪里读取数据
2)支持哪些查询以及如何支持。
3)并发数据访问。
4)索引的使用(如果存在)。
5)是否可以执行多线程请求。
6)数据复制参数。
ClickHouse的表引擎有很多,下面介绍其中几种,对其他引擎有兴趣的可以去查阅官方文档:https://clickhouse.yandex/docs/zh/operations/table_engines/
TinyLog
最简单的表引擎,用于将数据存储在磁盘上。每列都存储在单独的压缩文件中,写入时,数据将附加到文件末尾。
该引擎没有并发控制
- 如果同时从表中读取和写入数据,则读取操作将抛出异常;
- 如果同时写入多个查询中的表,则数据将被破坏。
这种表引擎的典型用法是 write-once:首先只写入一次数据,然后根据需要多次读取。此引擎适用于相对较小的表(建议最多1,000,000行)。如果有许多小表,则使用此表引擎是适合的,因为它比需要打开的文件更少。当拥有大量小表时,可能会导致性能低下。 不支持索引。
案例:创建一个TinyLog引擎的表并插入一条数据
:)create table t (a UInt16, b String) ENGINE=TinyLog;

:)insert into t (a, b) values (1, 'abc');
此时我们到保存数据的目录/var/lib/clickhouse/data/default/t中可以看到如下目录结构:
[root@hadoop102 t]# ls

a.bin  b.bin  sizes.json
a.bin 和 b.bin 是压缩过的对应的列的数据,sizes.json 中记录了每个 *.bin 文件的大小:
[root@hadoop102 t]# cat sizes.json

{"yandex":{"a%2Ebin":{"size":"28"},"b%2Ebin":{"size":"30"}}}
Memory
内存引擎,数据以未压缩的原始形式直接保存在内存当中,服务器重启数据就会消失。读写操作不会相互阻塞,不支持索引。简单查询下有非常非常高的性能表现(超过10G/s)。
一般用到它的地方不多,除了用来测试,就是在需要非常高的性能,同时数据量又不太大(上限大概 1 亿行)的场景。
Merge
Merge 引擎 (不要跟 MergeTree 引擎混淆) 本身不存储数据,但可用于同时从任意多个其他的表中读取数据。 读是自动并行的,不支持写入。读取时,那些被真正读取到数据的表的索引(如果有的话)会被使用。
Merge 引擎的参数:一个数据库名和一个用于匹配表名的正则表达式。
案例:先建t1,t2,t3三个表,然后用 Merge 引擎的 t 表再把它们链接起来。
:)create table t1 (id UInt16, name String) ENGINE=TinyLog;

:)create table t2 (id UInt16, name String) ENGINE=TinyLog;

:)create table t3 (id UInt16, name String) ENGINE=TinyLog;

:)insert into t1(id, name) values (1, 'first');

:)insert into t2(id, name) values (2, 'second');

:)insert into t3(id, name) values (3, 'i am in t3');

:)create table t (id UInt16, name String) ENGINE=Merge(currentDatabase(), '^t');

:) select * from t;

┌─id─┬─name─┐

│  2 │ second │

└────┴──────┘

┌─id─┬─name──┐

│  1 │ first │

└────┴───────┘

┌─id─┬─name───────┐

│ 3	 │ i am in t3 │

└────┴────────────┘
MergeTree
Clickhouse 中最强大的表引擎当属 MergeTree (合并树)引擎及该系列(*MergeTree)中的其他引擎。
MergeTree 引擎系列的基本理念如下。当你有巨量数据要插入到表中,你要高效地一批批写入数据片段,并希望这些数据片段在后台按照一定规则合并。相比在插入时不断修改(重写)数据进存储,这种策略会高效很多。
他的特点如下:
1)数据按主键排序
2)可以使用分区(如果指定了主键)
3)支持数据副本
4)支持数据采样
格式:
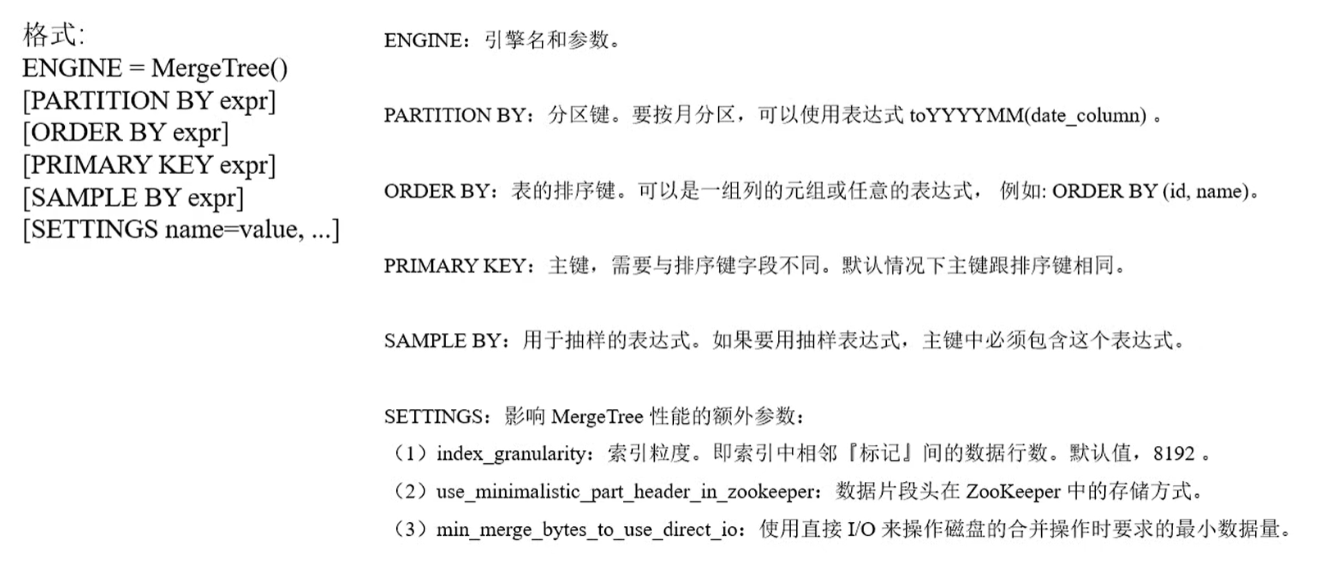
案例:
create table mt_table(date Date,id UInt8,name String)

engine=MergeTree()

partition by date

order by (id,name)

settings index_granularity=8192;

insert into mt_table values ('2019-05-01', 1, 'zhangsan');

insert into mt_table values ('2019-06-01', 2, 'lisi');

insert into mt_table values ('2019-05-03', 3, 'wangwu');
在/var/lib/clickhouse/data/default/mt_tree下可以看到:
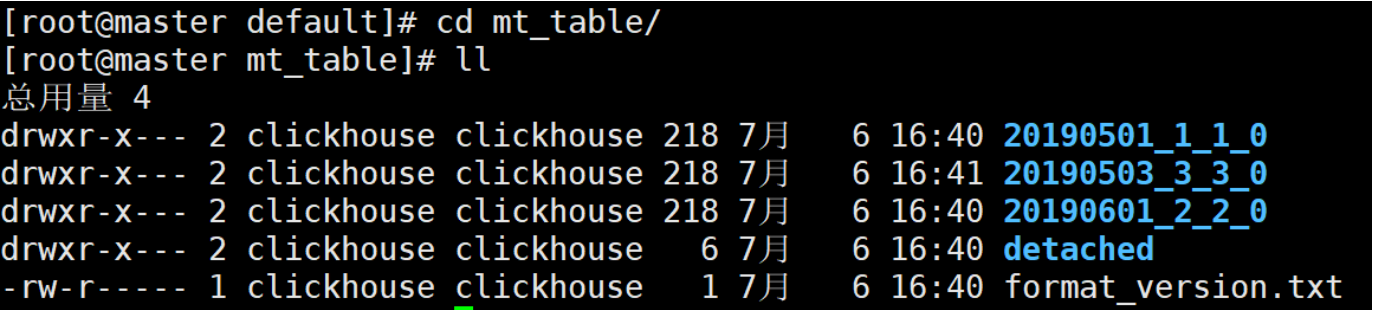
随便进入一个目录:
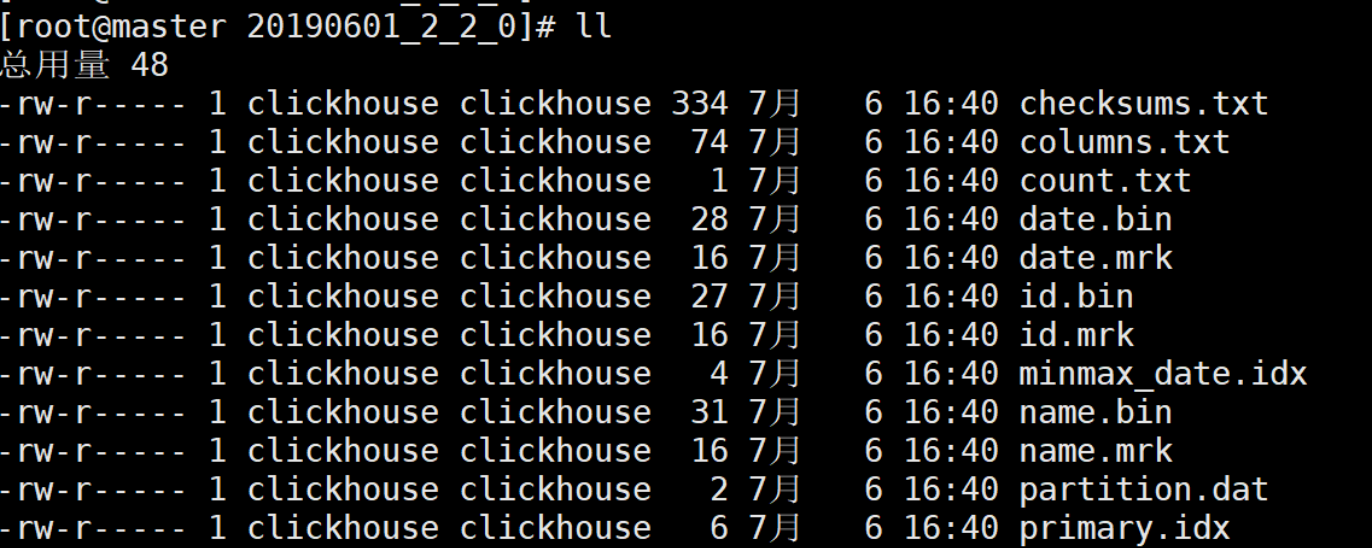
- *.bin是按列保存数据的文件
- *.mrk保存块偏移量
- primary.idx保存主键索引
ReplacingMergeTree
这个引擎是在 MergeTree 的基础上,添加了“处理重复数据”的功能,该引擎和MergeTree的不同之处在于它会删除具有相同主键的重复项。数据的去重只会在合并的过程中出现。合并会在未知的时间在后台进行,所以你无法预先作出计划。有一些数据可能仍未被处理。因此,ReplacingMergeTree 适用于在后台清除重复的数据以节省空间,但是它不保证没有重复的数据出现。
格式:
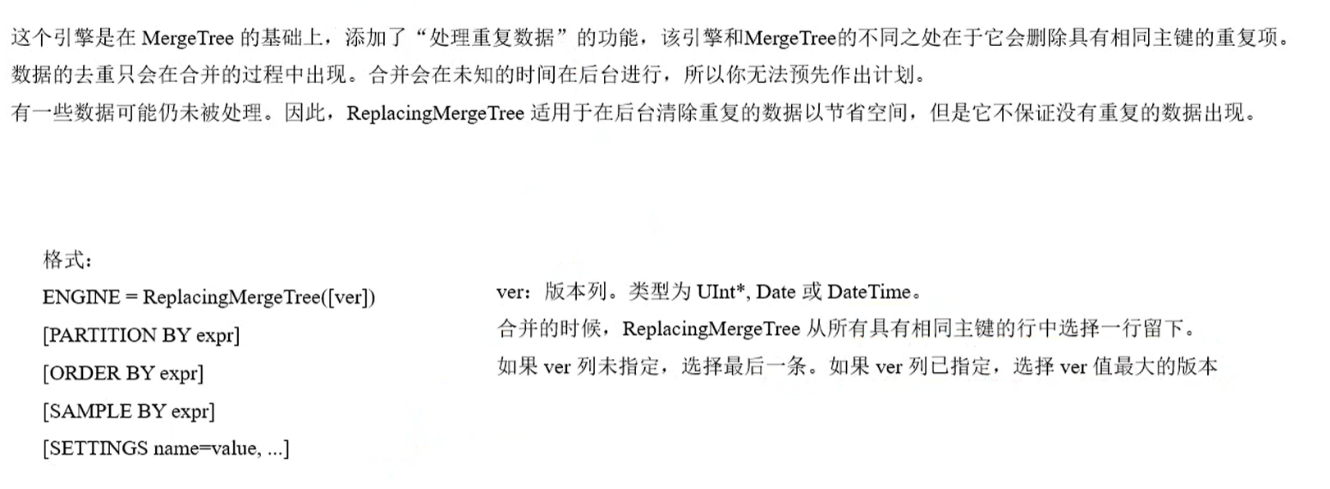
案例:
create table rmt_table(date Date,id UInt8,name String,point UInt8)

ENGINE=ReplacingMergeTree(point)

partition by date

order by (id,name);

插入一些数据:

insert into rmt_table values ('2019-07-10', 1, 'a', 20);

insert into rmt_table values ('2019-07-10', 1, 'a', 30);

insert into rmt_table values ('2019-07-11', 1, 'a', 20);

insert into rmt_table values ('2019-07-11', 1, 'a', 30);

insert into rmt_table values ('2019-07-11', 1, 'a', 10);

等待一段时间或optimize table rmt_table手动触发merge,后查询

master :) select * from rmt_table;

SELECT *

FROM rmt_table

┌───────date─┬─id─┬─name─┬─point─┐

│ 2019-07-10 │  1 │ a    │    20 │

└────────────┴────┴──────┴───────┘

┌───────date─┬─id─┬─name─┬─point─┐

│ 2019-07-10 │  1 │ a    │    30 │

└────────────┴────┴──────┴───────┘

┌───────date─┬─id─┬─name─┬─point─┐

│ 2019-07-11 │  1 │ a    │    20 │

└────────────┴────┴──────┴───────┘

┌───────date─┬─id─┬─name─┬─point─┐

│ 2019-07-11 │  1 │ a    │    30 │

└────────────┴────┴──────┴───────┘

┌───────date─┬─id─┬─name─┬─point─┐

│ 2019-07-11 │  1 │ a    │    10 │

└────────────┴────┴──────┴───────┘

5 rows in set. Elapsed: 0.002 sec.

master :) optimize table rmt_table;

OPTIMIZE TABLE rmt_table

Ok.

0 rows in set. Elapsed: 0.169 sec.

master :) select * from rmt_table;

SELECT *

FROM rmt_table

┌───────date─┬─id─┬─name─┬─point─┐

│ 2019-07-10 │  1 │ a    │    30 │

└────────────┴────┴──────┴───────┘

┌───────date─┬─id─┬─name─┬─point─┐

│ 2019-07-11 │  1 │ a    │    30 │

└────────────┴────┴──────┴───────┘

3 rows in set. Elapsed: 0.002 sec.
有时候手动刷新一次没有用,多刷几次,还是有些没有,那就只能等时间了。
SummingMergeTree
该引擎继承自 MergeTree。区别在于,当合并 SummingMergeTree 表的数据片段时,ClickHouse 会把所有具有相同主键的行合并为一行,该行包含了被合并的行中具有数值数据类型的列的汇总值。如果主键的组合方式使得单个键值对应于大量的行,则可以显著的减少存储空间并加快数据查询的速度,对于不可加的列,会取一个最先出现的值。
语法:
ENGINE = SummingMergeTree([columns])

[PARTITION BY expr]

[ORDER BY expr]

[SAMPLE BY expr]

[SETTINGS name=value,...]
columns — 包含将要被汇总的列的列名的元组
案例:
create table smt_table(date Date,name String,sum UInt16,not_sum UInt16)

:-] engine=SummingMergeTree(sum)

:-] partition by date

:-] order by (date,name);

插入数据:

insert into smt_table values ('2019-07-10', 'a', 1, 2);

insert into smt_table values ('2019-07-10', 'b', 2, 1);

insert into smt_table values ('2019-07-11', 'b', 3, 9);

insert into smt_table values ('2019-07-11', 'b', 3, 8);

insert into smt_table values ('2019-07-11', 'a', 3, 1);

insert into smt_table values ('2019-07-12', 'c', 1, 3);

等待一段时间或optimize table smt_table手动触发merge,后查询

master :) select * from smt_table;

SELECT *

FROM smt_table

┌───────date─┬─name─┬─sum─┬─not_sum─┐

│ 2019-07-10 │ a    │   1 │       2 │

└────────────┴──────┴─────┴─────────┘

┌───────date─┬─name─┬─sum─┬─not_sum─┐

│ 2019-07-10 │ b    │   2 │       1 │

└────────────┴──────┴─────┴─────────┘

┌───────date─┬─name─┬─sum─┬─not_sum─┐

│ 2019-07-11 │ b    │   3 │       9 │

└────────────┴──────┴─────┴─────────┘

┌───────date─┬─name─┬─sum─┬─not_sum─┐

│ 2019-07-11 │ b    │   3 │       8 │

└────────────┴──────┴─────┴─────────┘

┌───────date─┬─name─┬─sum─┬─not_sum─┐

│ 2019-07-11 │ a    │   3 │       1 │

└────────────┴──────┴─────┴─────────┘

┌───────date─┬─name─┬─sum─┬─not_sum─┐

│ 2019-07-12 │ c    │   1 │       3 │

└────────────┴──────┴─────┴─────────┘

6 rows in set. Elapsed: 0.002 sec.

master :) optimize table smt_table ;

OPTIMIZE TABLE smt_table

Ok.

0 rows in set. Elapsed: 0.001 sec.

master :) select * from smt_table;

SELECT *

FROM smt_table

┌───────date─┬─name─┬─sum─┬─not_sum─┐

│ 2019-07-10 │ a    │   1 │       2 │

│ 2019-07-10 │ b    │   2 │       1 │

└────────────┴──────┴─────┴─────────┘

┌───────date─┬─name─┬─sum─┬─not_sum─┐

│ 2019-07-11 │ a    │   3 │       1 │

│ 2019-07-11 │ b    │   6 │       9 │

└────────────┴──────┴─────┴─────────┘

┌───────date─┬─name─┬─sum─┬─not_sum─┐

│ 2019-07-12 │ c    │   1 │       3 │

└────────────┴──────┴─────┴─────────┘

5 rows in set. Elapsed: 0.002 sec.
发现2019-07-11,b的sum列合并相加了,=not_sum列取了9(因为b列为9的数据最先插入)。
Distributed
分布式引擎,本身不存储数据, 但可以在多个服务器上进行分布式查询。 读是自动并行的。读取时,远程服务器表的索引(如果有的话)会被使用。
Distributed(cluster_name, database, table [, sharding_key])
参数解析:

cluster_name  - 服务器配置文件中的集群名,在/etc/metrika.xml中配置的

database – 数据库名

table – 表名

sharding_key – 数据分片键

案例演示:

1)在hadoop102,hadoop103,hadoop104上分别创建一个表t

:)create table t(id UInt16, name String) ENGINE=TinyLog;

2)在三台机器的t表中插入一些数据

:)insert into t(id, name) values (1, 'zhangsan');

:)insert into t(id, name) values (2, 'lisi');

3)在hadoop102上创建分布式表

:)create table dis_table(id UInt16, name String) ENGINE=Distributed(perftest_3shards_1replicas, default, t, id);

4)往dis_table中插入数据

:) insert into dis_table select * from t

5)查看数据量

:) select count() from dis_table

FROM dis_table

┌─count()─┐

│    8 │

└─────────┘

:) select count() from t

SELECT count()

FROM t

┌─count()─┐

│    3 │

└─────────┘

可以看到每个节点大约有1/3的数据
clickhouse--表引擎的更多相关文章
- UniqueMergeTree:支持实时更新删除的 ClickHouse 表引擎
UniqueMergeTree 开发的业务背景 首先,我们看一下哪些场景需要用到实时更新. 我们总结了三类场景: 第一类是业务需要对它的交易类数据进行实时分析,需要把数据流同步到 ClickHouse ...
- Clickhouse表引擎之MergeTree
1.概述 在Clickhouse中有多种表引擎,不同的表引擎拥有不同的功能,它直接决定了数据如何读写.是否能够并发读写.是否支持索引.数据是否可备份等等.本篇博客笔者将为大家介绍Clickhouse中 ...
- Clickhouse表引擎探究-ReplacingMergeTree
作者:耿宏宇 1 表引擎简述 1.1 官方描述 MergeTree 系列的引擎被设计用于插入极大量的数据到一张表当中.数据可以以数据片段的形式一个接着一个的快速写入,数据片段在后台按照一定的规则进行合 ...
- ClickHouse(10)ClickHouse合并树MergeTree家族表引擎之ReplacingMergeTree详细解析
目录 建表语法 数据处理策略 资料分享 参考文章 MergeTree拥有主键,但是它的主键却没有唯一键的约束.这意味着即便多行数据的主键相同,它们还是能够被正常写入.在某些使用场合,用户并不希望数据表 ...
- ClickHouse(11)ClickHouse合并树MergeTree家族表引擎之SummingMergeTree详细解析
目录 建表语法 数据处理 汇总的通用规则 AggregateFunction 列中的汇总 嵌套结构数据的处理 资料分享 参考文章 SummingMergeTree引擎继承自MergeTree.区别在于 ...
- ClickHouse(13)ClickHouse合并树MergeTree家族表引擎之CollapsingMergeTree详细解析
目录 建表 折叠 数据 算法 资料分享 参考文章 该引擎继承于MergeTree,并在数据块合并算法中添加了折叠行的逻辑.CollapsingMergeTree会异步的删除(折叠)这些除了特定列Sig ...
- ClickHouse入门:表引擎-HDFS
前言插件及服务器版本服务器:ubuntu 16.04Hadoop:2.6ClickHouse:20.9.3.45 文章目录 简介 引擎配置 HDFS表引擎的两种使用形式 引用 简介 ClickHous ...
- ClickHouse(12)ClickHouse合并树MergeTree家族表引擎之AggregatingMergeTree详细解析
目录 建表语法 查询和插入数据 数据处理逻辑 ClickHouse相关资料分享 AggregatingMergeTree引擎继承自 MergeTree,并改变了数据片段的合并逻辑.ClickHouse ...
- clickhouse核心引擎MergeTree子引擎
在clickhouse使用过程中,针对数据量和查询场景,MergeTree是最常用也是较为合适的表引擎.针对特定的业务,MergeTree的子引擎可以针对不同的业务而定,但都基于MergeTree引擎 ...
- 【实时数仓】Day05-ClickHouse:入门、安装、数据类型、表引擎、SQL操作、副本、分片集群
一.ClickHouse入门 1.介绍 是一个开源的列式存储数据库(DBMS) 使用C++编写 用于在线分析查询(OLAP) 能够使用SQL查询实时生成分析数据报告 2.特点 (1)列式存储 比较: ...
随机推荐
- Centos7.8安装Gitlab
公司为了合规性考虑,需要自己搭建私有化版的github.那不用想,肯定要上GitLab了. 项目背景: 服务器:华为云ECS,需要上公网,并在安全组打开80端口访问. 用户:关闭公开注册,新建用户后, ...
- 中电金信:加快企业 AI 平台升级,构建金融智能业务新引擎
在当今数字化时代的浪潮下,人工智能(AI)技术的蓬勃发展正为各行业带来前所未有的变革与创新契机.尤其是在金融领域,AI 模型的广泛应用已然成为提升竞争力.优化业务流程以及实现智能化转型的关键驱动力 ...
- System.Text.Json匿名对象反序列化
以前就是一直使用 Newtonsoft.Json 用起来还是挺舒服的.由于 JSON 的应用越来越广,现在. NET Core 都内置了 System.Text.Json 可以直接对 JSON 进行操 ...
- Netty有关
https://www.baeldung.com/tag/netty/ https://github.com/eugenp/tutorials https://stackoverflow.com/qu ...
- Spring Cloud Sleuth in a Monolith Application
1. Overview In this article, we're introducing Spring Cloud Sleuth – a powerful tool for enhancing ...
- Qt音视频开发28-ffmpeg解码本地摄像头(yuv422转yuv420)
一.前言 一开始用ffmpeg做的是视频流的解析,后面增加了本地视频文件的支持,到后面发现ffmpeg也是支持本地摄像头设备的,只要是原则上打通的比如win系统上相机程序.linux上茄子程序可以正常 ...
- Qt编写物联网管理平台45-采集数据转发
一.前言 本系统严格意义上说是一个直连硬件的客户端软件,下面接的modbus协议的设备直接通过网络或者串口和软件通信,软件负责解析数据和存储记录.有时候客户想要领导办公室或者分管这一块的部门经理办公室 ...
- Qt开发经验小技巧141-145
QImage支持xpm图标,查看Qt内置的QStyle风格的代码中可以发现大量的xpm图标定义,通过代码的形式来产生图标,哇咔咔好牛逼. static const char * const imgDa ...
- 可扩展系统——基于SPI扩展
一.我们为什么讨论SPI? 为具有悠久历史的大型项目(屎山)添加新功能时,我们常常不太好评估变更的影响范围.因为原系统不具备良好的扩展性,导致修改整体发散,且不易单测.此时可以考虑使用接口来描述业务逻 ...
- 记录小程序跳转h5,然后h5涉及下载文件的问题
小程序跳转h5中,可以在小程序增加一个页面使用webView方式嵌套三方小程序,不过需要配置白名单 由于小程序的限制,不能在嵌套的h5中进行文件下载 网上也没有很好的解决方法,解决方法是再跳到小程序带 ...