
【CV论文阅读】Detecting events and key actors in multi-person videos
论文主要介绍一种多人协作的视频事件识别的方法,使用attention模型+RNN网络,最近粗浅地学习了RNN网络,它比较适合用于处理序列的存在上下文作用的数据。
NCAA Basketball数据集
这个数据集是作者新构建的,一个事件4秒长度,在论文中共需识别11个事件。而且从训练集子集通过标注人物的bounding box学习了一个multibox detector,来识别所有帧中的人物bounding box。
RNN模型
论文使用了RNN模型中的LSTM来处理帧序列。网络的结构如下图,其中BLSTM代表双向的LSTM结构
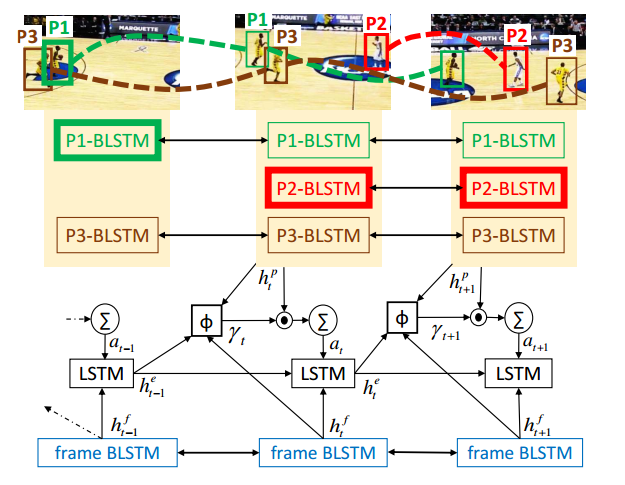
每个Pi-BLSTM跟踪每个人物帧序列中的状态,方框的厚度代表attention作为key人物的权值。
首先,每一帧提取1024维度的特征 ,而对于每帧的每一个player,提取2805维特征(1440维位置spatial的信息以及1365维appearance信息)
 。首先使用BLSTM计算hidden state
 ,它保存了全局上下文的信息。计算式子如下
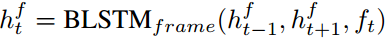
然后可以利用单向的LSTM计算事件状态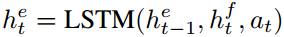
最后,对于每个事件k,都定义一个权向量 ,计算它们的内积
 来确定事件的分类。误差函数可以定义:
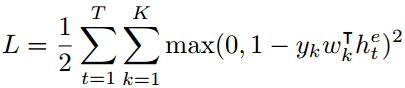
其中 是对于视频原label,如果属于k则为1,否则为-1。
Attention 模型
Attention模型的主要作用在于识别主人物并增大他在计算event state中所起的作用,在这里会利用一个softmax函数来实现上述的功能。论文提出了两种思路,分别是对每个人物进行跟踪的模型以及不跟踪的模型。
跟踪模型
利用KTL tracker和图匹配找到每帧对应的人物,并为每个人物建立一个BLSTM网络,用于计算hidden state  ,得
 。计算softmax函数分配每个人物在每一帧的权重,从而识别关键人物,如下计算
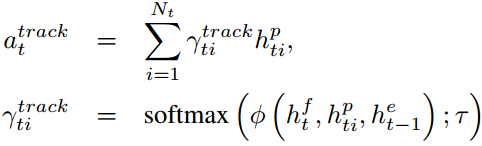
其中 是一个多层感知机。
非跟踪模型
直接使用 替代
 ,可以得到计算方法为
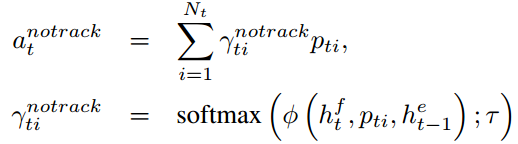
【CV论文阅读】Detecting events and key actors in multi-person videos的更多相关文章
- 【CV论文阅读】Deep Linear Discriminative Analysis, ICLR, 2016
DeepLDA 并不是把LDA模型整合到了Deep Network,而是利用LDA来指导模型的训练.从实验结果来看,使用DeepLDA模型最后投影的特征也是很discriminative 的,但是很遗 ...
- 【CV论文阅读】Unsupervised deep embedding for clustering analysis
Unsupervised deep embedding for clustering analysis 偶然发现这篇发在ICML2016的论文,它主要的关注点在于unsupervised deep e ...
- 【CV论文阅读】生成式对抗网络GAN
生成式对抗网络GAN 1. 基本GAN 在论文<Generative Adversarial Nets>提出的GAN是最原始的框架,可以看成极大极小博弈的过程,因此称为“对抗网络”.一般 ...
- 【CV论文阅读】Image Captioning 总结
初次接触Captioning的问题,第一印象就是Andrej Karpathy好聪明.主要从他的两篇文章开始入门,<Deep Fragment Embeddings for Bidirectio ...
- 【CV论文阅读】+【搬运工】LocNet: Improving Localization Accuracy for Object Detection + A Theoretical analysis of feature pooling in Visual Recognition
论文的关注点在于如何提高bounding box的定位,使用的是概率的预测形式,模型的基础是region proposal.论文提出一个locNet的深度网络,不在依赖于回归方程.论文中提到locne ...
- 【CV论文阅读】Dynamic image networks for action recognition
论文的重点在于后面approximation部分. 在<Rank Pooling>的论文中提到,可以通过训练RankSVM获得参数向量d,来作为视频帧序列的representation.而 ...
- 【CV论文阅读】Rank Pooling for Action Recognition
这是期刊论文的版本,不是会议论文的版本.看了论文之后,只能说,太TM聪明了.膜拜~~ 视频的表示方法有很多,一般是把它看作帧的序列.论文提出一种新的方法去表示视频,用ranking function的 ...
- 【CV论文阅读】Two stream convolutional Networks for action recognition in Vedios
论文的三个贡献 (1)提出了two-stream结构的CNN,由空间和时间两个维度的网络组成. (2)使用多帧的密集光流场作为训练输入,可以提取动作的信息. (3)利用了多任务训练的方法把两个数据集联 ...
- 【CV论文阅读】YOLO:Unified, Real-Time Object Detection
YOLO的一大特点就是快,在处理上可以达到完全的实时.原因在于它整个检测方法非常的简洁,使用回归的方法,直接在原图上进行目标检测与定位. 多任务检测: 网络把目标检测与定位统一到一个深度网络中,而且可 ...
随机推荐
- select在数据库中有两种含义
select在数据库中有两种意思 (1)是赋值的意思(2)是输出,打印的意思我想你问的大概是赋值吧print和 select在数据库中都有打印输出的意思 用法是:select @aa=select* ...
- vim要粘贴的话,先set paste,然后粘贴,然后再set nopaste
要粘贴的话,先set paste,然后粘贴,然后再set nopaste
- php基础排序算法
1.冒泡排序 $arr = array(12,34,57,42,165.4,73,51); function bubbling_sort($array) { $cou = count($array); ...
- 第2节 mapreduce深入学习:2、3
第2节 mapreduce深入学习:2.MapReduce的分区:3.分区案例的补充完成运行实现 在MapReduce中,通过我们指定分区,会将同一个分区的数据发送到同一个reduce当中进行处理,例 ...
- Javascript创建对象几种方法解析
Javascript创建对象几种方法解析 Javascript面向对象编程一直是面试中的重点,将自己的理解整理如下,主要参考<Javascript高级程序设计 第三版>,欢迎批评指正. 通 ...
- php-fpm进程数管理
PHP-FPM 先来了解一些名词概念: CGI是Common Gateway Interface(通用网管协议),用于让交互程序和Web服务器通信的协议.它负责处理URL的请求,启动一个进程,将客户端 ...
- winform ComboBox/TextBox自动提示
ComboBox和TextBox控件都带有自动前缀匹配,只要设置其中的AutoCompleteMode,AutoCompleteSource,AutoCompleteCustomSource三个属性的 ...
- django-3 admin开启后台配置并展示表内容
设置了superuser 之后,可以在run server 后, 通过浏览器访问后台,进行界面配置. 1. python manage.py creatersuperuser 此命令在manage.p ...
- NOI模拟(3.3)螺旋序列(出题人一定是月厨)
Description S也想寻求真正的智慧,然而由于“抑制力”的存在,她必须先解决一系列询问.有一个长度为n的序列a,一个长度为m序列b被称为螺旋序列当且仅当b1=bm且对于1<=i<= ...
- Unity Water Shader
上图是一个物体浸入水中的效果 原理 我们使用相机渲染的整个场景的深度图减去需要忽略的模型的深度,这里忽略的是图中蓝色部分,就保留了其他的深度值. 用到Main Camera渲染的深度贴图: sampl ...