
入门大数据---Hive常用DDL操作
一、Database
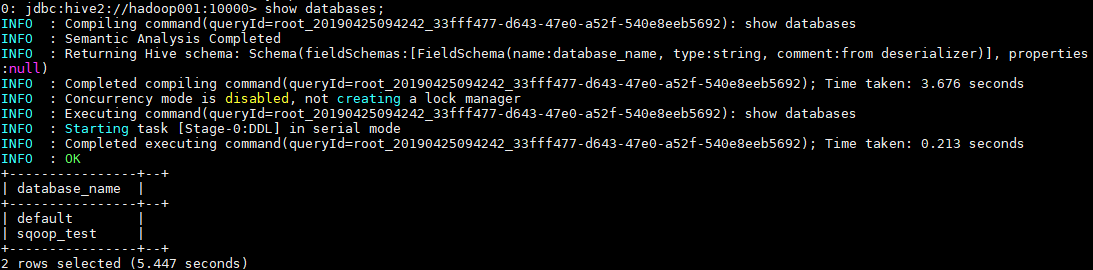
1.1 查看数据列表
show databases;
1.2 使用数据库
USE database_name;
1.3 新建数据库
语法:
CREATE (DATABASE|SCHEMA) [IF NOT EXISTS] database_name   --DATABASE|SCHEMA 是等价的

  [COMMENT database_comment] --数据库注释

  [LOCATION hdfs_path] --存储在 HDFS 上的位置

  [WITH DBPROPERTIES (property_name=property_value, ...)]; --指定额外属性
示例:
CREATE DATABASE IF NOT EXISTS hive_test

  COMMENT 'hive database for test'

  WITH DBPROPERTIES ('create'='heibaiying');
1.4 查看数据库信息
语法:
DESC DATABASE [EXTENDED] db_name; --EXTENDED 表示是否显示额外属性
示例:
DESC DATABASE EXTENDED hive_test;
1.5 删除数据库
语法:
DROP (DATABASE|SCHEMA) [IF EXISTS] database_name [RESTRICT|CASCADE];
- 默认行为是 RESTRICT,如果数据库中存在表则删除失败。要想删除库及其中的表,可以使用 CASCADE 级联删除。
示例:
DROP DATABASE IF EXISTS hive_test CASCADE;
二、创建表
2.1 建表语法
CREATE [TEMPORARY] [EXTERNAL] TABLE [IF NOT EXISTS] [db_name.]table_name     --表名

  [(col_name data_type [COMMENT col_comment],

    ... [constraint_specification])]  --列名 列数据类型

  [COMMENT table_comment]   --表描述

  [PARTITIONED BY (col_name data_type [COMMENT col_comment], ...)]  --分区表分区规则

  [

    CLUSTERED BY (col_name, col_name, ...)

   [SORTED BY (col_name [ASC|DESC], ...)] INTO num_buckets BUCKETS

  ]  --分桶表分桶规则

  [SKEWED BY (col_name, col_name, ...) ON ((col_value, col_value, ...), (col_value, col_value, ...), ...)

   [STORED AS DIRECTORIES]

  ]  --指定倾斜列和值

  [

   [ROW FORMAT row_format]

   [STORED AS file_format]

     | STORED BY 'storage.handler.class.name' [WITH SERDEPROPERTIES (...)]

  ]  -- 指定行分隔符、存储文件格式或采用自定义存储格式

  [LOCATION hdfs_path]  -- 指定表的存储位置

  [TBLPROPERTIES (property_name=property_value, ...)]  --指定表的属性

  [AS select_statement];   --从查询结果创建表
2.2 内部表
  CREATE TABLE emp(

    empno INT,

    ename STRING,

    job STRING,

    mgr INT,

    hiredate TIMESTAMP,

    sal DECIMAL(7,2),

    comm DECIMAL(7,2),

    deptno INT)

    ROW FORMAT DELIMITED FIELDS TERMINATED BY "\t";
2.3 外部表
  CREATE EXTERNAL TABLE emp_external(

    empno INT,

    ename STRING,

    job STRING,

    mgr INT,

    hiredate TIMESTAMP,

    sal DECIMAL(7,2),

    comm DECIMAL(7,2),

    deptno INT)

    ROW FORMAT DELIMITED FIELDS TERMINATED BY "\t"

    LOCATION '/hive/emp_external';
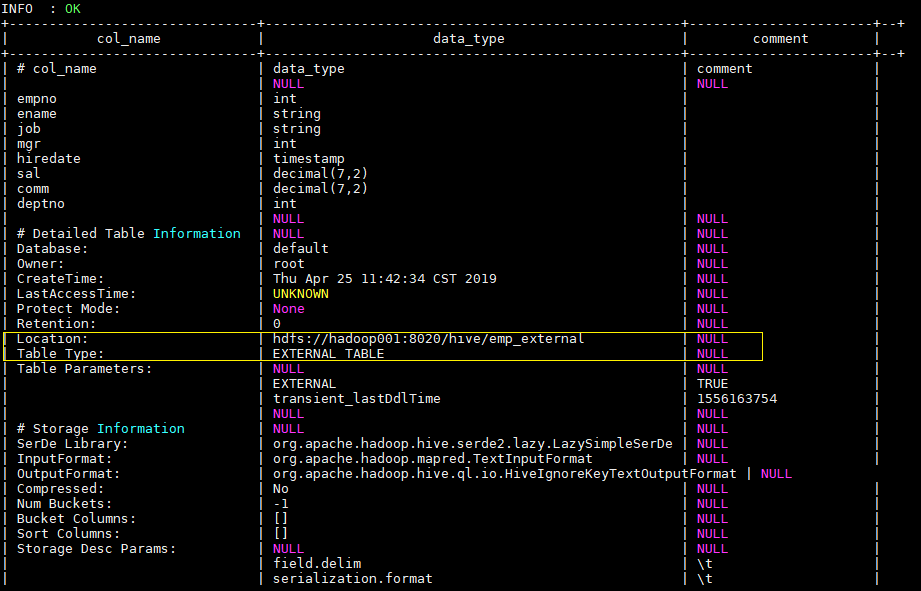
使用 desc format emp_external 命令可以查看表的详细信息如下:
2.4 分区表
  CREATE EXTERNAL TABLE emp_partition(

    empno INT,

    ename STRING,

    job STRING,

    mgr INT,

    hiredate TIMESTAMP,

    sal DECIMAL(7,2),

    comm DECIMAL(7,2)

    )

    PARTITIONED BY (deptno INT)   -- 按照部门编号进行分区

    ROW FORMAT DELIMITED FIELDS TERMINATED BY "\t"

    LOCATION '/hive/emp_partition';
2.5 分桶表
  CREATE EXTERNAL TABLE emp_bucket(

    empno INT,

    ename STRING,

    job STRING,

    mgr INT,

    hiredate TIMESTAMP,

    sal DECIMAL(7,2),

    comm DECIMAL(7,2),

    deptno INT)

    CLUSTERED BY(empno) SORTED BY(empno ASC) INTO 4 BUCKETS  --按照员工编号散列到四个 bucket 中

    ROW FORMAT DELIMITED FIELDS TERMINATED BY "\t"

    LOCATION '/hive/emp_bucket';
2.6 倾斜表
通过指定一个或者多个列经常出现的值(严重偏斜),Hive 会自动将涉及到这些值的数据拆分为单独的文件。在查询时,如果涉及到倾斜值,它就直接从独立文件中获取数据,而不是扫描所有文件,这使得性能得到提升。
  CREATE EXTERNAL TABLE emp_skewed(

    empno INT,

    ename STRING,

    job STRING,

    mgr INT,

    hiredate TIMESTAMP,

    sal DECIMAL(7,2),

    comm DECIMAL(7,2)

    )

    SKEWED BY (empno) ON (66,88,100)  --指定 empno 的倾斜值 66,88,100

    ROW FORMAT DELIMITED FIELDS TERMINATED BY "\t"

    LOCATION '/hive/emp_skewed';
2.7 临时表
临时表仅对当前 session 可见,临时表的数据将存储在用户的暂存目录中,并在会话结束后删除。如果临时表与永久表表名相同,则对该表名的任何引用都将解析为临时表,而不是永久表。临时表还具有以下两个限制:
- 不支持分区列;
- 不支持创建索引。
  CREATE TEMPORARY TABLE emp_temp(

    empno INT,

    ename STRING,

    job STRING,

    mgr INT,

    hiredate TIMESTAMP,

    sal DECIMAL(7,2),

    comm DECIMAL(7,2)

    )

    ROW FORMAT DELIMITED FIELDS TERMINATED BY "\t";
2.8 CTAS创建表
支持从查询语句的结果创建表:
CREATE TABLE emp_copy AS SELECT * FROM emp WHERE deptno='20';
2.9 复制表结构
语法:
CREATE [TEMPORARY] [EXTERNAL] TABLE [IF NOT EXISTS] [db_name.]table_name  --创建表表名

   LIKE existing_table_or_view_name  --被复制表的表名

   [LOCATION hdfs_path]; --存储位置
示例:
CREATE TEMPORARY EXTERNAL TABLE IF NOT EXISTS emp_co LIKE emp
2.10 加载数据到表
加载数据到表中属于 DML 操作,这里为了方便大家测试,先简单介绍一下加载本地数据到表中:
-- 加载数据到 emp 表中

load data local inpath "/usr/file/emp.txt" into table emp;
其中 emp.txt 的内容如下,你可以直接复制使用,也可以到本仓库的resources 目录下载:
7369	SMITH	CLERK	7902	1980-12-17 00:00:00	800.00		20

7499	ALLEN	SALESMAN	7698	1981-02-20 00:00:00	1600.00	300.00	30

7521	WARD	SALESMAN	7698	1981-02-22 00:00:00	1250.00	500.00	30

7566	JONES	MANAGER	7839	1981-04-02 00:00:00	2975.00		20

7654	MARTIN	SALESMAN	7698	1981-09-28 00:00:00	1250.00	1400.00	30

7698	BLAKE	MANAGER	7839	1981-05-01 00:00:00	2850.00		30

7782	CLARK	MANAGER	7839	1981-06-09 00:00:00	2450.00		10

7788	SCOTT	ANALYST	7566	1987-04-19 00:00:00	1500.00		20

7839	KING	PRESIDENT		1981-11-17 00:00:00	5000.00		10

7844	TURNER	SALESMAN	7698	1981-09-08 00:00:00	1500.00	0.00	30

7876	ADAMS	CLERK	7788	1987-05-23 00:00:00	1100.00		20

7900	JAMES	CLERK	7698	1981-12-03 00:00:00	950.00		30

7902	FORD	ANALYST	7566	1981-12-03 00:00:00	3000.00		20

7934	MILLER	CLERK	7782	1982-01-23 00:00:00	1300.00		10
加载后可查询表中数据:

三、修改表
3.1 重命名表
语法:
ALTER TABLE table_name RENAME TO new_table_name;
示例:
ALTER TABLE emp_temp RENAME TO new_emp; --把 emp_temp 表重命名为 new_emp
3.2 修改列
语法:
ALTER TABLE table_name [PARTITION partition_spec] CHANGE [COLUMN] col_old_name col_new_name column_type

  [COMMENT col_comment] [FIRST|AFTER column_name] [CASCADE|RESTRICT];
示例:
-- 修改字段名和类型

ALTER TABLE emp_temp CHANGE empno empno_new INT;

-- 修改字段 sal 的名称 并将其放置到 empno 字段后

ALTER TABLE emp_temp CHANGE sal sal_new decimal(7,2)  AFTER ename;

-- 为字段增加注释

ALTER TABLE emp_temp CHANGE mgr mgr_new INT COMMENT 'this is column mgr';
3.3 新增列
示例:
ALTER TABLE emp_temp ADD COLUMNS (address STRING COMMENT 'home address');
四、清空表/删除表
4.1 清空表
语法:
-- 清空整个表或表指定分区中的数据

TRUNCATE TABLE table_name [PARTITION (partition_column = partition_col_value,  ...)];
- 目前只有内部表才能执行 TRUNCATE 操作,外部表执行时会抛出异常
Cannot truncate non-managed table XXXX。
示例:
TRUNCATE TABLE emp_mgt_ptn PARTITION (deptno=20);
4.2 删除表
语法:
DROP TABLE [IF EXISTS] table_name [PURGE];
- 内部表:不仅会删除表的元数据,同时会删除 HDFS 上的数据;
- 外部表:只会删除表的元数据,不会删除 HDFS 上的数据;
- 删除视图引用的表时,不会给出警告(但视图已经无效了,必须由用户删除或重新创建)。
五、其他命令
5.1 Describe
查看数据库:
DESCRIBE|Desc DATABASE [EXTENDED] db_name; --EXTENDED 是否显示额外属性
查看表:
DESCRIBE|Desc [EXTENDED|FORMATTED] table_name --FORMATTED 以友好的展现方式查看表详情
5.2 Show
1. 查看数据库列表
-- 语法

SHOW (DATABASES|SCHEMAS) [LIKE 'identifier_with_wildcards'];

-- 示例:

SHOW DATABASES like 'hive*';
LIKE 子句允许使用正则表达式进行过滤,但是 SHOW 语句当中的 LIKE 子句只支持 *(通配符)和 |(条件或)两个符号。例如 employees,emp *,emp * | * ees,所有这些都将匹配名为 employees 的数据库。
2. 查看表的列表
-- 语法

SHOW TABLES [IN database_name] ['identifier_with_wildcards'];

-- 示例

SHOW TABLES IN default;
3. 查看视图列表
SHOW VIEWS [IN/FROM database_name] [LIKE 'pattern_with_wildcards']; --仅支持 Hive 2.2.0 +
4. 查看表的分区列表
SHOW PARTITIONS table_name;
5. 查看表/视图的创建语句
SHOW CREATE TABLE ([db_name.]table_name|view_name);
参考资料
入门大数据---Hive常用DDL操作的更多相关文章
- 入门大数据---Hive常用DML操作
Hive 常用DML操作 一.加载文件数据到表 1.1 语法 LOAD DATA [LOCAL] INPATH 'filepath' [OVERWRITE] INTO TABLE tablename ...
- Hive 学习之路(四)—— Hive 常用DDL操作
一.Database 1.1 查看数据列表 show databases; 1.2 使用数据库 USE database_name; 1.3 新建数据库 语法: CREATE (DATABASE|SC ...
- Hive 系列(四)—— Hive 常用 DDL 操作
一.Database 1.1 查看数据列表 show databases; 1.2 使用数据库 USE database_name; 1.3 新建数据库 语法: CREATE (DATABASE|SC ...
- 入门大数据---Hive的搭建
本博客主要介绍Hive和MySql的搭建: 学习视频一天就讲完了,我看完了自己搭建MySql遇到了一堆坑,然后花了快两天才解决完,终于把MySql搭建好了.然后又去搭建Hive,又遇到了很多坑,就这 ...
- 入门大数据---Hive计算引擎Tez简介和使用
一.前言 Hive默认计算引擎时MR,为了提高计算速度,我们可以改为Tez引擎.至于为什么提高了计算速度,可以参考下图: 用Hive直接编写MR程序,假设有四个有依赖关系的MR作业,上图中,绿色是Re ...
- 入门大数据---Hive是什么?
这篇文章主要介绍Hive的概念. 简介: Hive中文名叫数据仓库管理系统,之前我们操作MapReduce必须通过编写代码或者通过特殊命令来实现,有了Hive我们通过常用的SQL语句就能操作MapRe ...
- 入门大数据---Hive分区表和分桶表
一.分区表 1.1 概念 Hive 中的表对应为 HDFS 上的指定目录,在查询数据时候,默认会对全表进行扫描,这样时间和性能的消耗都非常大. 分区为 HDFS 上表目录的子目录,数据按照分区存储在子 ...
- 入门大数据---Hive数据查询详解
一.数据准备 为了演示查询操作,这里需要预先创建三张表,并加载测试数据. 数据文件 emp.txt 和 dept.txt 可以从本仓库的resources 目录下载. 1.1 员工表 -- 建表语句 ...
- 入门大数据---SparkSQL常用聚合函数
一.简单聚合 1.1 数据准备 // 需要导入 spark sql 内置的函数包 import org.apache.spark.sql.functions._ val spark = SparkSe ...
随机推荐
- Rocket - diplomacy - resolveStar
https://mp.weixin.qq.com/s/W1cS9sgwLFjOOm86d05NIA 介绍各类型节点如何确定星型绑定所包含的连接数. 1. 定义 resoveSta ...
- 【HIVE】(1)建表、导入数据、外部表、导出数据
导入数据 1). 本地 load data local inpath "/root/example/hive/data/dept.txt" into table dept; 2). ...
- 使用turtle库画国际象棋棋盘
import turtle n = 60 # 每行间隔,小格子边长 x = -300 # x初始值 y = -300 # x初始值 def main(): turtle.speed(11) turtl ...
- Java实现 LeetCode 799 香槟塔 (暴力模拟)
799. 香槟塔 我们把玻璃杯摆成金字塔的形状,其中第一层有1个玻璃杯,第二层有2个,依次类推到第100层,每个玻璃杯(250ml)将盛有香槟. 从顶层的第一个玻璃杯开始倾倒一些香槟,当顶层的杯子满了 ...
- Java实现 LeetCode 14 最长公共前缀
14. 最长公共前缀 编写一个函数来查找字符串数组中的最长公共前缀. 如果不存在公共前缀,返回空字符串 "". 示例 1: 输入: ["flower",&quo ...
- Java实现蓝桥杯勾股定理
勾股定理,西方称为毕达哥拉斯定理,它所对应的三角形现在称为:直角三角形. 已知直角三角形的斜边是某个整数,并且要求另外两条边也必须是整数. 求满足这个条件的不同直角三角形的个数. [数据格式] 输入一 ...
- Java实现约瑟夫环问题
约瑟夫环问题起源于一个犹太故事.约瑟夫环问题的大意如下: 罗马人攻占了桥塔帕特,41个人藏在一个山洞中躲过了这场浩劫.这41个人中,包括历史学家Josephus(约瑟夫)和他的一个朋友.剩余的39个人 ...
- java实现罗马数字转十进制
古罗马帝国开创了辉煌的人类文明,但他们的数字表示法的确有些繁琐,尤其在表示大数的时候,现在看起来简直不能忍受,所以在现代很少使用了.之所以这样,不是因为发明表示法的人的智力的问题,而是因为一个宗教的原 ...
- java实现亲密数
假设有 a.b 两个数,若 a 的所有因子之和等于 b,b 的所有因子之和等于 a, 并且 a 不等于 b,则称 a 和 b 是一对亲密数.如 284 和 220 就是一对亲密数. 分析: 若要找出 ...
- KVM在线扩展虚拟机内存
环境介绍 在KVM下有一台虚拟机内存不够需要扩展内存.宿主机地址是192.168.1.28.我需要扩展的虚拟机是centos1708vm03. 1.登陆上宿主机查看虚拟机配置 virsh dumpxm ...