
Hive 系列(四)—— Hive 常用 DDL 操作
一、Database
1.1 查看数据列表
show databases;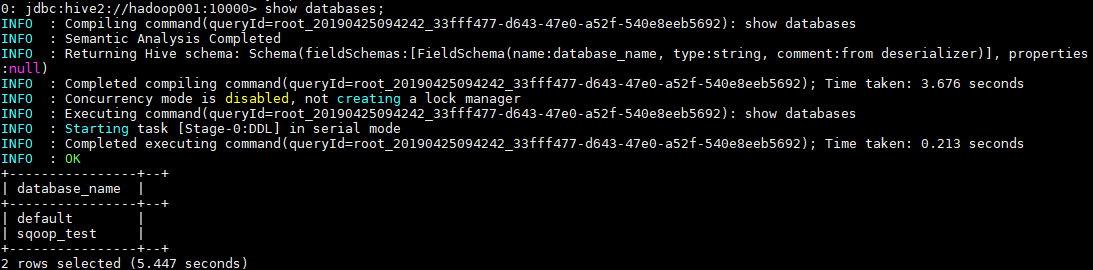
1.2 使用数据库
USE database_name;1.3 新建数据库
语法:
CREATE (DATABASE|SCHEMA) [IF NOT EXISTS] database_name   --DATABASE|SCHEMA 是等价的
  [COMMENT database_comment] --数据库注释
  [LOCATION hdfs_path] --存储在 HDFS 上的位置
  [WITH DBPROPERTIES (property_name=property_value, ...)]; --指定额外属性
示例:
CREATE DATABASE IF NOT EXISTS hive_test
  COMMENT 'hive database for test'
  WITH DBPROPERTIES ('create'='heibaiying');
1.4 查看数据库信息
语法:
DESC DATABASE [EXTENDED] db_name; --EXTENDED 表示是否显示额外属性示例:
DESC DATABASE EXTENDED hive_test;1.5 删除数据库
语法:
DROP (DATABASE|SCHEMA) [IF EXISTS] database_name [RESTRICT|CASCADE];- 默认行为是 RESTRICT,如果数据库中存在表则删除失败。要想删除库及其中的表,可以使用 CASCADE 级联删除。
示例:
DROP DATABASE IF EXISTS hive_test CASCADE;二、创建表
2.1 建表语法
CREATE [TEMPORARY] [EXTERNAL] TABLE [IF NOT EXISTS] [db_name.]table_name     --表名
  [(col_name data_type [COMMENT col_comment],
    ... [constraint_specification])]  --列名 列数据类型
  [COMMENT table_comment]   --表描述
  [PARTITIONED BY (col_name data_type [COMMENT col_comment], ...)]  --分区表分区规则
  [
    CLUSTERED BY (col_name, col_name, ...)
   [SORTED BY (col_name [ASC|DESC], ...)] INTO num_buckets BUCKETS
  ]  --分桶表分桶规则
  [SKEWED BY (col_name, col_name, ...) ON ((col_value, col_value, ...), (col_value, col_value, ...), ...)
   [STORED AS DIRECTORIES]
  ]  --指定倾斜列和值
  [
   [ROW FORMAT row_format]
   [STORED AS file_format]
     | STORED BY 'storage.handler.class.name' [WITH SERDEPROPERTIES (...)]
  ]  -- 指定行分隔符、存储文件格式或采用自定义存储格式
  [LOCATION hdfs_path]  -- 指定表的存储位置
  [TBLPROPERTIES (property_name=property_value, ...)]  --指定表的属性
  [AS select_statement];   --从查询结果创建表
2.2 内部表
  CREATE TABLE emp(
    empno INT,
    ename STRING,
    job STRING,
    mgr INT,
    hiredate TIMESTAMP,
    sal DECIMAL(7,2),
    comm DECIMAL(7,2),
    deptno INT)
    ROW FORMAT DELIMITED FIELDS TERMINATED BY "\t";
2.3 外部表
  CREATE EXTERNAL TABLE emp_external(
    empno INT,
    ename STRING,
    job STRING,
    mgr INT,
    hiredate TIMESTAMP,
    sal DECIMAL(7,2),
    comm DECIMAL(7,2),
    deptno INT)
    ROW FORMAT DELIMITED FIELDS TERMINATED BY "\t"
    LOCATION '/hive/emp_external';
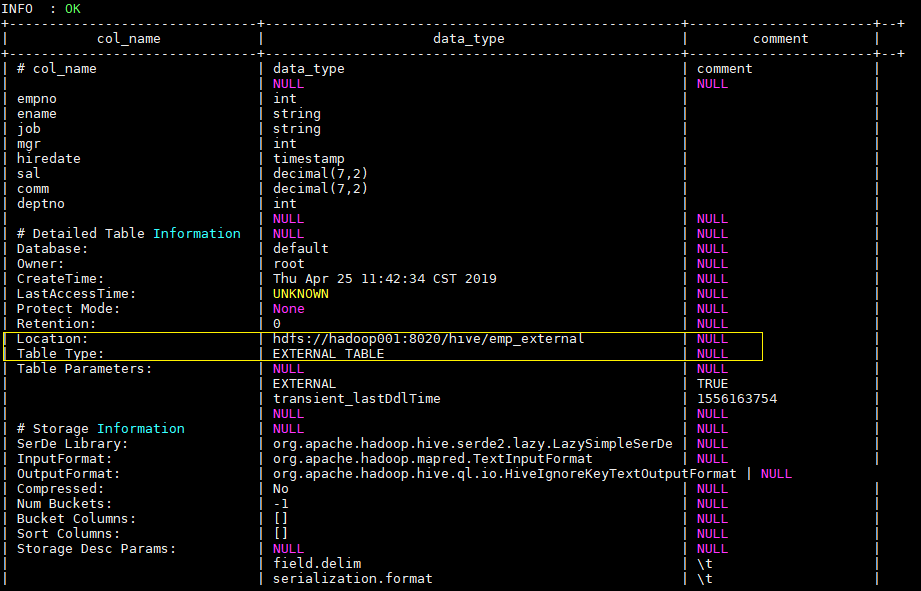
使用 desc format emp_external 命令可以查看表的详细信息如下:
2.4 分区表
  CREATE EXTERNAL TABLE emp_partition(
    empno INT,
    ename STRING,
    job STRING,
    mgr INT,
    hiredate TIMESTAMP,
    sal DECIMAL(7,2),
    comm DECIMAL(7,2)
    )
    PARTITIONED BY (deptno INT)   -- 按照部门编号进行分区
    ROW FORMAT DELIMITED FIELDS TERMINATED BY "\t"
    LOCATION '/hive/emp_partition';
2.5 分桶表
  CREATE EXTERNAL TABLE emp_bucket(
    empno INT,
    ename STRING,
    job STRING,
    mgr INT,
    hiredate TIMESTAMP,
    sal DECIMAL(7,2),
    comm DECIMAL(7,2),
    deptno INT)
    CLUSTERED BY(empno) SORTED BY(empno ASC) INTO 4 BUCKETS  --按照员工编号散列到四个 bucket 中
    ROW FORMAT DELIMITED FIELDS TERMINATED BY "\t"
    LOCATION '/hive/emp_bucket';
2.6 倾斜表
通过指定一个或者多个列经常出现的值(严重偏斜),Hive 会自动将涉及到这些值的数据拆分为单独的文件。在查询时,如果涉及到倾斜值,它就直接从独立文件中获取数据,而不是扫描所有文件,这使得性能得到提升。
  CREATE EXTERNAL TABLE emp_skewed(
    empno INT,
    ename STRING,
    job STRING,
    mgr INT,
    hiredate TIMESTAMP,
    sal DECIMAL(7,2),
    comm DECIMAL(7,2)
    )
    SKEWED BY (empno) ON (66,88,100)  --指定 empno 的倾斜值 66,88,100
    ROW FORMAT DELIMITED FIELDS TERMINATED BY "\t"
    LOCATION '/hive/emp_skewed';
2.7 临时表
临时表仅对当前 session 可见,临时表的数据将存储在用户的暂存目录中,并在会话结束后删除。如果临时表与永久表表名相同,则对该表名的任何引用都将解析为临时表,而不是永久表。临时表还具有以下两个限制:
- 不支持分区列;
- 不支持创建索引。
  CREATE TEMPORARY TABLE emp_temp(
    empno INT,
    ename STRING,
    job STRING,
    mgr INT,
    hiredate TIMESTAMP,
    sal DECIMAL(7,2),
    comm DECIMAL(7,2)
    )
    ROW FORMAT DELIMITED FIELDS TERMINATED BY "\t";
2.8 CTAS创建表
支持从查询语句的结果创建表:
CREATE TABLE emp_copy AS SELECT * FROM emp WHERE deptno='20';
2.9 复制表结构
语法:
CREATE [TEMPORARY] [EXTERNAL] TABLE [IF NOT EXISTS] [db_name.]table_name  --创建表表名
   LIKE existing_table_or_view_name  --被复制表的表名
   [LOCATION hdfs_path]; --存储位置
示例:
CREATE TEMPORARY EXTERNAL TABLE IF NOT EXISTS emp_co LIKE emp
2.10 加载数据到表
加载数据到表中属于 DML 操作,这里为了方便大家测试,先简单介绍一下加载本地数据到表中:
-- 加载数据到 emp 表中
load data local inpath "/usr/file/emp.txt" into table emp;
其中 emp.txt 的内容如下,你可以直接复制使用,也可以到本仓库的resources 目录下载:
7369    SMITH   CLERK   7902    1980-12-17 00:00:00 800.00      20
7499    ALLEN   SALESMAN    7698    1981-02-20 00:00:00 1600.00 300.00  30
7521    WARD    SALESMAN    7698    1981-02-22 00:00:00 1250.00 500.00  30
7566    JONES   MANAGER 7839    1981-04-02 00:00:00 2975.00     20
7654    MARTIN  SALESMAN    7698    1981-09-28 00:00:00 1250.00 1400.00 30
7698    BLAKE   MANAGER 7839    1981-05-01 00:00:00 2850.00     30
7782    CLARK   MANAGER 7839    1981-06-09 00:00:00 2450.00     10
7788    SCOTT   ANALYST 7566    1987-04-19 00:00:00 1500.00     20
7839    KING    PRESIDENT       1981-11-17 00:00:00 5000.00     10
7844    TURNER  SALESMAN    7698    1981-09-08 00:00:00 1500.00 0.00    30
7876    ADAMS   CLERK   7788    1987-05-23 00:00:00 1100.00     20
7900    JAMES   CLERK   7698    1981-12-03 00:00:00 950.00      30
7902    FORD    ANALYST 7566    1981-12-03 00:00:00 3000.00     20
7934    MILLER  CLERK   7782    1982-01-23 00:00:00 1300.00     10
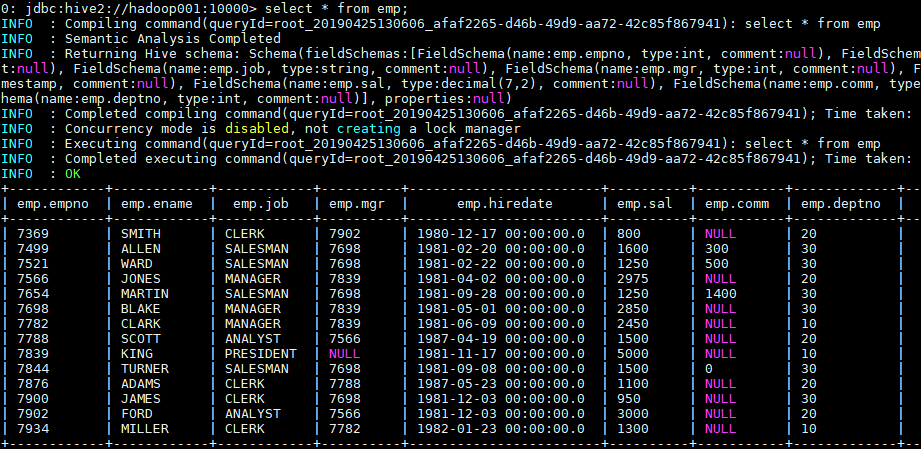
加载后可查询表中数据:
三、修改表
3.1 重命名表
语法:
ALTER TABLE table_name RENAME TO new_table_name;
示例:
ALTER TABLE emp_temp RENAME TO new_emp; --把 emp_temp 表重命名为 new_emp
3.2 修改列
语法:
ALTER TABLE table_name [PARTITION partition_spec] CHANGE [COLUMN] col_old_name col_new_name column_type
  [COMMENT col_comment] [FIRST|AFTER column_name] [CASCADE|RESTRICT];
示例:
-- 修改字段名和类型
ALTER TABLE emp_temp CHANGE empno empno_new INT;

-- 修改字段 sal 的名称 并将其放置到 empno 字段后
ALTER TABLE emp_temp CHANGE sal sal_new decimal(7,2)  AFTER ename;

-- 为字段增加注释
ALTER TABLE emp_temp CHANGE mgr mgr_new INT COMMENT 'this is column mgr';
3.3 新增列
示例:
ALTER TABLE emp_temp ADD COLUMNS (address STRING COMMENT 'home address');
四、清空表/删除表
4.1 清空表
语法:
-- 清空整个表或表指定分区中的数据
TRUNCATE TABLE table_name [PARTITION (partition_column = partition_col_value,  ...)];
- 目前只有内部表才能执行 TRUNCATE 操作,外部表执行时会抛出异常
Cannot truncate non-managed table XXXX。
示例:
TRUNCATE TABLE emp_mgt_ptn PARTITION (deptno=20);
4.2 删除表
语法:
DROP TABLE [IF EXISTS] table_name [PURGE];
- 内部表:不仅会删除表的元数据,同时会删除 HDFS 上的数据;
- 外部表:只会删除表的元数据,不会删除 HDFS 上的数据;
- 删除视图引用的表时,不会给出警告(但视图已经无效了,必须由用户删除或重新创建)。
五、其他命令
5.1 Describe
查看数据库:
DESCRIBE|Desc DATABASE [EXTENDED] db_name; --EXTENDED 是否显示额外属性
查看表:
DESCRIBE|Desc [EXTENDED|FORMATTED] table_name --FORMATTED 以友好的展现方式查看表详情
5.2 Show
1. 查看数据库列表
-- 语法
SHOW (DATABASES|SCHEMAS) [LIKE 'identifier_with_wildcards'];

-- 示例:
SHOW DATABASES like 'hive*';
LIKE 子句允许使用正则表达式进行过滤,但是 SHOW 语句当中的 LIKE 子句只支持 *(通配符)和 |(条件或)两个符号。例如 employees,emp *,emp * | * ees,所有这些都将匹配名为 employees 的数据库。
2. 查看表的列表
-- 语法
SHOW TABLES [IN database_name] ['identifier_with_wildcards'];

-- 示例
SHOW TABLES IN default;
3. 查看视图列表
SHOW VIEWS [IN/FROM database_name] [LIKE 'pattern_with_wildcards']; --仅支持 Hive 2.2.0 +
4. 查看表的分区列表
SHOW PARTITIONS table_name;
5. 查看表/视图的创建语句
SHOW CREATE TABLE ([db_name.]table_name|view_name);
参考资料
更多大数据系列文章可以参见 GitHub 开源项目: 大数据入门指南
Hive 系列(四)—— Hive 常用 DDL 操作的更多相关文章
- Hive 学习之路(四)—— Hive 常用DDL操作
一.Database 1.1 查看数据列表 show databases; 1.2 使用数据库 USE database_name; 1.3 新建数据库 语法: CREATE (DATABASE|SC ...
- 入门大数据---Hive常用DDL操作
一.Database 1.1 查看数据列表 show databases; 1.2 使用数据库 USE database_name; 1.3 新建数据库 语法: CREATE (DATABASE|SC ...
- 大数据学习——hive数仓DML和DDL操作
1 创建一个分区表 create table t_partition001(ip string,duration int) partitioned by(country string) row for ...
- hive学习(四) hive的函数
1.内置运算符 1.1关系运算符 运算符 类型 说明 A = B 所有原始类型 如果A与B相等,返回TRUE,否则返回FALSE A == B 无 失败,因为无效的语法. SQL使用”=”,不使用”= ...
- 入门大数据---Hive常用DML操作
Hive 常用DML操作 一.加载文件数据到表 1.1 语法 LOAD DATA [LOCAL] INPATH 'filepath' [OVERWRITE] INTO TABLE tablename ...
- Hive数据类型和DDL操作
hive命令 在Linux下的命令行中直接输入如下命令,可以查看帮助信息: # hive -help 常用的如-e.-f参数. 使用-e参数,可以直接在命令行传递SQL语句进行hive表数据的查询: ...
- 闯祸了,生成环境执行了DDL操作《死磕MySQL系列 十四》
由于业务随着时间不停的改变,起初的表结构设计已经满足不了如今的需求,这时你是不是想那就加字段呗!加字段也是个艺术活,接下来由本文的主人咔咔给你吹. 试想一下这个场景 事务A在执行一个非常大的查询 事务 ...
- Hive的DDL操作
DDL:data definittion language 数据定义语言 主要是定义或改变表的结构.数据类型.表之间的链接和约束等初始化操作 DML:data manipulation languag ...
- HBASE与hive对比使用以及HBASE常用shell操作。与sqoop的集成
2.6.与 Hive 的集成2.6.1.HBase 与 Hive 的对比1) Hive(1) 数据仓库Hive 的本质其实就相当于将 HDFS 中已经存储的文件在 Mysql 中做了一个双射关系,以方 ...
随机推荐
- springcloud入门系列
关于springcloud 1.写在前面 写着写这,不知不觉springcloud写了7,8篇了,今天把文章分下类,写下感受及后面的计划吧. (1)springcloud中最最重要的是eureka注册 ...
- R035---偷个懒,用UiPath录制电脑操作过程,迅速实现流程自动化
一.缘起 UiPath可以录制你操作电脑的过程,从而实现自动化. 目前有点鸡肋,因为有些操作过程无法录制,例如: 键盘快捷键 修改键 右键点击 鼠标悬停 即便如此,录制功能有时候还是可以用一下,特别 ...
- .netcore微服务-Mycat
1.前言 1.1 分布式数据库 随着IT行业的迅猛发展,行业应用系统的数据规模呈现爆炸式增长,对数据库的数据处理能力要求越来越高,分布式数据库正是因此应运而生. 分布式数据库特点包括: 透明性: ...
- Excel催化剂开源第26波-Excel离线生成二维码条形码
在中国特有环境下,二维码.条形码的使用场景非常广泛,因Excel本身就是一个非常不错的报表生成环境,若Excel上能够直接生成二维码.条形码,且是批量化操作的,直接一条龙从数据到报表都由Excel完成 ...
- kubernetes的volume的权限设置(属主和属组)
apiVersion: v1kind: Podmetadata: name: hello-worldspec: containers: # specification of the pod's c ...
- JS+Jquery自定义格式导出HTML为Word(下列插件同样可以用于Excel导出)
这里的word导出主要采用了jquery.wordexport.js.FileSaver.js,做功能之前我也是找了很多网上的资料,里面涉及到js导出word的用的都是这个插件,只是在自定义样式这一块 ...
- sqlserver 2008 无法使用特殊主体‘sa’,错误15405
今天莫名其妙的遇到一个问题,还原了几个数据库到新的服务器上,突然发现sa用户对某几个数据库没有权限(用户映射): 我手工勾选相应数据库的db_owner权限之后,报错:无法使用特殊主体'sa',错误1 ...
- vue教程(二)--过滤器和监视改动功能
过滤器filter: 1.将数据进行添油加醋的操作. 2.过滤器分两种: 组件内的过滤器(组件内有效). 全局过滤器 组件内:filters:{过滤器名:过滤器函数fn},fn内通过return 返回 ...
- 基于kubernetes自研容器管理平台的技术实践
一.容器云的背景 伴随着微服务的架构的普及,结合开源的Dubbo和Spring Cloud等微服务框架,宜信内部很多业务线逐渐了从原来的单体架构逐渐转移到微服务架构.应用从有状态到无状态,具体来说将业 ...
- 「玩转Python」打造十万博文爬虫篇
前言 这里以爬取博客园文章为例,仅供学习参考,某些AD满天飞的网站太浪费爬虫的感情了. 爬取 使用 BeautifulSoup 获取博文 通过 html2text 将 Html 转 Markdown ...