
Hadoop基础------>MR框架-->WordCount
认识Mapreduce
Mapreduce编程思想
Mapreduce执行流程
java版本WordCount实例
1. 简介:
Mapreduce源于Google一遍论文,是谷歌Mapreduce的克隆版,他充分借鉴了分而治之的思想,讲一个数据处理过程拆分为主要的Map(映射)和Reduce(归并)两步,只需要编写map函数和reduce函数即可。
2. Mapreduce优势:
分布式带来了三个复杂:1.程序的分布和启动
2.任务的监控和失败处理
3.中间数据的缓存和调度
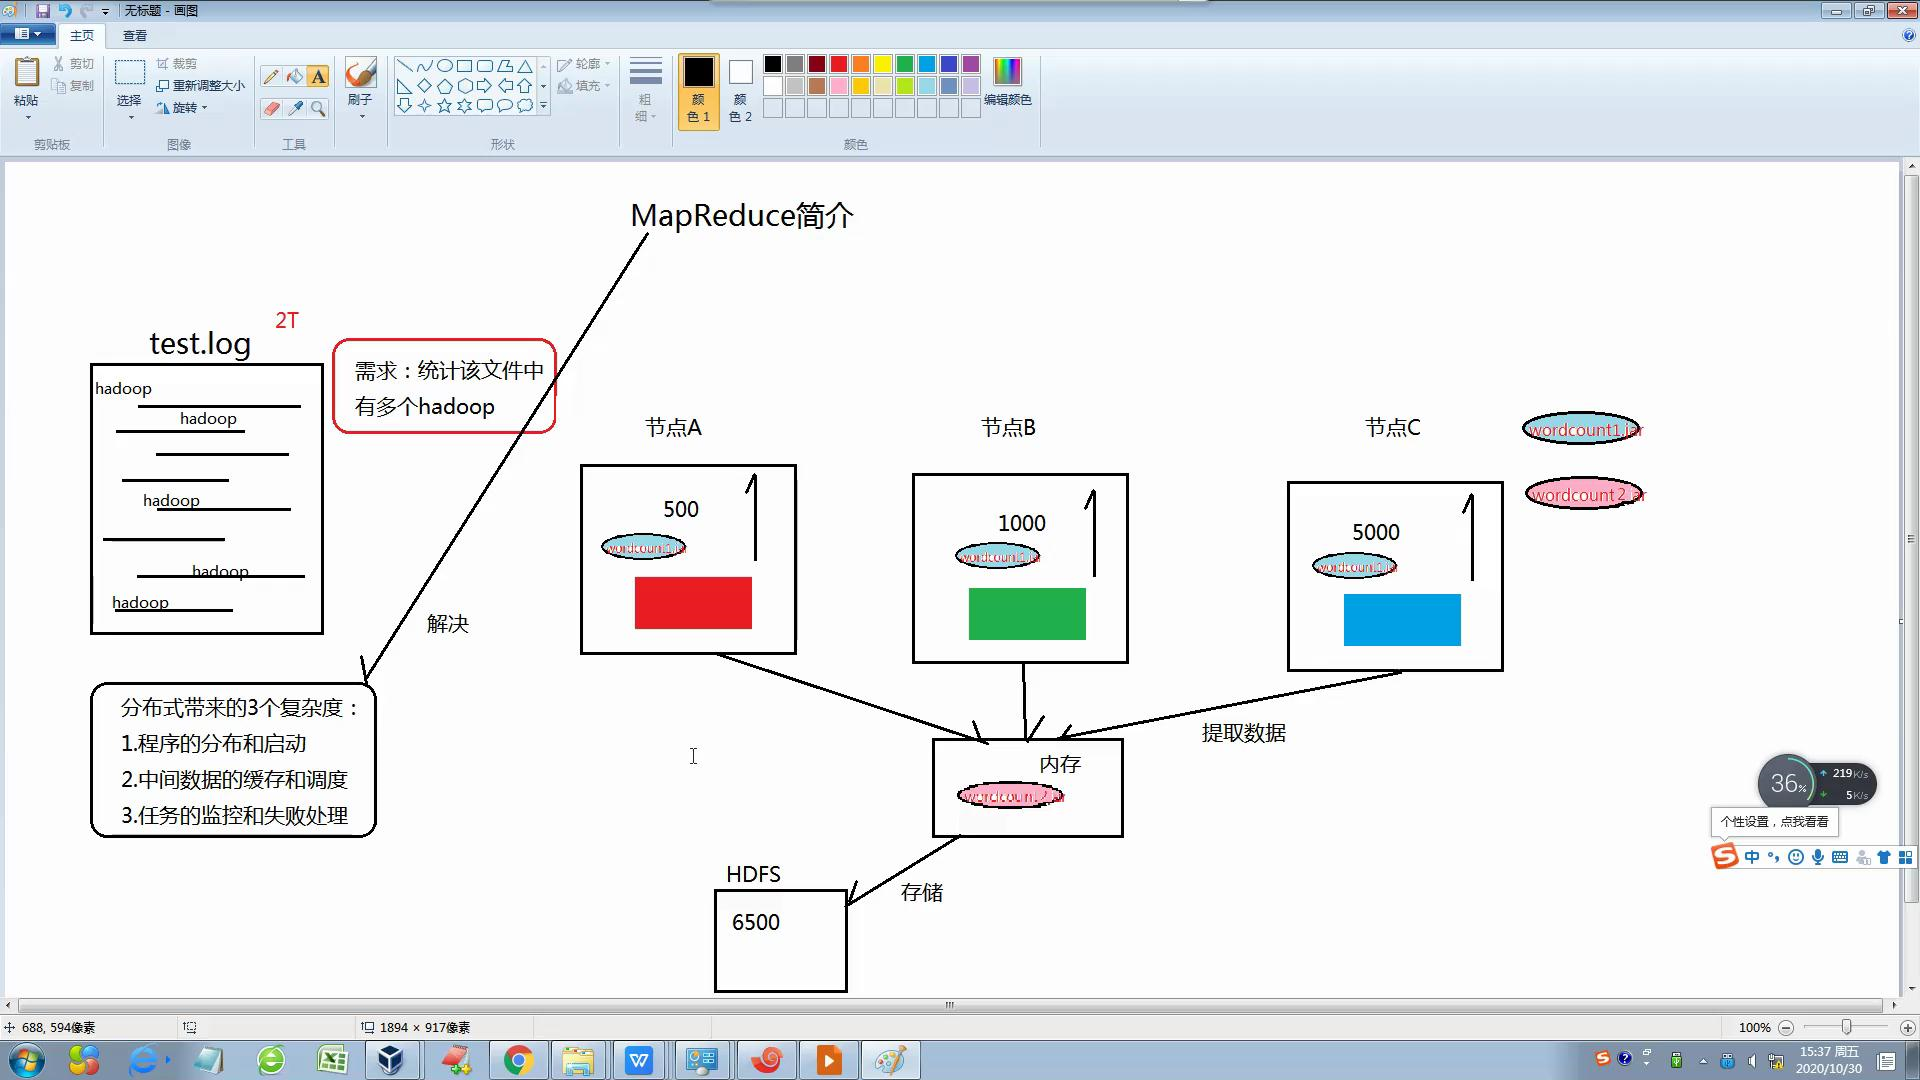
然后Mapreduce是一个并行程序设计模型与方法和好的解决了以上的缺点,并具有:1开发简单
2可扩展性强
3.容错性强
3 Mapreduce的执行流程图:

3-2 Mapreduce的实现过程图:
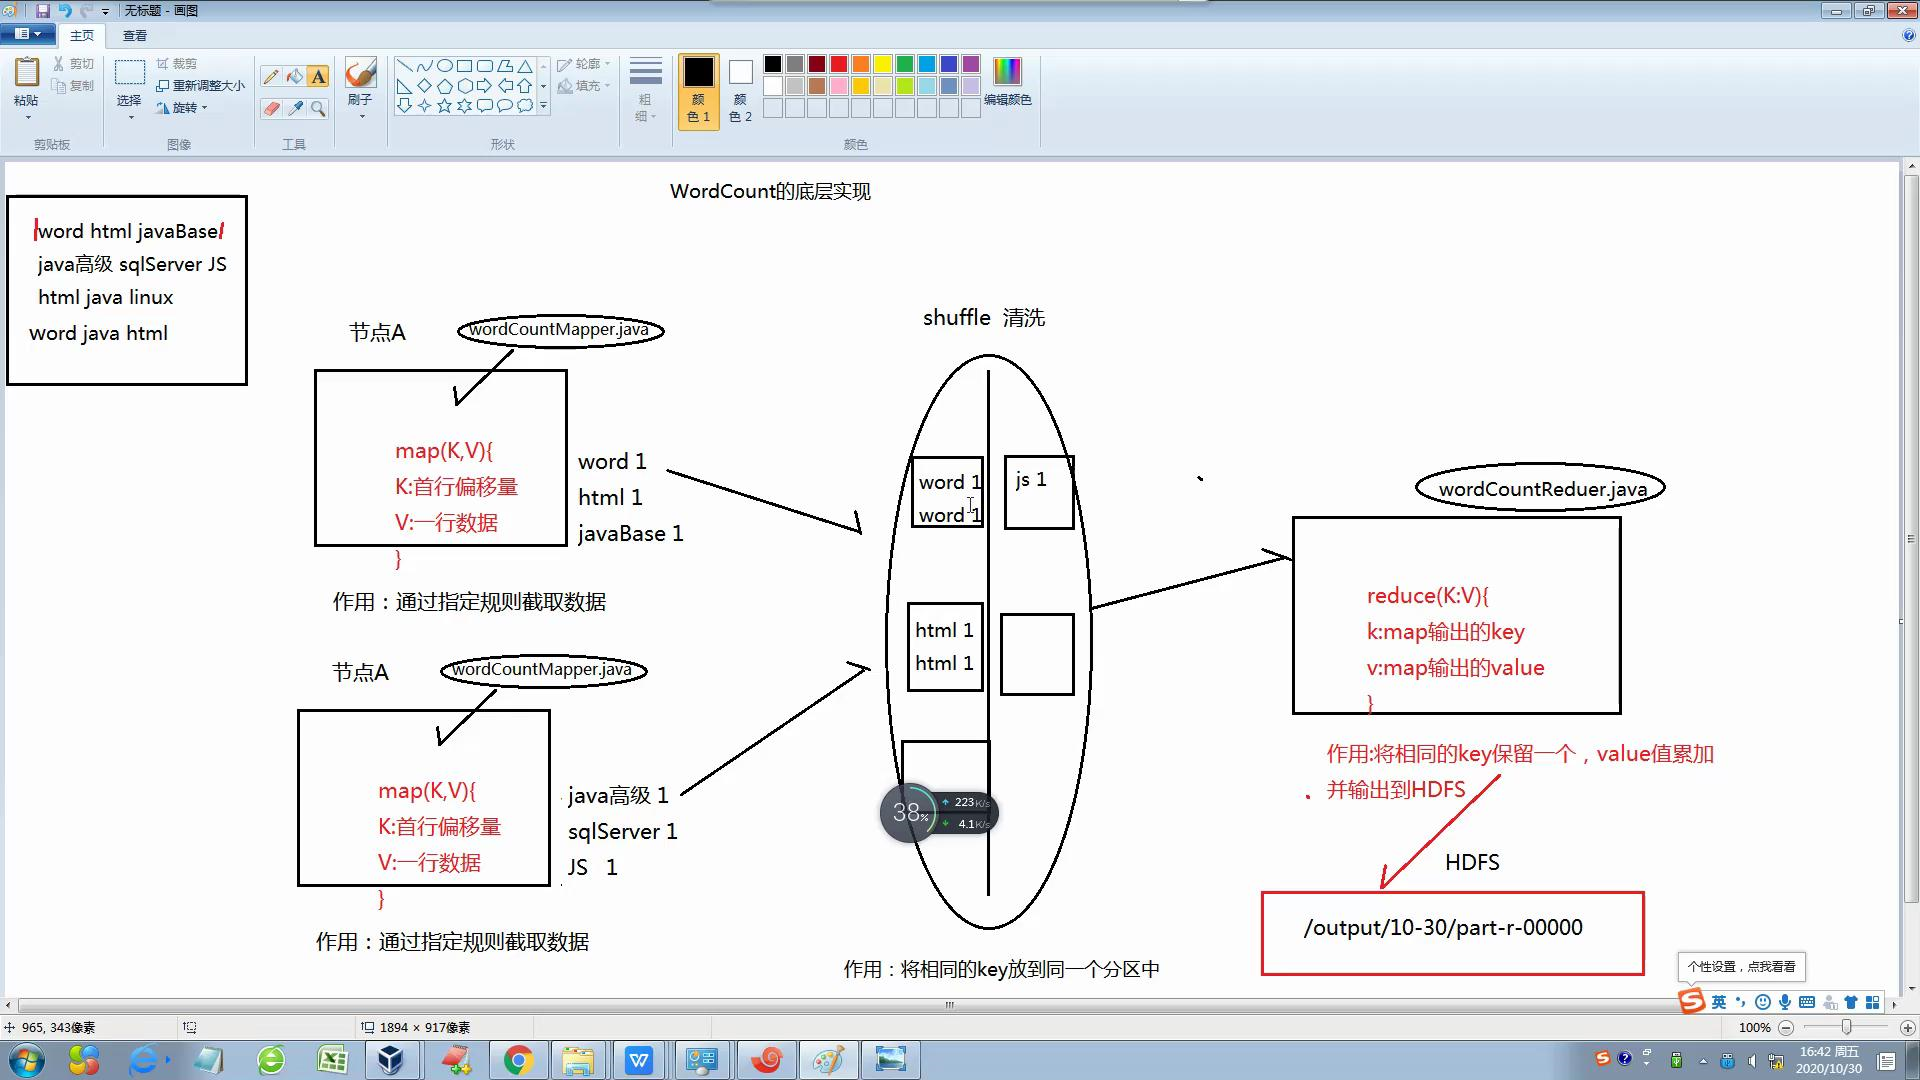
4 基层案例:
- 开发步骤:
- 1.新建项目导入所需的jar包
- 2.编写Mapper类
- 3.编写Reduce类
- 4.提交任务
- 5.观察结果
4-1 Mapper类:继承Mapper类重写map方法在父类中需要定义个泛型,含别4个设置,分别是:KEYIN,VALUEIN,KEYOUT,VALUEOUT
- KEYIN:读入每行文件开头的偏移量(首行偏移量)
- VALUEIN:读入每行文件内容的类型
- KEYOUT:表示Mapper完毕后,输出的文件作为KEY的数据类型
- VALUEOUT:表示Mapper完毕后,输出的文件作为VALUE的数据类型
执行流程:
- 读取一行数据
- 按照规则截取
- 获取有效数据
- 将数据写到上下文中
实例:
public class WordCount {

static class WordCountMapper extends Mapper<LongWritable, Text, Text, IntWritable>{

        @Override

        protected void map(LongWritable key, Text value, Mapper<LongWritable, Text, Text, IntWritable>.Context context)

                throws IOException, InterruptedException {

            //读取一行数据

            String line = value.toString();

            //根据指定规则截取数据

            String [] words = line.split(" ");

            //获取有效数据

            for (int i = 0; i < words.length; i++) {

                //将数据写入上下文

                context.write(new Text(words[i]), new IntWritable(1));

            }

        }

    }

}
4-2 Reduce类:在写的时候需要继承Reducer类重写ducer方法在父类中需要定义个泛型,含别4个设置,分别是:KEYIN,VALUEIN,KEYOUT,VALUEOUT
- KEYIN:表示从mapper中传递过来的key的数据的数据类型
- VALUEIN:表示从mapper中传递过来的value的数据的数据类型
- KEYOUT:表示Reducer完毕后,输出的文件作为KEY的数据类型
- VALUEOUT:表示Reducer完毕后,输出的文件作为VAKUE的数据类型
执行流程:
- 定义一个空的变量来接受定义的值(累加器)
- 遍历values集合,累加统计
- 将结果写入上下文中
实例:
static class WordCountReducer extends Reducer<Text, IntWritable, Text, IntWritable>{

        @Override

        protected void reduce(Text key, Iterable<IntWritable> values,

                Reducer<Text, IntWritable, Text, IntWritable>.Context context) throws IOException, InterruptedException {

            //定义空变量

            int i = 0 ;

            //遍历values集合,累加统计

            for (IntWritable value : values) {

                i += value.get();

            }

            //写入上下文

            context.write(key, new IntWritable(i));

        }

    }
4-3 提交类编写流程:
- 创建Configuration
- 准备清理已存在的输出目录
- 创建Jop
- 设置job的提交类
- 设置mapper相关的类和参数
- 设置reduce相关的类和参数
- 提交任务
实例:
public static void main(String[] args) throws Exception {

        //加载配置文件

        Configuration config = new Configuration();

        //创建job对象

        Job job = Job.getInstance(config);

        //设置提交主类

        job.setJarByClass(wordCountApp.class);

        //设置mapper相关设置提交主类

        job.setMapperClass(WordCountMapper.class);

        job.setMapOutputKeyClass(Text.class);

        job.setMapOutputValueClass(IntWritable.class);

        //设置reducer相关

        job.setReducerClass(WordCountReducer.class);

        job.setOutputKeyClass(Text.class);

        job.setOutputValueClass(IntWritable.class);

        //设置输入路径(必须存在hdfs上)

        FileInputFormat.setInputPaths(job, new Path("/score.txt"));

        //设置输出路径

        FileOutputFormat.setOutputPath(job, new Path("/ouput10"));

        //提交任务

        job.waitForCompletion(true);

    }
使用eclipse导出架包,并通关传输软件到LinuX上最后完成上传
Hadoop基础------>MR框架-->WordCount的更多相关文章
- Hadoop基础学习框架
我们主要使用Hadoop的2个部分:分布式文件存储系统(HDFS)和MapReduce计算模型. 关于这2个部分,可以参考一下Google的论文:The Google File System 和 Ma ...
- hadoop之mr框架的源码理解注意点
1.reduce源码中的 GroupComparable和SecondaryComparable到底都是干什么的 理解点1: 源码位置 理解点 secondaryComparable这个是可以对map ...
- Hadoop基础-MapReduce入门篇之编写简单的Wordcount测试代码
Hadoop基础-MapReduce入门篇之编写简单的Wordcount测试代码 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 本文主要是记录一写我在学习MapReduce时的一些 ...
- Hadoop基础-配置历史服务器
Hadoop基础-配置历史服务器 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. Hadoop自带了一个历史服务器,可以通过历史服务器查看已经运行完的Mapreduce作业记录,比 ...
- Hadoop基础-MapReduce的工作原理第一弹
Hadoop基础-MapReduce的工作原理第一弹 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 在本篇博客中,我们将深入学习Hadoop中的MapReduce工作机制,这些知识 ...
- Hadoop基础-MapReduce的常用文件格式介绍
Hadoop基础-MapReduce的常用文件格式介绍 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.MR文件格式-SequenceFile 1>.生成SequenceF ...
- Hadoop基础原理
Hadoop基础原理 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 业内有这么一句话说:云计算可能改变了整个传统IT产业的基础架构,而大数据处理,尤其像Hadoop组件这样的技术出 ...
- Hadoop【MR开发规范、序列化】
Hadoop[MR开发规范.序列化] 目录 Hadoop[MR开发规范.序列化] 一.MapReduce编程规范 1.Mapper阶段 2.Reducer阶段 3.Driver阶段 二.WordCou ...
- Hadoop MapReduceV2(Yarn) 框架简介[转]
对于业界的大数据存储及分布式处理系统来说,Hadoop 是耳熟能详的卓越开源分布式文件存储及处理框架,对于 Hadoop 框架的介绍在此不再累述,读者可参考 Hadoop 官方简介.使用和学习过老 H ...
随机推荐
- nginx 1.12安装
准备工作 使用root用户安装. 到nginx官网下载Linux源码或者执行:wget http://nginx.org/download/nginx-1.12.2.tar.gz. 到pcre站点下载 ...
- Centos-本机网络连接、运行端口和路由表等信息-netstat
netstat 网络状态,显示本机网络连接.运行端口和路由表等信息 相关选项 -a 显示本机所有连接和监听端口 -n 以网络IP地址形式显示当前建立的有效连接和端口 -r 显示路由表信息 -t 显示T ...
- Centos-zip压缩-文件或目录-zip unzip
zip uzip 将一般文件或者目录进行压缩或者解压,默认以 .zip为后缀名 zip 相关选项 -r 递归压缩目录 -d 从压缩包中删除指定文件 -i 压缩指定文件列表文件 -x 压缩排除指定文件 ...
- OneWire总线的Arduino库函数
OneWire总线基本点 One-wire总线是DALLAS公司研制开发的一种协议,采用单根信号线,既传输时钟,又传输数据而且数据传输是双向的.它具有节省I/O 口线资源.结构简单.成本低廉.便于总线 ...
- P4231 三步必杀
题目描述 问题摘要: N个柱子排成一排,一开始每个柱子损伤度为0. 接下来勇仪会进行M次攻击,每次攻击可以用4个参数l,r,s,e来描述: 表示这次攻击作用范围为第l个到第r个之间所有的柱子(包含l, ...
- Linux系统编程—管道
▋****1. 管道的概念 管道,又名「无名管理」,或「匿名管道」,管道是一种非常基本,也是使用非常频繁的IPC方式. 1.1 管道本质 管道的本质也是一种文件,不过是伪文件,实际上是一块内核缓冲区, ...
- Linux配置Docker
Centos6.8 1.查看自己的内核 [1].uname [root@host79 ~]# uname -r 2.6.32-642.el6.x86_64 [2].查看CentOS版本信息 CentO ...
- .net core中的那些常用的日志框架(NLog篇)
前言 咱们上回讲到,.net core中内置的Logging日志框架的使用,以及浅显的讲解,接下来,给大家介绍一个第三方日志框架(NLog). NLog简介 NLog是适用于各种.NET平台(包括.N ...
- JDK1.8源码安装
JDK1.8源码安装 一.先卸载openjdk #查找已安装的版本,若是没有结果,就表示没安装rpm -qa|grep jdkrpm -qa|grep java#有的话卸载 --nodeps卸载相关依 ...
- Dubbo的负载均衡策略&容错策略
dubbo的负载均衡策略 RandomLoadBalance 随机调用负载均衡 默认方式该类实现了抽象的AbstractLoadBalance接口,重写了doSelect方法,看方法的细节就是首先遍历 ...