
Python-用xlrd模块读取excel,数字都是浮点型,日期格式是数字的解决办法
excel文件内容:
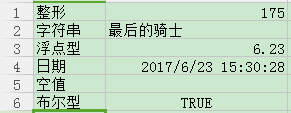
读取excel:

# coding=utf-8

import xlrd

import sys

reload(sys)

sys.setdefaultencoding('utf-8')

import traceback

class excelHandle:

    def decode(self, filename, sheetname):

        try:

            filename = filename.decode('utf-8')

            sheetname = sheetname.decode('utf-8')

        except Exception:

            print traceback.print_exc()

        return filename, sheetname

    def read_excel(self, filename, sheetname):

        filename, sheetname = self.decode(filename, sheetname)

        rbook = xlrd.open_workbook(filename)

        sheet = rbook.sheet_by_name(sheetname)

        rows = sheet.nrows

        cols = sheet.ncols

        all_content = []

        for i in range(rows):

            row_content = []

            for j in range(cols):

                cell = sheet.cell_value(i, j)

                row_content.append(cell)

            all_content.append(row_content)

            print '[' + ','.join("'" + str(element) + "'" for element in row_content) + ']'

        return all_content

if __name__ == '__main__':

    eh = excelHandle()

    filename = r'G:\test\ctype.xls'

    sheetname = 'Sheet1'

    eh.read_excel(filename, sheetname)
输出:
['整形','175.0']

['字符串','最后的骑士']

['浮点型','6.23']

['日期','42909.6461574']

['空值','']

['布尔型','1']
可以看到,数字一律按浮点型输出,日期却输出成一串小数?!布尔型输出0或1
代码稍做改动:来看一看表格的数据类型
for i in range(rows):
row_content = []
for j in range(cols):
ctype = sheet.cell(i, j).ctype #表格的数据类型
print ctype,
cell = sheet.cell_value(i, j)
row_content.append(cell)
all_content.append(row_content)
print '[' + ','.join("'" + str(element) + "'" for element in row_content) + ']'
输出:
1 2

['整形','175.0']

1 1

['字符串','最后的骑士']

1 2

['浮点型','6.23']

1 3

['日期','42909.6461574']

1 0

['空值','']

1 4

['布尔型','1']
python读取excel中单元格的内容返回的有5种类型,即上面例子中的ctype:
ctype: 0 empty,1 string, 2 number, 3 date, 4 boolean, 5 error
所以,判断一下ctype,然后再做相应处理就可以了。
最终代码:
# coding=utf-8

import xlrd

import sys

reload(sys)

sys.setdefaultencoding('utf-8')

import traceback

from datetime import datetime

from xlrd import xldate_as_tuple

class excelHandle:

    def decode(self, filename, sheetname):

        try:

            filename = filename.decode('utf-8')

            sheetname = sheetname.decode('utf-8')

        except Exception:

            print traceback.print_exc()

        return filename, sheetname

    def read_excel(self, filename, sheetname):

        filename, sheetname = self.decode(filename, sheetname)

        rbook = xlrd.open_workbook(filename)

        sheet = rbook.sheet_by_name(sheetname)

        rows = sheet.nrows

        cols = sheet.ncols

        all_content = []

        for i in range(rows):

            row_content = []

            for j in range(cols):

                ctype = sheet.cell(i, j).ctype  # 表格的数据类型

                cell = sheet.cell_value(i, j)

                if ctype == 2 and cell % 1 == 0:  # 如果是整形

                    cell = int(cell)

                elif ctype == 3:

                    # 转成datetime对象

                    date = datetime(*xldate_as_tuple(cell, 0))

                    cell = date.strftime('%Y/%d/%m %H:%M:%S')

                elif ctype == 4:

                    cell = True if cell == 1 else False

                row_content.append(cell)

            all_content.append(row_content)

            print '[' + ','.join("'" + str(element) + "'" for element in row_content) + ']'

        return all_content

if __name__ == '__main__':

    eh = excelHandle()

    filename = r'G:\test\ctype.xls'

    sheetname = 'Sheet1'

    eh.read_excel(filename, sheetname)
输出:
['整形','175']

['字符串','最后的骑士']

['浮点型','6.23']

['日期','2017/23/06 15:30:28']

['空值','']

['布尔型','True']
Python-用xlrd模块读取excel,数字都是浮点型,日期格式是数字的解决办法的更多相关文章
- python使用xlrd模块读写Excel文件的方法
本文实例讲述了python使用xlrd模块读写Excel文件的方法.分享给大家供大家参考.具体如下: 一.安装xlrd模块 到python官网下载http://pypi.python.org/pypi ...
- Python xlrd模块读取Excel表中的数据
1.xlrd库的安装 直接使用pip工具进行安装(当然也可以使用pycharmIDE进行安装,这里就不详述了) pip install xlrd 2.xlrd模块的一些常用命令 ①打开excel文件并 ...
- Xlrd模块读取Excel文件数据
Xlrd模块使用 excel文件样例:
- 常用方法 读取 Excel的单位格 为 日期格式 的数据
原文:地址忘了 百度应该有 Excel的单元格为日期格式,数值型日期,可用下面这个方法得到正常的数据 /// <summary> /// 数字格式的时间 转换为 字符串格式的时间 /// ...
- python 利用三方的xlrd模块读取excel文件,处理合并单元格
目的: python能使用xlrd模块实现对Excel数据的读取,且按照想要的输出形式. 总体思路: (1)要想实现对Excel数据的读取,需要用到第三方应用,直接应用. (2)实际操作时候和我 ...
- python使用xlrd模块读写excel
1.行列索引均从0开始2.int数据被读成float数据,解决办法,if type(value) == float and value%1 == 0,value= int(value)模块读 #!/u ...
- 基础补充:使用xlrd模块读取excel文件
因为接口测试用例使用excel文件来维护的,所以有必要学习下操作excel的基本方法 参考博客:python 3 操作 excel 把自己练习的代码贴出来,是一些基本的操作,每行代码后面都加了注释. ...
- 利用xlrd模块读取excel利用json模块生成相应的json文件的脚本
excel的格式如下 python代码如下,这里最难的就是合并单元格的处理 import xlrd import json excel_obj = xlrd.open_workbook("t ...
- Python之xlrd模块读取xls文件与报错解决
安装 pip3 install xlrd 用法 Sheet编号从0开始 rows,colnum编号均从0开始 合并的单元格仅返回第一格内容 Sheets只能被调用一次,可获取所有sheet取idx 无 ...
- python-利用xlrd模块读取excel数据,将excel数据转换成字典格式
前言 excel测试案例数据 转换成这种格式 实现代码 import os import xlrd excel_path = '..\data\\test_case.xlsx' data_path = ...
随机推荐
- Python内存管理机制-《源码解析》
Python内存管理机制 Python 内存管理分层架构 /* An object allocator for Python. Here is an introduction to the layer ...
- Python子类构造函数调用super().__init__()用法说明
一.super的作用 1.如果子类(Puple)继承父类(Person)不做初始化,那么会自动继承父类(Person)属性name.2.如果子类(Puple_Init)继承父类(Person)做了初始 ...
- 如何通过AzureAD平台提供的授权方式访问sharepoint online
官方文档: 1.https://docs.microsoft.com/zh-cn/previous-versions/azure/dn645543(v=azure.100)?redirectedfro ...
- Python常用推导式
列表推导式: #列表推导式 #基本格式[] # 变量 = [for循环的变量 for循环一个可迭代对象] # 变量 = [i for i in 可迭代对象 if 条件] 条件为true才进行appen ...
- Hive中row_number()、dense_rank()、rank()的区别
摘要 本文对Hive中常用的三个排序函数row_number().dense_rank().rank()的特性进行类比和总结,并通过笔者亲自动手写的一个小实验,直观展现这三个函数的特点. 三个排序函数 ...
- List集合排序的方法
1.list集合中的对象实现Comparable接口 public class User implements Comparable<User>{ private Integer id; ...
- pc端网站如何自动跳转到移动wap端网站
<script type="text/javascript"> var uaTest = /Android|webOS|Windows Phone|iPhone|ucw ...
- Springboot拦截器实现IP黑名单
Springboot拦截器实现IP黑名单 一·业务场景和需要实现的功能 以redis作为IP存储地址实现. 业务场景:针对秒杀活动或者常规电商业务场景等,防止恶意脚本不停的刷接口. 实现功能:写一个拦 ...
- ca76a_c++_流文件打开输入输出文件模式p773
/*ca76a_c++_流文件打开输入输出文件模式利用文件流打开文件进行输入与输出时的选项in.out.app(附加模式).ate((end)文件打开后,定于文件结尾).trunc(裁剪).binar ...
- 深入理解React:事件机制原理
目录 序言 DOM事件流 事件捕获阶段.处于目标阶段.事件冒泡阶段 addEventListener 方法 React 事件概述 事件注册 document 上注册 回调函数存储 事件分发 小结 参考 ...