
大数据系列之Flume+HDFS
本文将介绍Flume(Spooling Directory Source) + HDFS,关于Flume 中几种Source详见文章 http://www.cnblogs.com/cnmenglang/p/6544081.html
1.资料准备 : apache-flume-1.7.0-bin.tar.gz
2.配置步骤:
a.上传至用户(LZ用户mfz)目录resources下
b.解压
tar -xzvf apache-flume-1.7.-bin.tar.gz
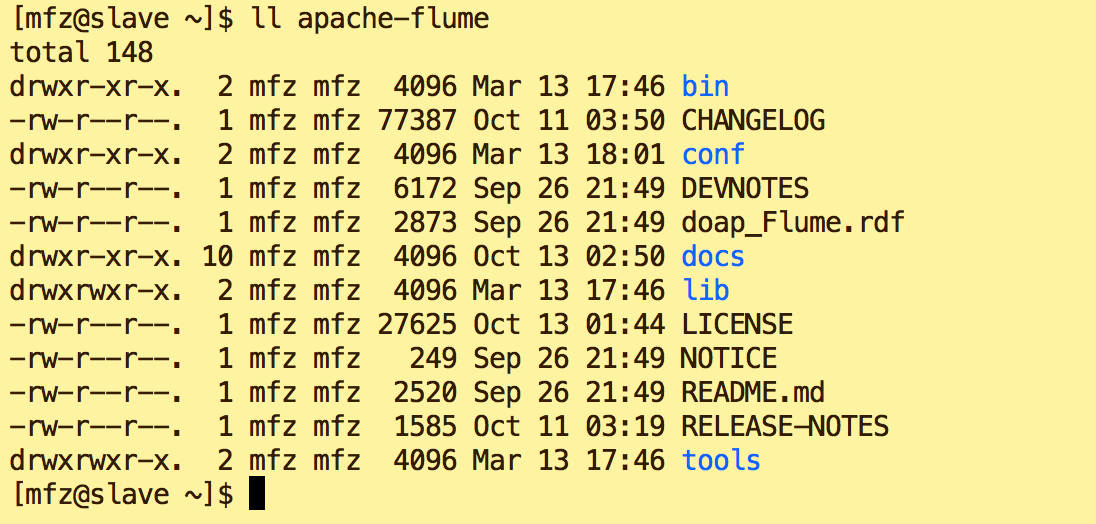
c.修改conf下 文件名
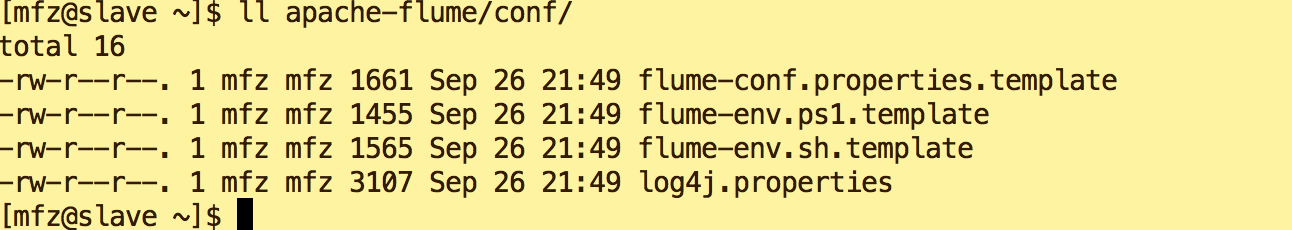
mv flume-conf.properties.template flume-conf.properties

mv flume-env.sh.template flume-env.sh
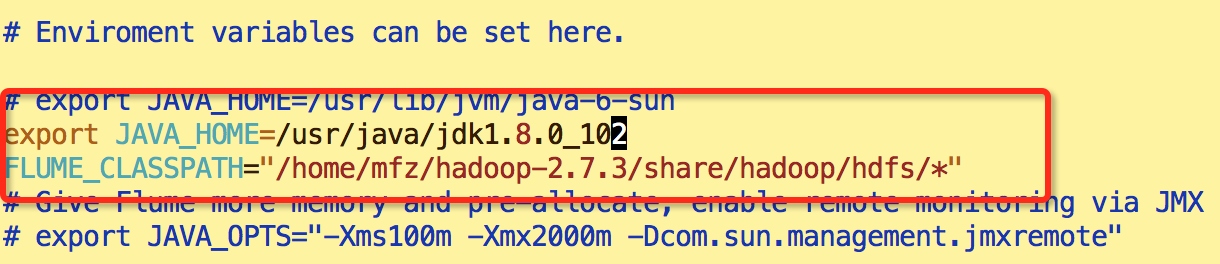
d.修改flume-env.sh 环境变量,添加如下:
export JAVA_HOME=/usr/java/jdk1.8.0_102

FLUME_CLASSPATH="/home/mfz/hadoop-2.7.3/share/hadoop/hdfs/*"
e.新增文件 hdfs.properties
LogAgent.sources = apache

LogAgent.channels = fileChannel

LogAgent.sinks = HDFS

#sources config

#spooldir 对监控指定文件夹中新文件的变化,一旦有新文件出现就解析,解析写入channel后完成的文件名将追加后缀为*.COMPLATE

LogAgent.sources.apache.type = spooldir

LogAgent.sources.apache.spoolDir = /tmp/logs

LogAgent.sources.apache.channels = fileChannel

LogAgent.sources.apache.fileHeader = false

#sinks config

LogAgent.sinks.HDFS.channel = fileChannel

LogAgent.sinks.HDFS.type = hdfs

LogAgent.sinks.HDFS.hdfs.path = hdfs://master:9000/data/logs/%Y-%m-%d/%H

LogAgent.sinks.HDFS.hdfs.fileType = DataStream

LogAgent.sinks.HDFS.hdfs.writeFormat=TEXT

LogAgent.sinks.HDFS.hdfs.filePrefix = flumeHdfs

LogAgent.sinks.HDFS.hdfs.batchSize = 1000

LogAgent.sinks.HDFS.hdfs.rollSize = 10240

LogAgent.sinks.HDFS.hdfs.rollCount = 0

LogAgent.sinks.HDFS.hdfs.rollInterval = 1

LogAgent.sinks.HDFS.hdfs.useLocalTimeStamp = true

#channels config

LogAgent.channels.fileChannel.type = memory

LogAgent.channels.fileChannel.capacity =10000

LogAgent.channels.fileChannel.transactionCapacity = 100
3.启动:
1.在 apache-flume 目录下执行
bin/flume-ng agent --conf-file conf/hdfs.properties -c conf/ --name LogAgent -Dflume.root.logger=DEBUG,console

启动出错,Ctrl+C 退出,新建监控目录/tmp/logs
mkdir -p /tmp/logs
重新启动:
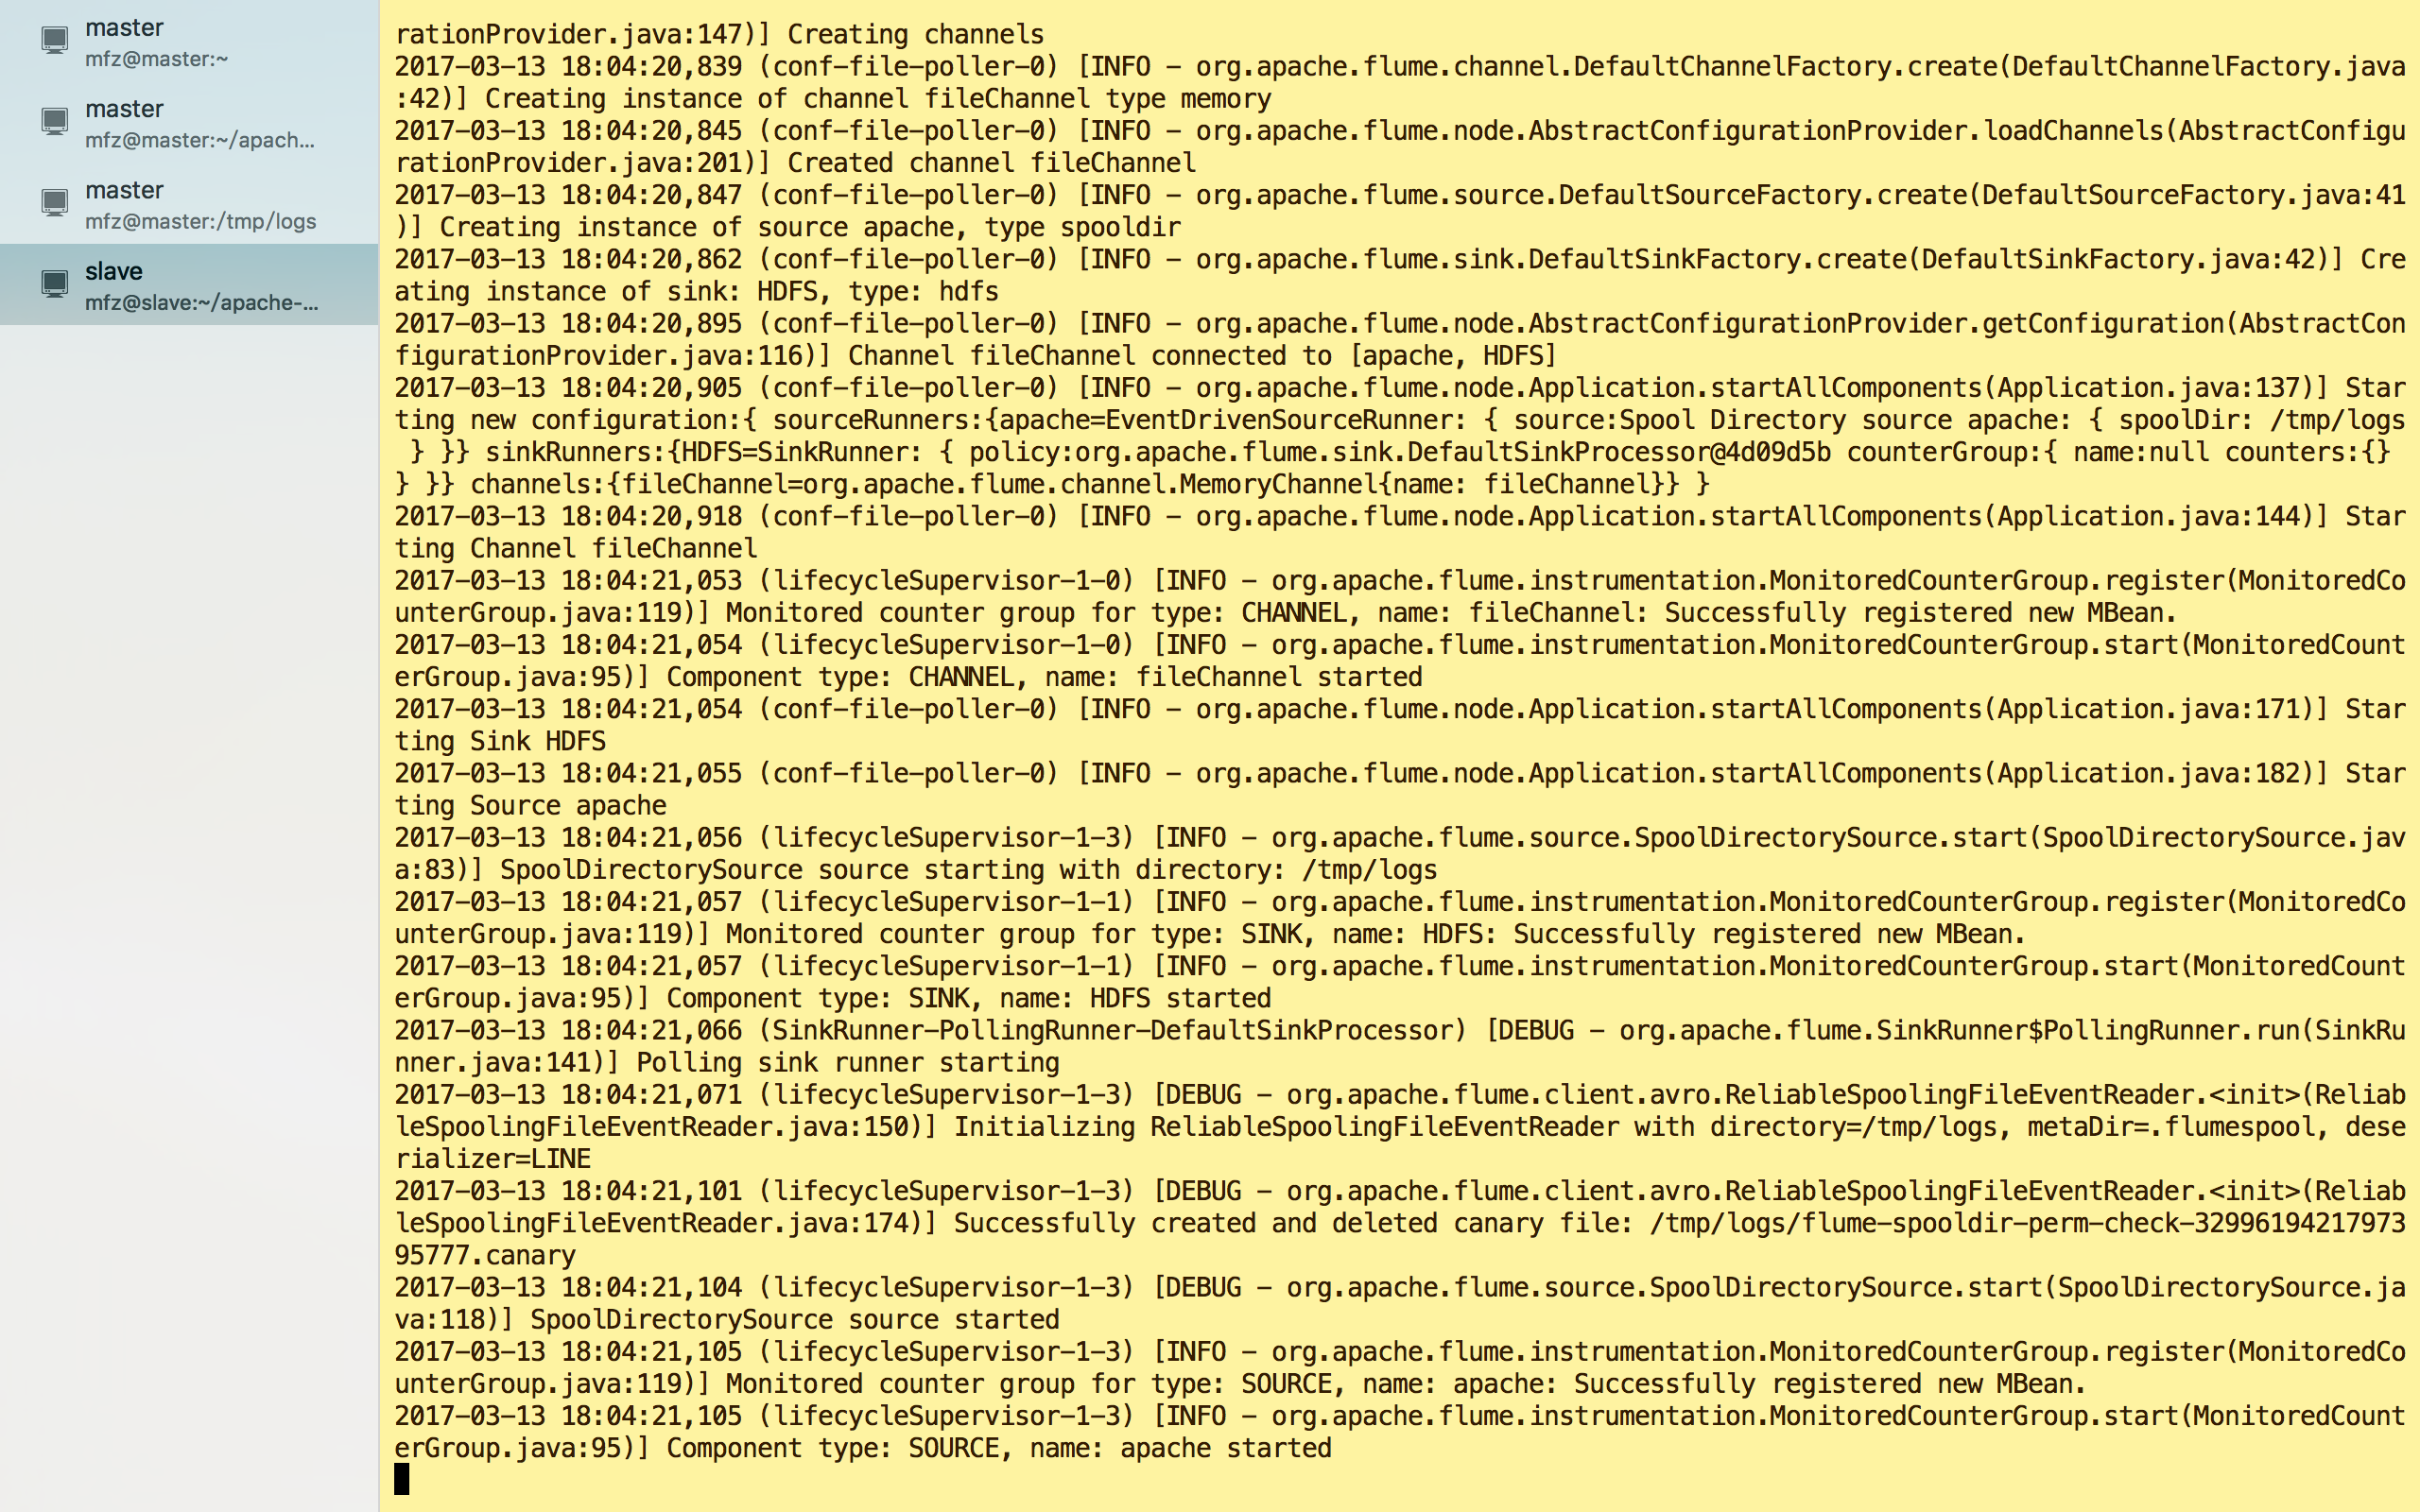
启动成功!
4.验证:
a.另新建一终端操作;
b.在监控目录/tmp/logs下新建test.log目录
vi test.log

#内容

test hello world
c.保存文件后查看之前的终端输出为
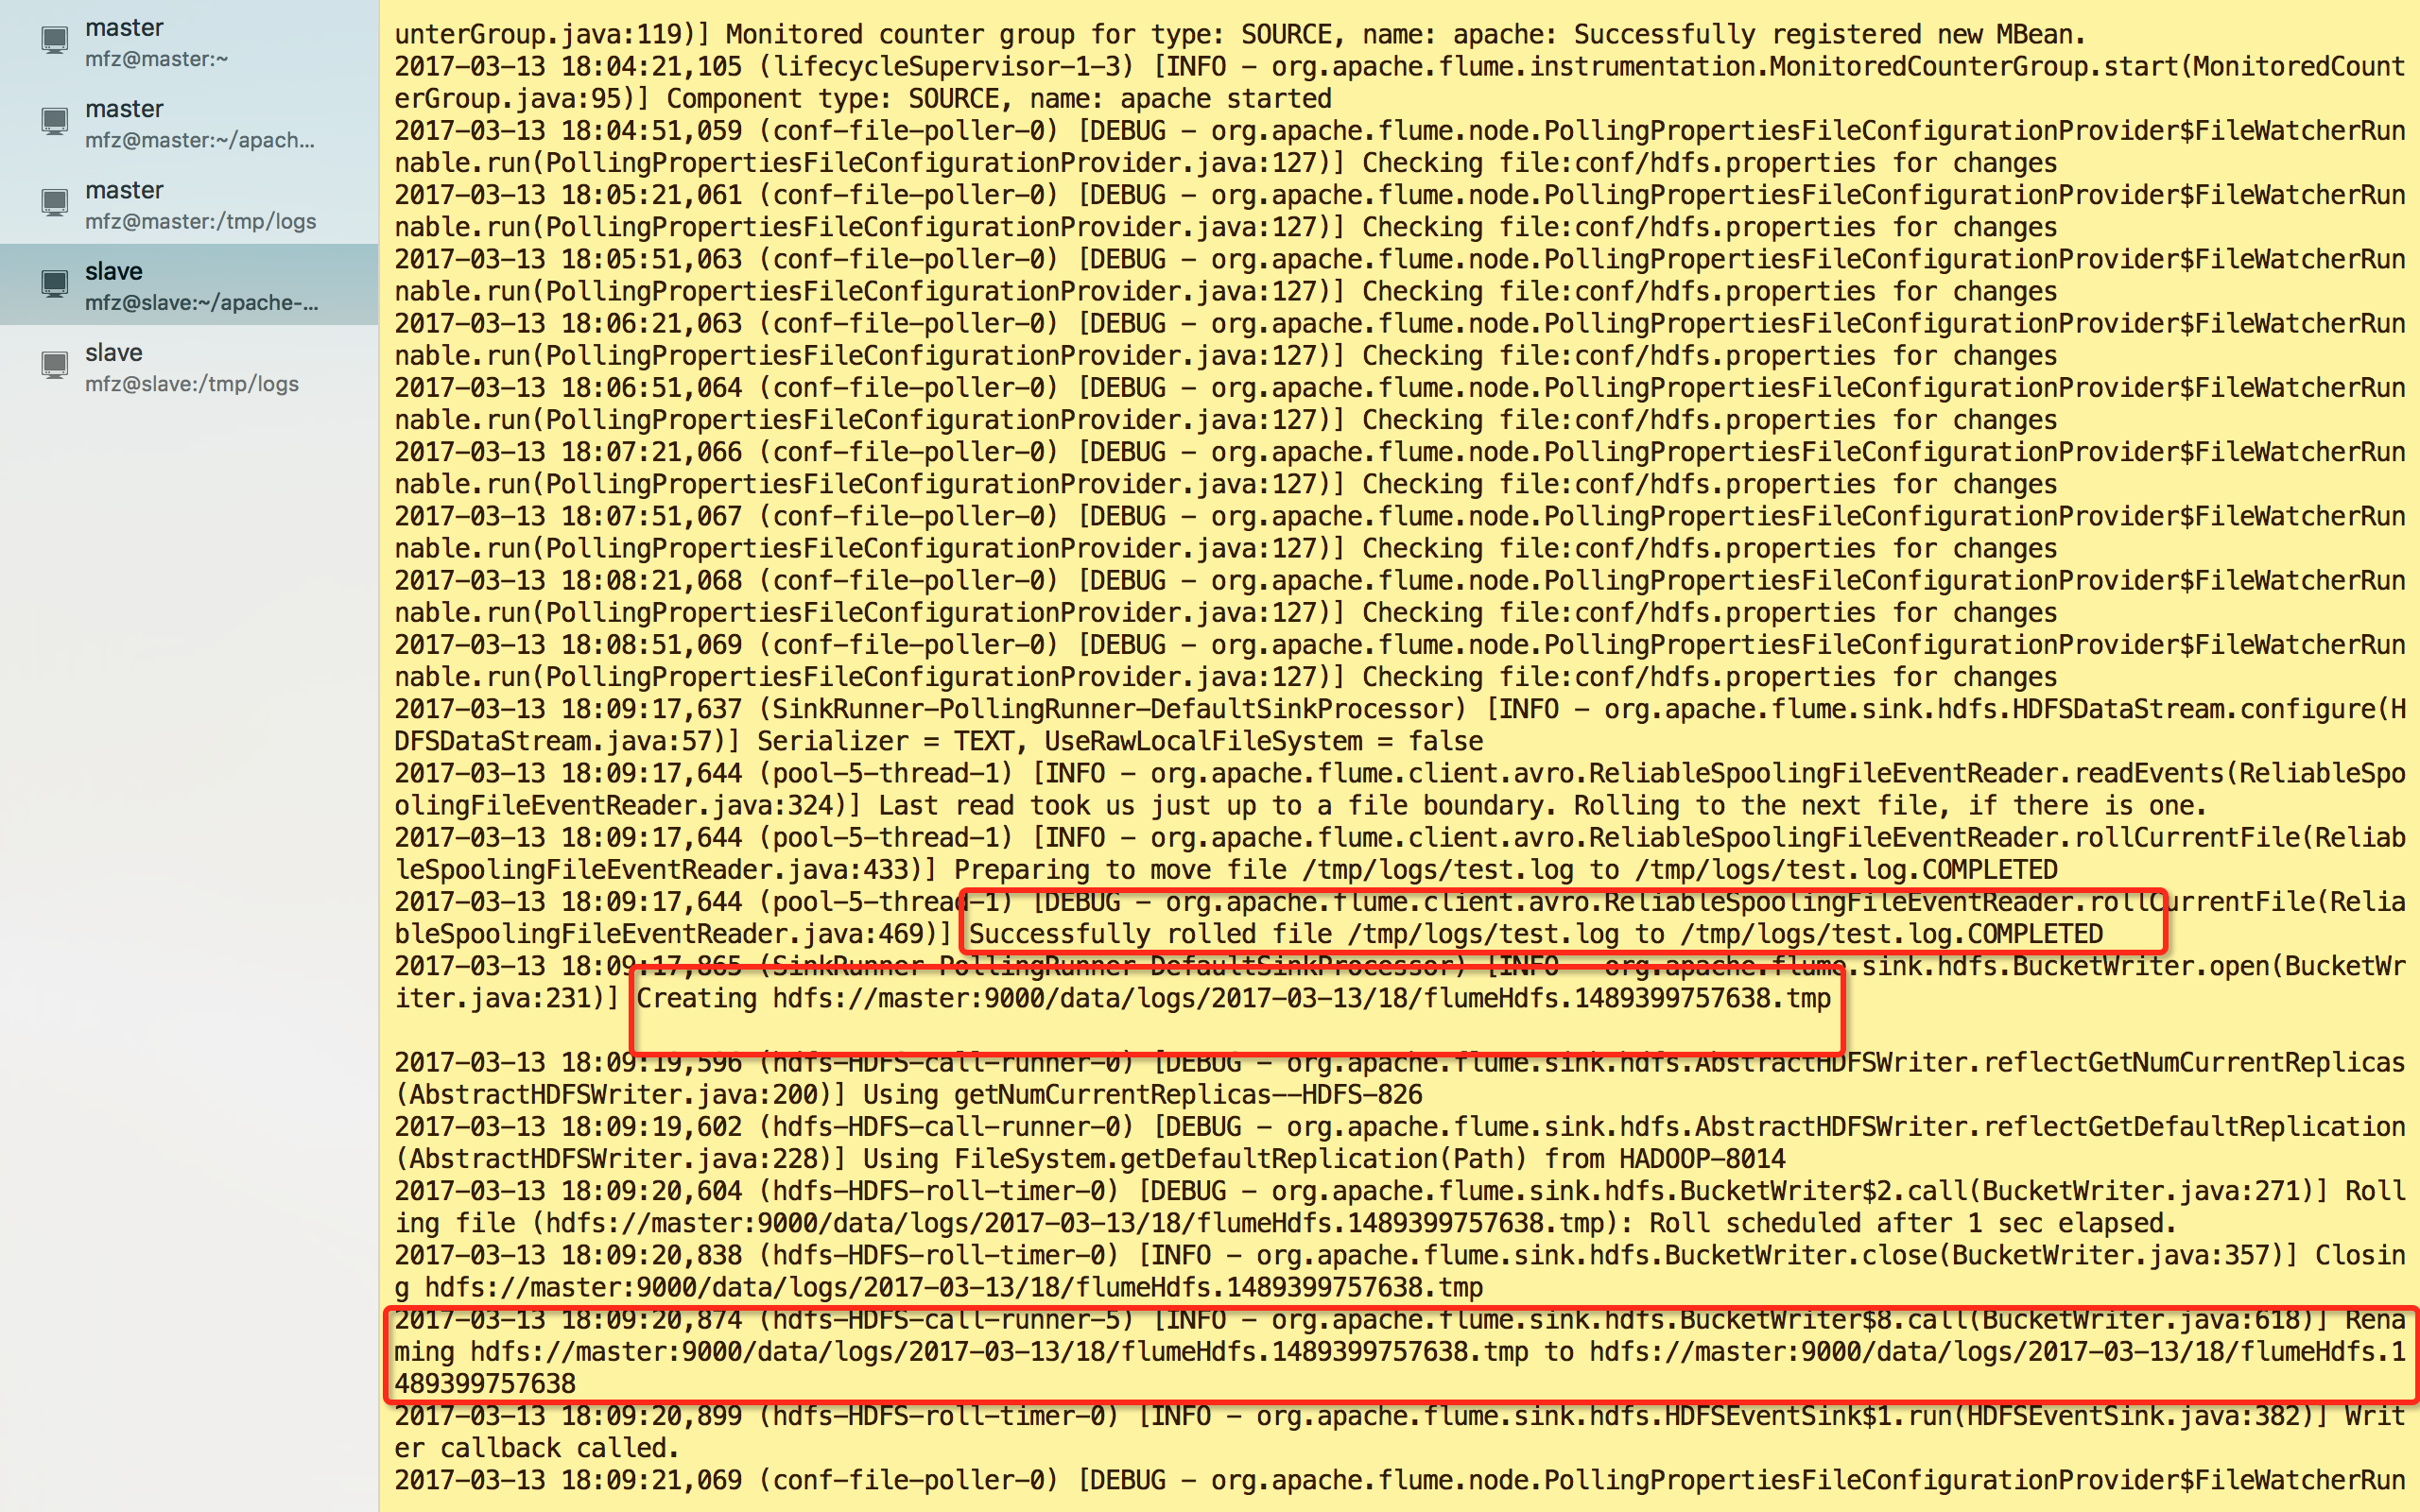
看图可得到信息:
1.test.log 已被解析传输完成且名称修改为test.log.COMPLETED;
2.HDFS目录下生成了文件及路径为:hdfs://master:9000/data/logs/2017-03-13/18/flumeHdfs.1489399757638.tmp
3.文件flumeHdfs.1489399757638.tmp 已被修改为flumeHdfs.1489399757638
那么接下里登录master主机,打开WebUI,如下操作
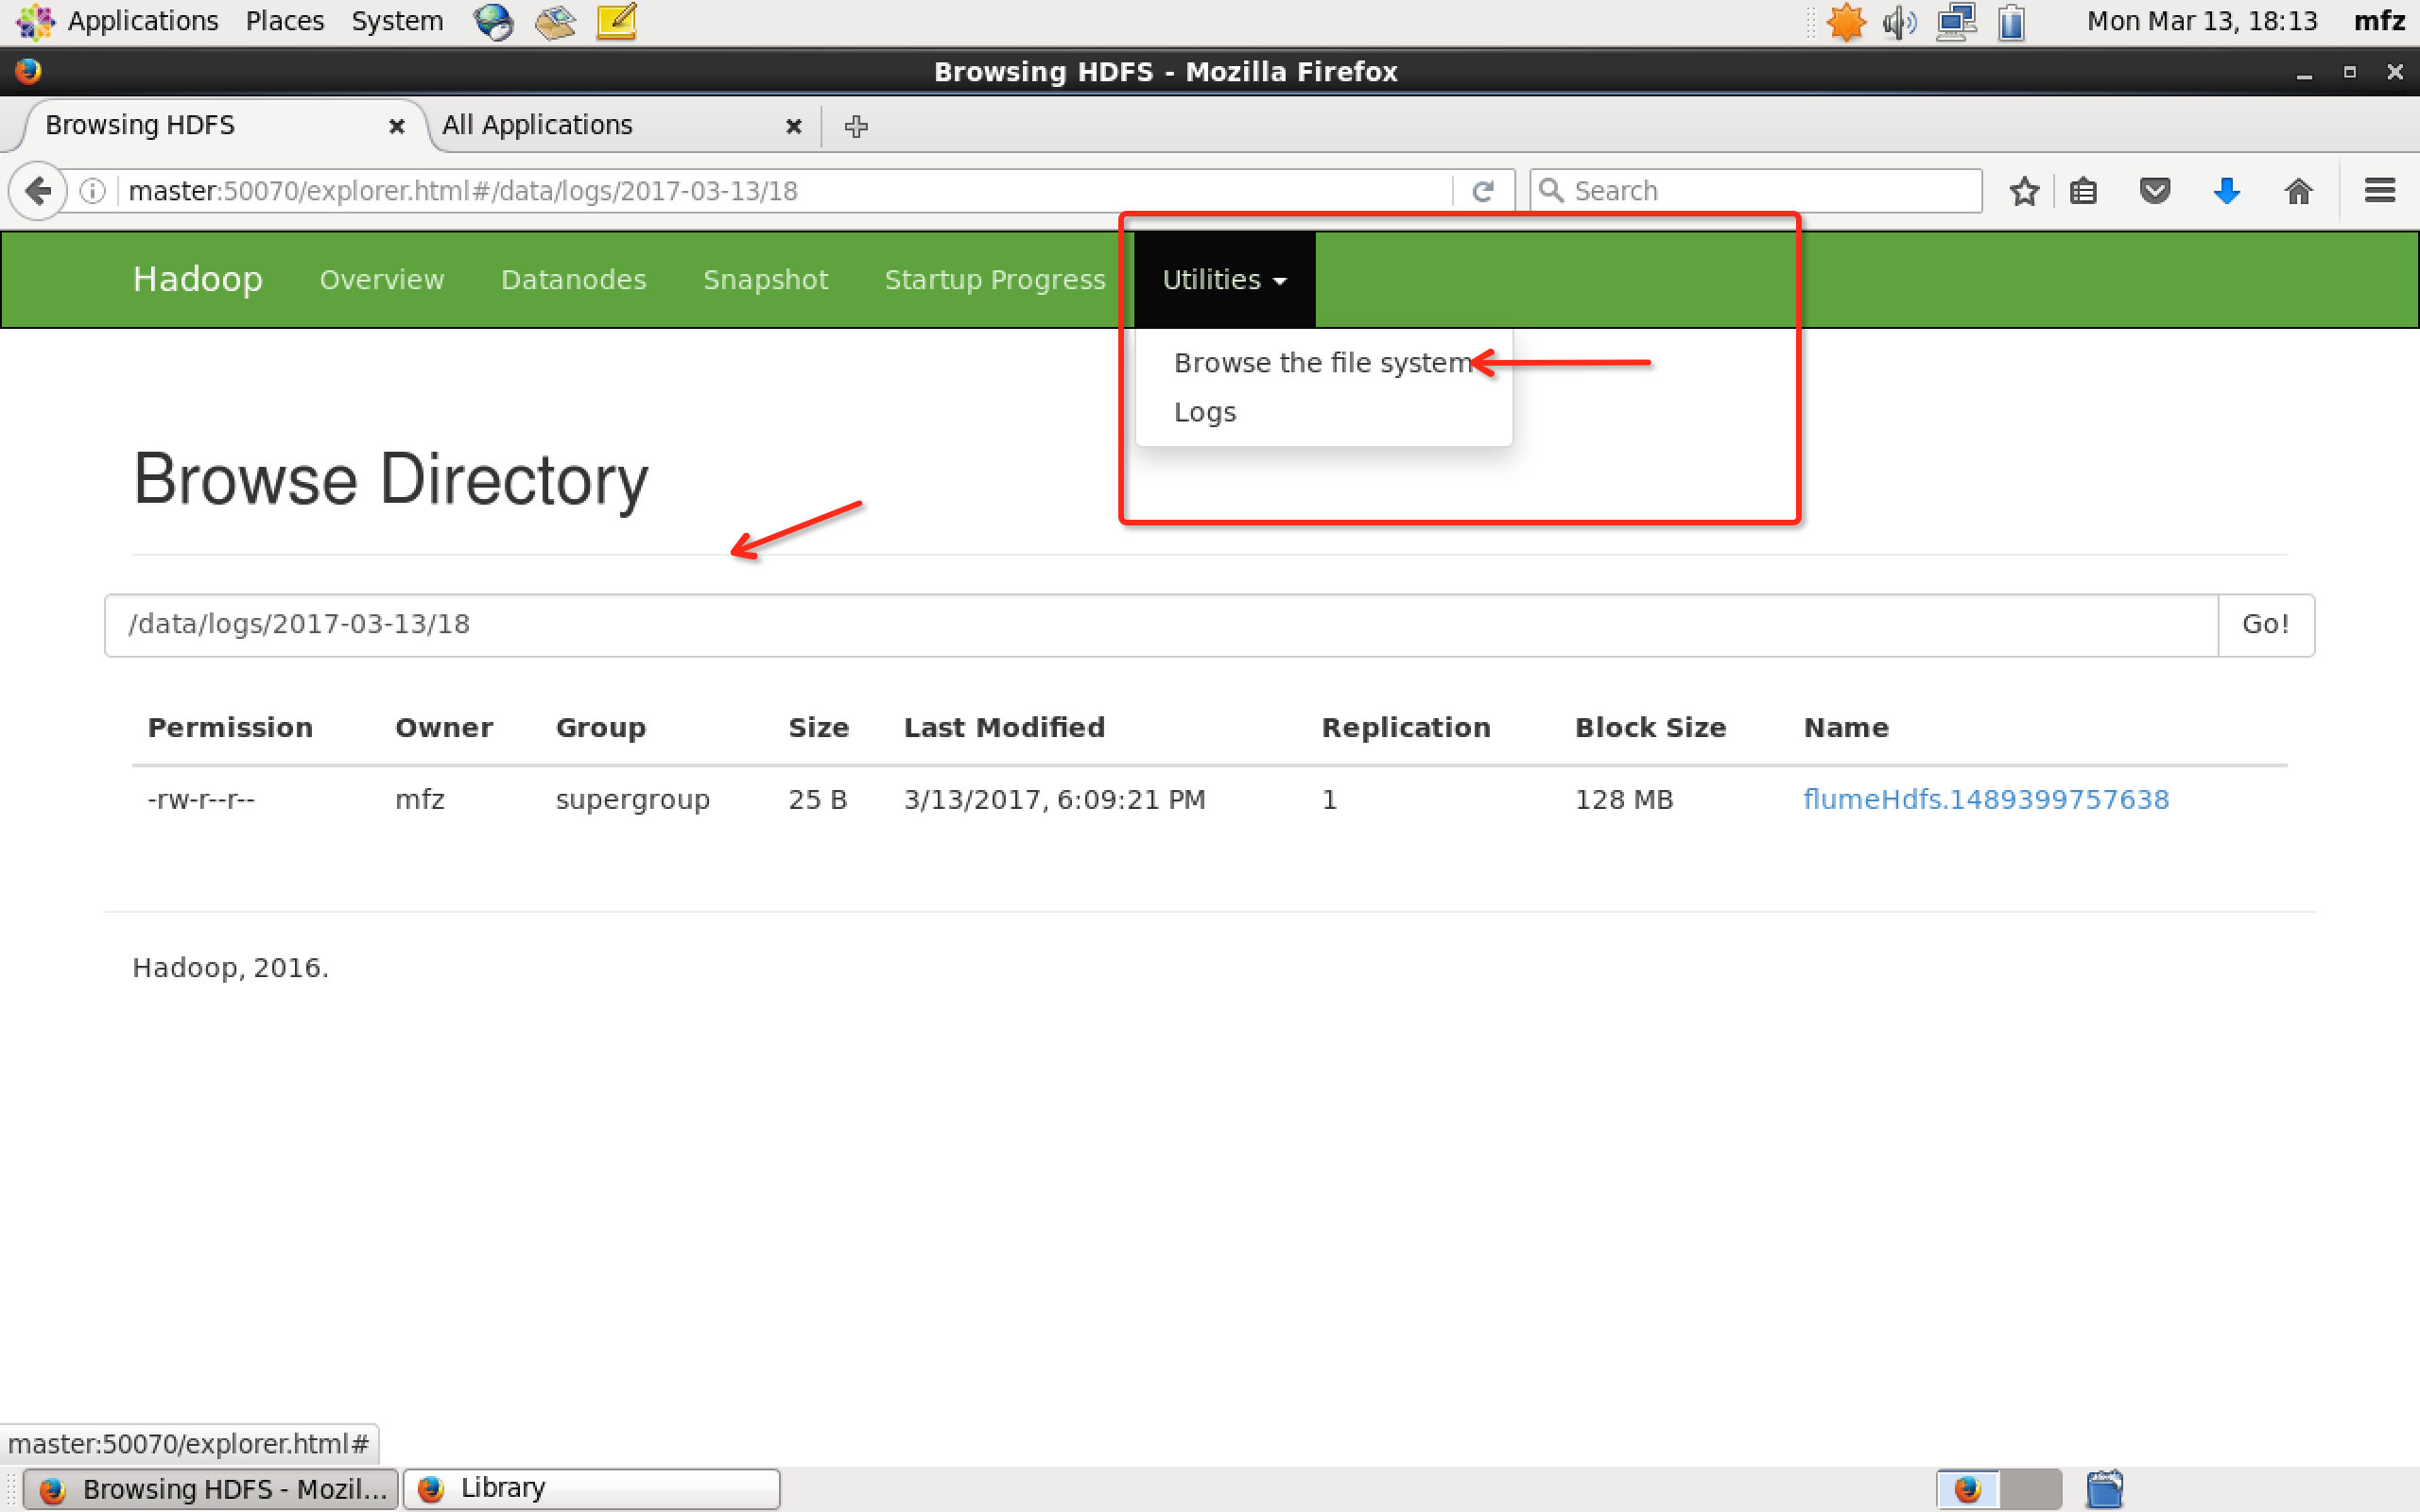
或者打开master终端,在hadoop安装包下执行命令
bin/hadoop fs -ls -R /data/logs/--/

查看文件内容,命令:
bin/hadoop fs -cat /data/logs/2017-03-13/18/flumeHdfs.1489399757638
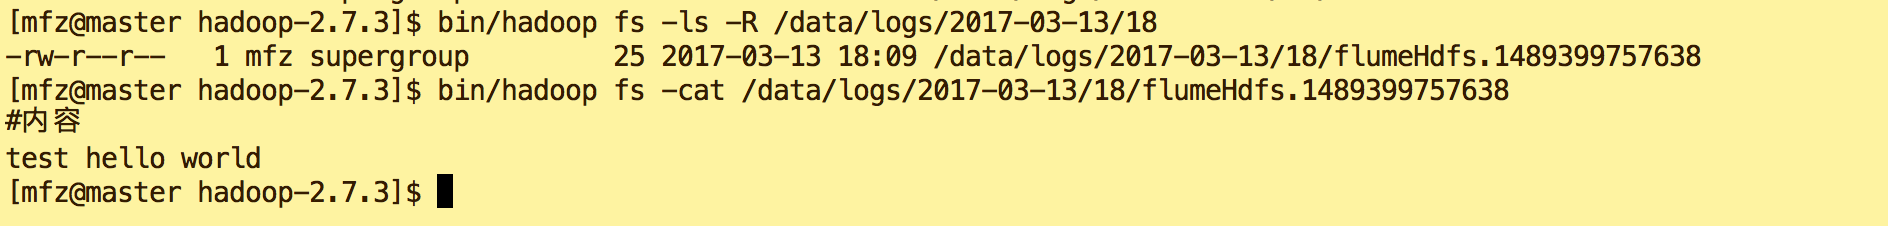
OK,完成!
大数据系列之Flume+HDFS的更多相关文章
- 大数据系列之Flume+kafka 整合
相关文章: 大数据系列之Kafka安装 大数据系列之Flume--几种不同的Sources 大数据系列之Flume+HDFS 关于Flume 的 一些核心概念: 组件名称 功能介绍 Agent ...
- 大数据系列2:Hdfs的读写操作
在前文大数据系列1:一文初识Hdfs中,我们对Hdfs有了简单的认识. 在本文中,我们将会简单的介绍一下Hdfs文件的读写流程,为后续追踪读写流程的源码做准备. Hdfs 架构 首先来个Hdfs的架构 ...
- 大数据系列4:Yarn以及MapReduce 2
系列文章: 大数据系列:一文初识Hdfs 大数据系列2:Hdfs的读写操作 大数据谢列3:Hdfs的HA实现 通过前文,我们对Hdfs的已经有了一定的了解,本文将继续之前的内容,介绍Yarn与Yarn ...
- 大数据系列(3)——Hadoop集群完全分布式坏境搭建
前言 上一篇我们讲解了Hadoop单节点的安装,并且已经通过VMware安装了一台CentOS 6.8的Linux系统,咱们本篇的目标就是要配置一个真正的完全分布式的Hadoop集群,闲言少叙,进入本 ...
- 大数据系列(2)——Hadoop集群坏境CentOS安装
前言 前面我们主要分析了搭建Hadoop集群所需要准备的内容和一些提前规划好的项,本篇我们主要来分析如何安装CentOS操作系统,以及一些基础的设置,闲言少叙,我们进入本篇的正题. 技术准备 VMwa ...
- 大数据系列之并行计算引擎Spark部署及应用
相关博文: 大数据系列之并行计算引擎Spark介绍 之前介绍过关于Spark的程序运行模式有三种: 1.Local模式: 2.standalone(独立模式) 3.Yarn/mesos模式 本文将介绍 ...
- 大数据系列之并行计算引擎Spark介绍
相关博文:大数据系列之并行计算引擎Spark部署及应用 Spark: Apache Spark 是专为大规模数据处理而设计的快速通用的计算引擎. Spark是UC Berkeley AMP lab ( ...
- 大数据系列之数据仓库Hive安装
Hive系列博文,持续更新~~~ 大数据系列之数据仓库Hive原理 大数据系列之数据仓库Hive安装 大数据系列之数据仓库Hive中分区Partition如何使用 大数据系列之数据仓库Hive命令使用 ...
- 大数据系列之数据仓库Hive命令使用及JDBC连接
Hive系列博文,持续更新~~~ 大数据系列之数据仓库Hive原理 大数据系列之数据仓库Hive安装 大数据系列之数据仓库Hive中分区Partition如何使用 大数据系列之数据仓库Hive命令使用 ...
随机推荐
- WPF ResourceDictionary的使用
作用:一个应用程序中,某个窗口需要使用样式,但是样式非常多,写在一个窗口中代码分类不方便.最好Style写在专门的xaml文件中,然后引用到窗口中,就像HTML引用外部css文件一样. 初衷:就在于可 ...
- Flex移动皮肤开发(二)
范例文件 mobile-skinning-part2.zip 在这个讨论创建 Flex 移动 skin 的系列的 第 1 部分 中,我讨论了 Flex 团队在 Mobile 主题中所做的性能优化的原理 ...
- PHP的一些天坑
什么叫天坑.天呐,原来这么坑,不知则已,细思极恐. 一.小数(符点数)不能直接比较是否相等 比如 if( 0.5+0.2==0.7 ) 的结果是 false.究其原因是因为,PHP是基于C语言的,而C ...
- ASP.Net数据库如何存取图片
当我们有大量的图片或者图片比较大时,我们常规的做法可能是保存图片路径,但是也不排除需要将图片直接存放到数据库的情况,此时就需要保存图片到数据库了.这篇文章我会向大家介绍: 如何通过FileUpLoad ...
- NSObject头文件解析 / 消息机制 / Runtime解读 (一)
NSObject头文件解析 当我们需要自定义类都会创建一个NSObject子类, 比如: #import <Foundation/Foundation.h> @interface Clas ...
- thinkjs之页面跳转
对于刚入手thinkjs项目的新手来说,时常会犯的一个错误就是“混用”各种代码逻辑,比如:我们经常在做后台管理系统的时候用到的登录框,,其实它原本是有一个路由专门存放自己的代码逻辑,而在点击提交按钮的 ...
- setObject:forKey和setValue:forKey的区别
setObject:forKey: 是NSMutableDictionary类的方法 key参数类型可以是任意类型对象 ...
- swift 可选类型笔记
晚上十一点半了,看书累了,原本想睡了的,想了想,还是把刚看的总结一下,把这篇笔记写了吧.广州下雨,真特么的冷..好了,废话不说了,说正题说说Swift可选类型. 先定义一个变量: var string ...
- [Netty] - Netty入门(最简单的Netty客户端/服务器程序)
Java中的NIO是一种解决阻塞式IO问题的基本技术,但是NIO的编写对java程序员是有比较高的要求的.那么Netty就是一种简化操作的一个成熟的网络IO编程框架.这里简单介绍一个程序,代码是< ...
- jquery和javascript的区别(常用方法比较)
jquery 就对javascript的一个扩展,封装,就是让javascript更好用,更简单.人家怎么说的来着,jquery就是要用更少的代码,漂亮的完成更多的功能.JavaScript 与JQu ...