
069 在SparkStreaming的窗口分析
一:说明
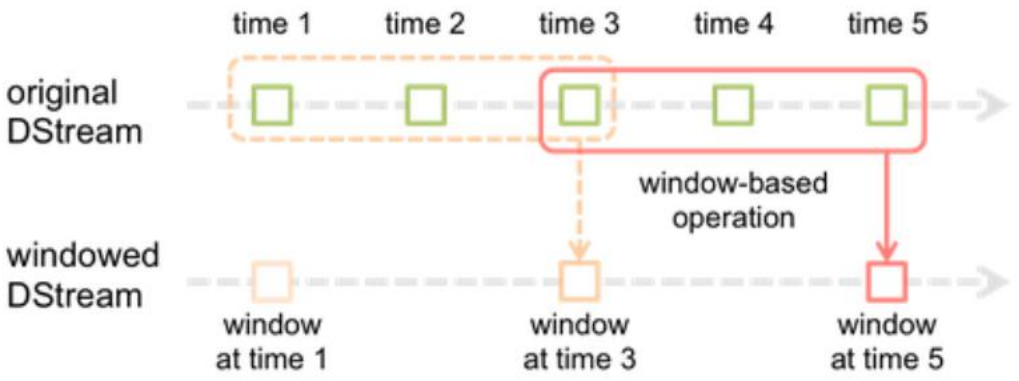
1.图例说明
-------------------------------------------------------------------------------------------------------------------------------------------------------------------------

2.对比说明
DStream:
batchInterval: 批次产生间隔时间
Window DStream:
windowInterval: 窗口间隔时间, 必须是父DStream的batchInterval的倍数(k >= 1, 整数)
slideInterval:窗口滑动间隔时间, 必须是父DStream的batchInterval的倍数(k >= 1, 整数)
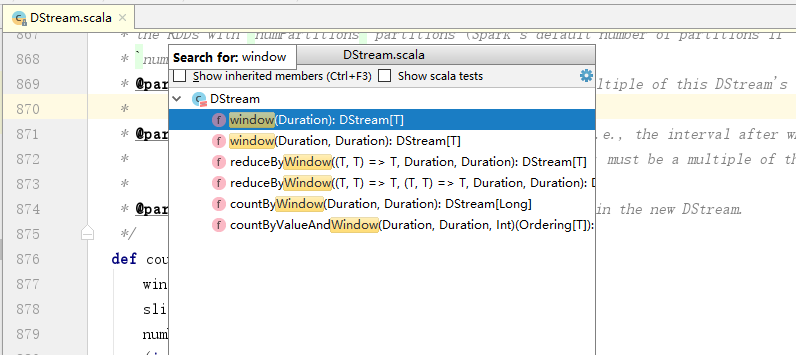
3.API
使用CTRL+F3,可以参考这篇文档的快捷键:https://blog.csdn.net/qq_36901488/article/details/80704245
二:程序
1.程序
 package com.window.it

 import org.apache.spark.{SparkConf, SparkContext}

 import org.apache.spark.storage.StorageLevel

 import org.apache.spark.streaming.{Seconds, State, StateSpec, StreamingContext}

 import org.apache.spark.streaming.dstream.DStream

 import org.apache.spark.streaming.kafka.KafkaUtils

 object ReduceWindow {

   def main(args: Array[String]): Unit = {

     val conf = new SparkConf()

       .setAppName("StreamingWindowOfKafka")

       .setMaster("local[*]")

     val sc = SparkContext.getOrCreate(conf)

     val ssc = new StreamingContext(sc, Seconds(5))

     // 当调用updateStateByKey函数API的时候,必须给定checkpoint dir

     // 路径对应的文件夹不能存在

     ssc.checkpoint("hdfs://linux-hadoop01.ibeifeng.com:8020/beifeng/spark/streaming/452512")

     val kafkaParams = Map(

       "group.id" -> "streaming-kafka-78912151",

       "zookeeper.connect" -> "linux-hadoop01.ibeifeng.com:2181/kafka",

       "auto.offset.reset" -> "smallest"

     )

     val topics = Map("beifeng" -> 4) // topics中value是读取数据的线程数量,所以必须大于等于1

     val dstream = KafkaUtils.createStream[String, String, kafka.serializer.StringDecoder, kafka.serializer.StringDecoder](

       ssc, // 给定SparkStreaming上下文

       kafkaParams, // 给定连接kafka的参数信息 ===> 通过Kafka HighLevelConsumerAPI连接

       topics, // 给定读取对应topic的名称以及读取数据的线程数量

       StorageLevel.MEMORY_AND_DISK_2 // 指定数据接收器接收到kafka的数据后保存的存储级别

     ).map(_._2)

     val resultWordCount = dstream

       .filter(line => line.nonEmpty)

       .flatMap(line => line.split(" ").map((_, 1)))

       .reduceByKeyAndWindow(

         (a: Int, b: Int) => a + b,

         Seconds(15), // 窗口大小

         Seconds(10) // 滑动大小

       )

     resultWordCount.print() // 这个也是打印数据

     // 启动开始处理

     ssc.start()

     ssc.awaitTermination() // 等等结束,监控一个线程的中断操作

   }

 }
2.效果
这里主要看的是页面的DAG。
069 在SparkStreaming的窗口分析的更多相关文章
- SparkStreaming实时日志分析--实时热搜词
Overview 整个项目的整体架构如下: 关于SparkStreaming的部分: Flume传数据到SparkStreaming:为了简单使用的是push-based的方式.这种方式可能会丢失数据 ...
- SparkStreaming 源码分析
SparkStreaming 分析 (基于1.5版本源码) SparkStreaming 介绍 SparkStreaming是一个流式批处理框架,它的核心执行引擎是Spark,适合处理实时数据与历史数 ...
- windows窗口分析,父窗口,子窗口,所有者窗口
(本文尝试通过一些简单的实验,来分析Windows的窗口机制,并对微软的设计理由进行一定的猜测,需要读者具备C++.Windows编程及MFC经验,还得有一定动手能力.文中可能出现一些术语不统一的现象 ...
- DirectStream、Stream的区别-SparkStreaming源码分析02
转http://hadoop1989.com/2016/03/15/KafkaStreaming/ 在Spark1.3之前,默认的Spark接收Kafka数据的方式是基于Receiver的,在这之后的 ...
- Flink Streaming基于滚动窗口的事件时间分析
使用flink-1.9.0进行的测试,在不同的并行度下,Flink对事件时间的处理逻辑不同.包括1.1在并行度为1的本地模式分析和1.2在多并行度的本地模式分析两部分.通过理论结合源码进行验证,得到具 ...
- LR12.53—第7课:分析场景
第7课:分析场景 在前面的课程中,您学习如何设计,控制和执行方案运行.一旦您已加载您的服务器,你要分析的运行,并确定需要被淘汰,以提高系统性能的问题. 在图表和报告中有关方案的性能您的分析会议上提出的 ...
- 小项目一---Python日志分析
日志分析 概述 分析的前提 半结构化数据 文本分析 提取数据(信息提取) 一.空格分隔 with open('xxx.log')as f: for line in f: for field in ...
- win32程序之窗口程序,以及消息机制
win32程序值窗口程序,以及消息机制 一丶简介 通过上一讲.我们了解了窗口其实是绘制出来的.而且是不断绘制的过程. 所以窗口的本质是绘制. 但是我们现在看到的窗口程序.都可以点击关闭按钮. 使用鼠标 ...
- FusionInsight大数据开发---SparkStreaming概述
SparkStreaming概述 SparkStreaming是Spark核心API的一个扩展,它对实时流式数据的处理具有可扩展性.高吞吐量.可容错性等特点. SparkStreaming原理 Spa ...
随机推荐
- Spring 邮件发送
前言:以前都是直接用Java自带的邮件工具发送邮件,现在Spring帮我们做了封装,提供了更好用更简单的发送邮件工具JavaMailSender 关于邮件服务器的设置就不在这里说了,直接去QQ邮箱 ...
- mysql 中实现多条数据同时更新
有时间我们需要对一张表进行批量数据的更新.首先我们想的是update 语句. 比如对一张订单表order_info 多条数据更新, update order_inifo set order_cod ...
- Struts2中类数据封装的方式
第一种方式:属性驱动提供对应属性的set方法进行数据的封装.表单的哪些属性需要封装数据,那么在对应的Action类中提供该属性的set方法即可.表单中的数据提交,最终找到Action类中的setXxx ...
- JavaWEB后端支付银联,支付宝,微信对接
注:本文来源于:< JavaWEB后端支付银联,支付宝,微信对接 > JavaWEB后端支付银联,支付宝,微信对接 标签(空格分隔): java 项目概述 最近项目需要后端打通支付,所 ...
- Confluence 6 配置文件和key
找到配置文件 缓存的配置文件是存储在 <confluence-home>/shared-home/config/cache-settings-overrides.properties 中的 ...
- kali linux revealed mastering the penetration testing distribution
1.本博客记载的是这本书的学习笔记,还有出现的一些不懂的单词 我也将会记载这篇博客中.记载顺序是按照本书的章节顺序来记载的.最喜欢本书中的一句 you havae no idea how good ...
- MySQL is running but PID file could not be found(解决方法)
启动MySQL时报错: [root@xzw /]# service mysqld status MySQL is running but PID file could not be found ...
- 制作linux下的.run安装包
前言 之前往linux上安装一个软件,都是以压缩包或者压缩包+shell的方法,这每次安装,都是先scp到某个目录, 解压,安装......稍微厉害的,会写个shell脚本.但是还是达不到真正的快速方 ...
- The error may exist in com/bjpowernode/dao/StudentDao.xml ### Cause: org.apache.ibatis.builder.BuilderException: Error parsing SQL Mapper Configuration. Cause: org.apache.ibatis.builder.BuilderExcept
The error may exist in com/bjpowernode/dao/StudentDao.xml### Cause: org.apache.ibatis.builder.Builde ...
- 史上最简单的SpringCloud教程 | 第四篇:断路器(Hystrix)
在微服务架构中,根据业务来拆分成一个个的服务,服务与服务之间可以相互调用(RPC),在Spring Cloud可以用RestTemplate+Ribbon和Feign来调用.为了保证其高可用,单个服务 ...