
机器学习:调整kNN的超参数
一、评测标准
- 模型的测评标准:分类的准确度(accuracy);
- 预测准确度 = 预测成功的样本个数/预测数据集样本总数;
二、超参数
- 超参数:运行机器学习算法前需要指定的参数;
- kNN算法中的超参数:k、weights、P;
- 一般超参数之间也相互影响;
- 调参,就是调超参数;
1)问题
# 以kNN算法为例
- 平票:如果k个点中,不同类型的样本数相等,怎么选取?
- 如果选取的k个点中,数量多的一类样本点距离测试样本较远,数量少的一类样本点距离测试样本较近,此时选取数量较多的类型作为输出结果,不具说服力;
2)kNN算法中,除了K值外的另一个超参数:距离的权重(1/距离)
- k个点中,将不同类的点的权重相加,最大的那一类为目标标签
- scikit-learn库中的KNeighborsClassifier类中,还有一个weights()函数;
- 在__init__()中默认两个参数值:__init__(n_neighbors = 5, weights = 'uniform');
- weights = 'uniform',表示不考虑距离权重这个超参数;
- weights= 'distance',表示考虑距离权重这个超参数;
3)kNN算法的第三个超参数:P,距离参数
- P是有“明科夫斯基距离”得来的(详见“四、距离推导”),
- 只有当kNN算法考虑距离权重超参数(weights)时,才会考虑是否输入距离参数(P);
4)调参的方法
- 调参目的,找到最优的超参数;
- 机器学习算法应用在不同的领域中,不同领域内有其特有的知识
1、通过领域知识得到
# 不同领域内,遇到不同的问题,产参数一般不同;
# 领域:如自然语言处理、视觉搜索等;
2、经验数值
# 一般机器学习算法库中,会封装一些默认的超参数,这些默认的超参数一般都是经验数值;
# kNN算法这scikit-learn库中,k值默认为5,5就是在经验上比较好的数值;
3、通过试验搜索得到
- 思路:将不同的超参数输入模型,选取准确度最高的超参数;
- 试验搜索也称为网格搜索:对不同的超参数,使用对个for语句,逐层搜索;
- 试验搜索过程:以kNN算法为例;
# 在Jupyter NoteBook中实现的代码

import numpy as np

from sklearn import datasets

digits = datasets.load_digits()

X = digits.data

y = digits.target

from ALG.train_test_split import train_test_split

X_train, X_test, y_train, y_test = train_test_split(X, y, test_train = 0.2)

# 1)按经验选定超参数k = 5

from sklearn.neighbors import KNeighborsClassifier

knn_clf = KNeighborsClassifier(n_neighbors = 5)

knn_clf.fit(X_train, y_train)

knn_clf.score(X_test, y_test)

# 2)按试验搜索,获取最优的超参数K,不考虑weights

best_score = 0.0

best_k = -1

for k in range(1, 11):

    knn_clf = KNeighborsClassifier(n_neighbors = k)

    knn_clf.fit(X_train, y_train)

    knn_score = knn_clf.score(X_test, y_test)

    if knn_score > best_score:

        best_score = knn_score

        best_k = k

print("best_k = ", best_k)

print("best_score = ", best_score)

# 3)按试验搜索,获取最优的超参数k、weight

best_method = ""

best_score = 0.0

best_k = -1

for method in ["uniform", "distance"]:

    for k in range(1, 11):

        knn_clf = KNeighborsClassifier(n_neighbors = k)

        knn_clf.fit(X_train, y_train)

        knn_score = knn_clf.score(X_test, y_test)

        if knn_score > best_score:

            best_score = knn_score

            best_k = k

            best_method = method

print("best_mrthod = ", best_method)

print("best_k = ", best_k)

print("best_score = ", best_score)

# 4)试验搜索,获取最优产参数k、P(weights必须为distance)

%%time

best_p = -1

best_score = 0.0

best_k = -1

for k in range(1, 11):

    for p in range(1, 6):

        knn_clf = KNeighborsClassifier(n_neighbors = k, weights = "distance", p = p)

        knn_clf.fit(X_train, y_train)

        knn_score = knn_clf.score(X_test, y_test)

        if knn_score > best_score:

            best_score = knn_score

            best_k = k

            best_p = p

print("best_p = ", best_p)

print("best_k = ", best_k)

print("best_score = ", best_score)
5)其它
- ** 一般不同的超参数决定了不同的分类的准确率,它们之间呈连续变化;如果最终找到的最优的超参数为范围的边界值,意味着可能有更优的取值在边界的外面,所以要拓展搜索范围重新查询最优的超参数;
- 以上代码包含了调用scikit-learn库内的算法:导入模块、实例化、fit、调参(选取最优超参数)、预测
三、模型参数
# 模型参数:算法过程中学习的参数;
# kNN算法中没有模型参数,因为它没有模型;
# 线性回归算法和逻辑回归算法,包含有大量的模型参数;
# 什么是模型选择?
四、距离推导
- 欧拉距离:math.sqrt(np.sum((X1 - X2) ** 2)),向量X1与向量X2的欧拉距离;
- 曼哈顿距离:np.sum(|X1 - X2|),向量X1与向量X2的曼哈顿距离;
- 明科夫斯基距离:由欧拉距离和曼哈顿距离推到出;
- 下图从上至下:曼哈顿距离、欧拉距离、明科夫斯基距离;
- 在明科夫斯基距离中:
- 当P = 1,明科夫斯基距离 == 曼哈顿距离;
- 当P = 2,明科夫斯基距离 == 欧拉距离;
- 当P >= 3,对应的明科夫斯基距离为其它距离;
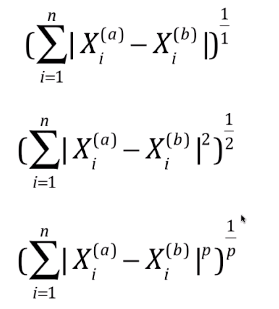
机器学习:调整kNN的超参数的更多相关文章
- 【笔记】KNN之超参数
超参数 超参数 很多时候,对于算法来说,关于这个传入的参数,传什么样的值是最好的? 这就涉及到了机器学习领域的超参数 超参数简单来说就是在我们运行机器学习之前用来指定的那个参数,就是在算法运行前需要决 ...
- 机器学习-kNN-寻找最好的超参数
一 .超参数和模型参数 超参数:在算法运行前需要决定的参数 模型参数:算法运行过程中学习的参数 - kNN算法没有模型参数- kNN算法中的k是典型的超参数 寻找好的超参数 领域知识 经验数值 实验搜 ...
- 【笔记】KNN之网格搜索与k近邻算法中更多超参数
网格搜索与k近邻算法中更多超参数 网格搜索与k近邻算法中更多超参数 网络搜索 前笔记中使用的for循环进行的网格搜索的方式,我们可以发现不同的超参数之间是存在一种依赖关系的,像是p这个超参数,只有在 ...
- 机器学习超参数优化算法-Hyperband
参考文献:Hyperband: Bandit-Based Configuration Evaluation for Hyperparameter Optimization I. 传统优化算法 机器学习 ...
- 机器学习算法中如何选取超参数:学习速率、正则项系数、minibatch size
机器学习算法中如何选取超参数:学习速率.正则项系数.minibatch size 本文是<Neural networks and deep learning>概览 中第三章的一部分,讲机器 ...
- Spark2.0机器学习系列之2:基于Pipeline、交叉验证、ParamMap的模型选择和超参数调优
Spark中的CrossValidation Spark中采用是k折交叉验证 (k-fold cross validation).举个例子,例如10折交叉验证(10-fold cross valida ...
- 机器学习:SVM(scikit-learn 中的 RBF、RBF 中的超参数 γ)
一.高斯核函数.高斯函数 μ:期望值,均值,样本平均数:(决定告诉函数中心轴的位置:x = μ) σ2:方差:(度量随机样本和平均值之间的偏离程度:, 为总体方差, 为变量, 为总体均值, 为总 ...
- TensorFlow从0到1之TensorFlow超参数及其调整(24)
正如你目前所看到的,神经网络的性能非常依赖超参数.因此,了解这些参数如何影响网络变得至关重要. 常见的超参数是学习率.正则化器.正则化系数.隐藏层的维数.初始权重值,甚至选择什么样的优化器优化权重和偏 ...
- TensorFlow实现超参数调整
TensorFlow实现超参数调整 正如你目前所看到的,神经网络的性能非常依赖超参数.因此,了解这些参数如何影响网络变得至关重要. 常见的超参数是学习率.正则化器.正则化系数.隐藏层的维数.初始权重值 ...
随机推荐
- K8s API
https://kubernetes.io/docs/reference/generated/kubernetes-api/v1.10/#daemonset-v1-apps http://docs.k ...
- CentOS 7防火墙设置开放80端口
在CentOS 6.x版本中,默认使用的是iptables防火墙.到了CentOS 7.x版本,默认防火墙变成了firewalld.本篇通过使用firewalld开启.关闭 HTTP(80)端口,来讲 ...
- centos7下安装jdk7
CentOS7.1 JDK安装 1.卸载自带OPENJDK 用 java -version 命令查看当前jdk版本信息 #java -version 用rpm -qa | grep ...
- Linux操作系统的安装以及基本的操作命令详解
背景:使用的虚拟机安装Linux 虚拟机使用的是VMware Linux版本:CentOS-6.7-X86 自行下载:CentOS-6.7-x86_64-bin-DVD1.iso 打开VMw ...
- 让外界可以访问电脑上的网站的几种方式——花生壳,域名,IIS(待)
前话: 每次“养大“一个网站,都有种骄傲地想秀给朋友们看的冲动. 之前可能是困于电脑,实在不方便. 现在,不用克制了! 该秀就秀,能装逼就装逼. 养大孩子就该拉出来秀秀,见见世面. 正题:这次实习,我 ...
- python 2 到 3 的新手坑
print 和 input print 我们在课程最开始的时候就讲过 print,在版本2的使用方法是: print 'this is version 2' 也可以是 print('this is v ...
- dtd和schema的区别
在XML技术里,可以编写一个文档来约束一个XML文档的书写规范,这称之为XML约束. 常用的约束技术XML DTD :XML Schema.XML Schema 也是一种用于定义和描述 XML 文档结 ...
- iOS耗电量测试方法及其数据收集
常用的电量测试方法: 硬件测试(硬件要求比较高,成本比较大,这里介绍软件测试方法) 软件工具检测 几个典型的耗电场景如下: 定位,尤其是调用GPS定位 网络传输,尤其是非Wifi环境 cpu频率 内存 ...
- nexus上传jar带依赖
编写pom文件 比如我上传alipay-sdk-java.jar 依赖是commons-logging.jar <project> <modelVersion>1.3.1& ...
- xftp5+xshell5工具安装包分享
身为开发人员,常常为这两个工具安装包找不到资源为难!尴尬了... 这次专门写篇博客,记录资源,并分享给大家. 上链接: 链接:https://pan.baidu.com/s/1mRNxHhr7F2Q_ ...