
TensorFlow从0到1之TensorFlow超参数及其调整(24)
正如你目前所看到的,神经网络的性能非常依赖超参数。因此,了解这些参数如何影响网络变得至关重要。
常见的超参数是学习率、正则化器、正则化系数、隐藏层的维数、初始权重值,甚至选择什么样的优化器优化权重和偏置。
超参数调整过程
- 调整超参数的第一步是构建模型。与之前一样,在 TensorFlow 中构建模型。
- 添加一种方法将模型保存在 model_file 中。在 TensorFlow 中,可以使用 Saver 对象来完成。然后保存在会话中:

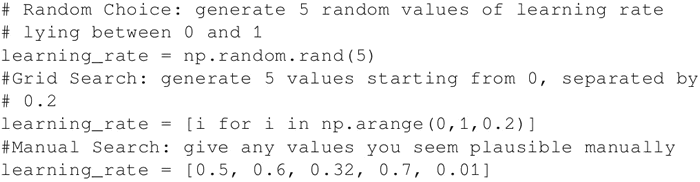
- 确定要调整的超参数,并为超参数选择可能的值。在这里,你可以做随机的选择、固定间隔值或手动选择。三者分别称为随机搜索、网格搜索和手动搜索。例如,下面是用来调节学习率的代码:
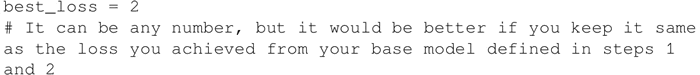
- 选择对损失函数给出最佳响应的参数。所以,可以在开始时将损失函数的最大值定义为 best_loss(如果是精度,可以选择将自己期望得到的准确率设为模型的最低精度):
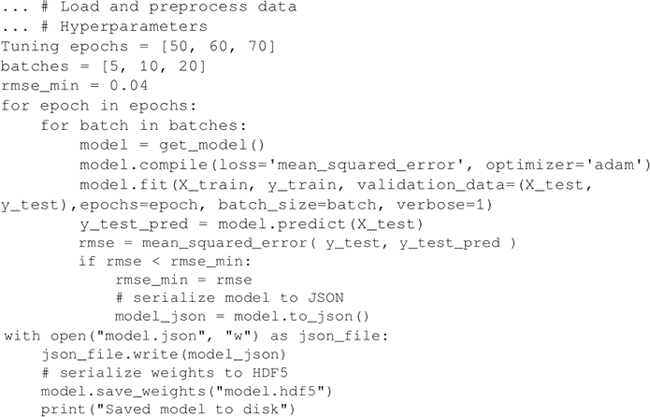
- 把你的模型放在 for 循环中,然后保存任何能更好估计损失的模型:
除此之外,贝叶斯优化也可以用来调整超参数。其中,用高斯过程定义了一个采集函数。高斯过程使用一组先前评估的参数和得出的精度来假定未观察到的参数。采集函数使用这一信息来推测下一组参数。https://github.com/lucfra/RFHO上有一个包装器用于基于梯度的超参数优化。
TensorFlow从0到1之TensorFlow超参数及其调整(24)的更多相关文章
- TensorFlow从0到1之TensorFlow多层感知机函数逼近过程(23)
Hornik 等人的工作(http://www.cs.cmu.edu/~bhiksha/courses/deeplearning/Fall.2016/notes/Sonia_Hornik.pdf)证明 ...
- TensorFlow从0到1之TensorFlow实现反向传播算法(21)
反向传播(BPN)算法是神经网络中研究最多.使用最多的算法之一,它用于将输出层中的误差传播到隐藏层的神经元,然后用于更新权重. 学习 BPN 算法可以分成以下两个过程: 正向传播:输入被馈送到网络,信 ...
- TensorFlow从0到1之TensorFlow多层感知机实现MINIST分类(22)
TensorFlow 支持自动求导,可以使用 TensorFlow 优化器来计算和使用梯度.它使用梯度自动更新用变量定义的张量.本节将使用 TensorFlow 优化器来训练网络. 前面章节中,我们定 ...
- TensorFlow从0到1之TensorFlow实现单层感知机(20)
简单感知机是一个单层神经网络.它使用阈值激活函数,正如 Marvin Minsky 在论文中所证明的,它只能解决线性可分的问题.虽然这限制了单层感知机只能应用于线性可分问题,但它具有学习能力已经很好了 ...
- TensorFlow从0到1之TensorFlow优化器(13)
高中数学学过,函数在一阶导数为零的地方达到其最大值和最小值.梯度下降算法基于相同的原理,即调整系数(权重和偏置)使损失函数的梯度下降. 在回归中,使用梯度下降来优化损失函数并获得系数.本节将介绍如何使 ...
- TensorFlow从0到1之TensorFlow Keras及其用法(25)
Keras 是与 TensorFlow 一起使用的更高级别的作为后端的 API.添加层就像添加一行代码一样简单.在模型架构之后,使用一行代码,你可以编译和拟合模型.之后,它可以用于预测.变量声明.占位 ...
- TensorFlow从0到1之TensorFlow常用激活函数(19)
每个神经元都必须有激活函数.它们为神经元提供了模拟复杂非线性数据集所必需的非线性特性.该函数取所有输入的加权和,进而生成一个输出信号.你可以把它看作输入和输出之间的转换.使用适当的激活函数,可以将输出 ...
- TensorFlow从0到1之TensorFlow逻辑回归处理MNIST数据集(17)
本节基于回归学习对 MNIST 数据集进行处理,但将添加一些 TensorBoard 总结以便更好地理解 MNIST 数据集. MNIST由https://www.tensorflow.org/get ...
- TensorFlow从0到1之TensorFlow csv文件读取数据(14)
大多数人了解 Pandas 及其在处理大数据文件方面的实用性.TensorFlow 提供了读取这种文件的方法. 前面章节中,介绍了如何在 TensorFlow 中读取文件,本节将重点介绍如何从 CSV ...
随机推荐
- Hyperledger Fabric——balance transfer(三)创建和加入Channel
详细解析blance transfer示例的创建通道(Channel)和加入节点到通道的过程. 创建Channel 1.首先看app.js的路由函数 var createChannel = requi ...
- GO 使用Webhook 实现github 自动化部署
通常大家开发大部分是本地git push 提交,服务器上git pull 手动更新.git 可以使用webhook实现自动部署.webhook是仓库平台的一个钩子事件,通过hook 钩子监听代码,回调 ...
- java-五大内存图
jrm—Java虚拟机在进行程序运行时会向cpu申请一个内存约为10%左右,该内存被jrm分为5大区域 一:栈内存(stack)用来存储变量 当栈消失时,变量也随之消失.二:堆内存(heap)在Jav ...
- js中 addEventListener 和removeEventListener
js中添加事件监听本来是非常常见的事情,但是去除监听一般很少去干,最近项目中需要监听页面显示或者隐藏 代码如下 document.addEventListener(visibilitychange', ...
- [PHP学习教程 - 文件]002.判断远程文件是否存在(Remote File Exists)
引言:项目过程当中碰到了类似流程这样的需求,对服务器上的文件进行依次操作,如:检查文件格式->检查文件是否有更新->处理更新->同步其他服务器等等 如果需求的操作是依赖于远程文件是否 ...
- [SD心灵鸡汤]001.每月一则 - 2015.05
1.既然我的父母不能带给我荣耀,那我要做的就只是带给我的子女荣耀,而不是无聊的嫉妒眼红别人. 2.就人生游戏讲,男人是女人的玩物,女人是魔鬼的玩物.就爱情而言,女人是专业的,男人是业余的. 3.快乐使 ...
- 五、Spring Web应用程序构建
内容 映射请求到Spring控制器 透明地绑定表单参数 校验表单提交 关键词 模型-视图-控制器(Model-View-Controller,MVC) 处理器映射(handle mapping) 视图 ...
- 图解MySQL索引(二)—为什么使用B+Tree
失踪人口回归,近期换工作一波三折,耽误了不少时间,从今开始每周更新~ 索引是一种支持快速查询的数据结构,同时索引优化也是后端工程师的必会知识点.各个公司都有所谓的MySQL"军规" ...
- 基于nodejs+express+mysql+webstorm+html的 增删改查
一.工具准备 Nodejs框架,WebStorm.Mysql服务.Navicat.此篇文章只讲项目的搭建过程,至于Nodejs,WebStorm.Mysql的下载.安装与配置网上资源很多,请自行查阅, ...
- 使用VUE开发用户后台时的动态路由问题、按钮权限问题以及其他页面处理问题
如今前后端分离是大势所趋,笔者虽然是做后台的,但也不得不学学前端的流行框架VUE -_-||| . 为了学习VUE,笔者搭建了一个简单的用户后台,以此来了解VUE的开发思路(注:本项目不用于实际开发, ...