
获取kafka最新offset-scala
无论是在spark streaming消费kafka,或是监控kafka的数据时,我们经常会需要知道offset最新情况
kafka数据的topic基于分区,并且通过每个partition的主分区可以获取offset的最新情况
GetOffsetShellWrap
//这是对kafka自带工具包的扩展object GetOffsetShellWrap {

  //在主函数添加一个参数map
  def main(args: Array[String],map: ArrayBuffer[String]): Unit = {    //对参数的解析
    val parser = new OptionParser
    val brokerListOpt = parser.accepts("broker-list", "REQUIRED: The list of hostname and port of the server to connect to.")
      .withRequiredArg
      .describedAs("hostname:port,...,hostname:port")
      .ofType(classOf[String])
    val topicOpt = parser.accepts("topic", "REQUIRED: The topic to get offset from.")
      .withRequiredArg
      .describedAs("topic")
      .ofType(classOf[String])
    val partitionOpt = parser.accepts("partitions", "comma separated list of partition ids. If not specified, it will find offsets for all partitions")
      .withRequiredArg
      .describedAs("partition ids")
      .ofType(classOf[String])
      .defaultsTo("")
    val timeOpt = parser.accepts("time", "timestamp of the offsets before that")
      .withRequiredArg
      .describedAs("timestamp/-1(latest)/-2(earliest)")
      .ofType(classOf[java.lang.Long])
    val nOffsetsOpt = parser.accepts("offsets", "number of offsets returned")
      .withRequiredArg
      .describedAs("count")
      .ofType(classOf[java.lang.Integer])
      .defaultsTo(1)
    val maxWaitMsOpt = parser.accepts("max-wait-ms", "The max amount of time each fetch request waits.")
      .withRequiredArg
      .describedAs("ms")
      .ofType(classOf[java.lang.Integer])
      .defaultsTo(1000)

    if(args.length == 0)
      CommandLineUtils.printUsageAndDie(parser, "An interactive shell for getting consumer offsets.")

    val options = parser.parse(args : _*)

    CommandLineUtils.checkRequiredArgs(parser, options, brokerListOpt, topicOpt, timeOpt)
  //获取参数的值
    val clientId = "GetOffsetShell"
    val brokerList = options.valueOf(brokerListOpt)
    ToolsUtils.validatePortOrDie(parser, brokerList)
    val metadataTargetBrokers = ClientUtils.parseBrokerList(brokerList)
    val topic = options.valueOf(topicOpt)
    var partitionList = options.valueOf(partitionOpt)
    var time = options.valueOf(timeOpt).longValue
    val nOffsets = options.valueOf(nOffsetsOpt).intValue
    val maxWaitMs = options.valueOf(maxWaitMsOpt).intValue()

    val topicsMetadata = ClientUtils.fetchTopicMetadata(Set(topic), metadataTargetBrokers, clientId, maxWaitMs).topicsMetadata
    if(topicsMetadata.size != 1 || !topicsMetadata(0).topic.equals(topic)) {
      System.err.println(("Error: no valid topic metadata for topic: %s, " + " probably the topic does not exist, run ").format(topic) +
        "kafka-list-topic.sh to verify")
      System.exit(1)
    }
    val partitions =
      if(partitionList == "") {
        topicsMetadata.head.partitionsMetadata.map(_.partitionId)
      } else {
        partitionList.split(",").map(_.toInt).toSeq
      }    //遍历每个主分区
    partitions.foreach { partitionId =>
      val partitionMetadataOpt = topicsMetadata.head.partitionsMetadata.find(_.partitionId == partitionId)
      partitionMetadataOpt match {
        case Some(metadata) =>
          metadata.leader match {
            case Some(leader) =>
              val consumer = new SimpleConsumer(leader.host, leader.port, 10000, 100000, clientId)
              val topicAndPartition = TopicAndPartition(topic, partitionId)
              val request = OffsetRequest(Map(topicAndPartition -> PartitionOffsetRequestInfo(time, nOffsets)))
              val offsets = consumer.getOffsetsBefore(request).partitionErrorAndOffsets(topicAndPartition).offsets
//把获取到的offset进行存储
              map += "%s:%d:%s".format(topic, partitionId, offsets.mkString(","))
            case None => System.err.println("Error: partition %d does not have a leader. Skip getting offsets".format(partitionId))
          }
        case None => System.err.println("Error: partition %d does not exist".format(partitionId))
      }
    }
  }
}
GetOffsetShellWrapScalaTest
object GetOffsetShellWrapScalaTest {
  def main(args: Array[String]) {
    var arr = ArrayBuffer[String]();
    arr+="--broker-list=hadoop-01:9092"
    arr+="-topic=2017-11-6-test"
    arr+="--time=-1"
    val resule = getOffset(arr.toArray)
    for(i<-resule){
      println("我自己获取到的偏移量=> "+i)
    }
  }
  def getOffset(args: Array[String]) : Array[String]={
    val map = new ArrayBuffer[String]()
    GetOffsetShellWrap.main(args.toArray,map)
    map.toArray
  }
}
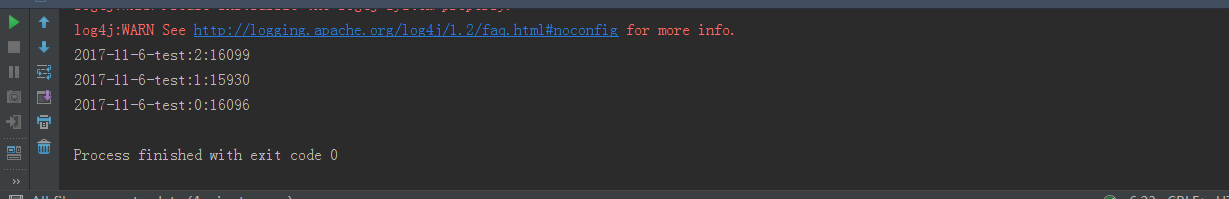
结果输出:
2017-11-6-test:2:16099
2017-11-6-test:1:15930
2017-11-6-test:0:16096
获取kafka最新offset-scala的更多相关文章
- 获取kafka最新offset-java
之前笔者曾经写过通过scala的方式获取kafka最新的offset 但是大多数的情况我们需要使用java的方式进行获取最新offset scala的方式可以参考: http://www.cnblog ...
- Spark-Streaming获取kafka数据的两种方式:Receiver与Direct的方式
简单理解为:Receiver方式是通过zookeeper来连接kafka队列,Direct方式是直接连接到kafka的节点上获取数据 Receiver 使用Kafka的高层次Consumer API来 ...
- 工具篇-Spark-Streaming获取kafka数据的两种方式(转载)
转载自:https://blog.csdn.net/weixin_41615494/article/details/7952173 一.基于Receiver的方式 原理 Receiver从Kafka中 ...
- SparkStreaming获取kafka数据的两种方式:Receiver与Direct
简介: Spark-Streaming获取kafka数据的两种方式-Receiver与Direct的方式,可以简单理解成: Receiver方式是通过zookeeper来连接kafka队列, Dire ...
- spark-streaming获取kafka数据的两种方式
简单理解为:Receiver方式是通过zookeeper来连接kafka队列,Direct方式是直接连接到kafka的节点上获取数据 一.Receiver方式: 使用kafka的高层次Consumer ...
- 获取Kafka每个分区最新Offset的几种方法
目录 脚本方法 Java 程序 参考资料 脚本方法 ./bin/kafka-run-class.sh kafka.tools.GetOffsetShell --broker-list localhos ...
- 关于怎么获取kafka指定位置offset消息(转)
1.在kafka中如果不设置消费的信息的话,一个消息只能被一个group.id消费一次,而新加如的group.id则会被“消费管理”记录,并指定从当前记录的消息位置开始向后消费.如果有段时间消费者关闭 ...
- 如何获取流式应用程序中checkpoint的最新offset
对于流式应用程序,保证应用7*24小时的稳定运行,是非常必要的.因此对于计算引擎,要求必须能够适应与应用程序逻辑本身无关的问题(比如driver应用失败重启.网络问题.服务器问题.JVM崩溃等),具有 ...
- Scala创建SparkStreaming获取Kafka数据代码过程
正文 首先打开spark官网,找一个自己用版本我选的是1.6.3的,然后进入SparkStreaming ,通过搜索这个位置找到Kafka, 点击过去会找到一段Scala的代码 import or ...
随机推荐
- python类库32[多进程同步Lock+Semaphore+Event]
python类库32[多进程同步Lock+Semaphore+Event] 同步的方法基本与多线程相同. 1) Lock 当多个进程需要访问共享资源的时候,Lock可以用来避免访问的冲突. imp ...
- mysql<七>
-- ########## 01.集合逻辑 ########## -- MySQL中,只实现了一种集合逻辑:逻辑与,有两种用法:UNION 和 UNION ALL -- 临时表1 CREATE TAB ...
- percon server5.7的配置版本
percon server5.7的配置版本 [root@tidb-db-backup mysql_3306]# cat my_3306.cnf # my_3306.cnf [client] port ...
- Python 3标准库课件第一章(第二版)
第一章文本1.1 string:文本常量和模板1.2 textwrap:格式化文本段落1.3 re:正则表达式1.4 difflib:比较序列str类,string.Templatetextwrap ...
- python中的文件读取
---恢复内容开始--- r模式,只读模式,不可写入,文件不存在会报错 #r模式,能读不能写,文件不存在会报错 f = open('a1.txt')#不写'r',默认只读 result = f.rea ...
- org.thymeleaf.exceptions.TemplateProcessingException: Could not parse as expression:
org.thymeleaf.exceptions.TemplateProcessingException: Could not parse as expression:
- memset设置最大值
初始化为最大值 memset(mp,0x7f,sizeof(mp));
- [机器学习]Fine Tune
Fine Tune顾名思义,就是微调.在机器学习中,一般用在迁移学习中,通过控制一些layer调节一些layer来达到迁移学习的目的.这样可以利用已有的参数,稍微变化一些,以适应新的学习任务.所以说, ...
- 点云数据中的三维信息提取pcl
https://www.hanspub.org/journal/PaperInformation.aspx?paperID=24702 https://wenku.baidu.com/view/160 ...
- 指定文件或文件夹直接提交到svn指定目录
我这里先说两种方法第一种:1.先将那个目录checkout下来2.将要添加的文件或者文件夹放到这个目录中3.右击文件执行svn菜单中的add命令4.右击文件执行svn菜单中的commit命令第二种:如 ...