
Kafka集群部署 (守护进程启动)
1、Kafka集群部署
1.1集群部署的基本流程
下载安装包、解压安装包、修改配置文件、分发安装包、启动集群
1.2集群部署的基础环境准备
安装前的准备工作(zk集群已经部署完毕)
关闭防火墙
chkconfig iptables off && setenforce 0 创建用户
groupadd kafka && useradd kafka && usermod -a -G kafka kafka 创建工作目录并赋权
mkdir -p /home/tuzq/software/kafka mkdir -p /home/tuzq/software/kafka/servers chmod 755 -R /home/tuzq/software/kafka
切换到kafka用户下
su kafka (本次实验,笔者使用root用户,即模拟在root下的安装。实际生产环境安装时请在指定用户下安装)
1.3 Kafka集群部署
1.3.1、下载安装包
http://kafka.apache.org/downloads.html
在linux中使用wget命令下载
wget http://mirrors.hust.edu.cn/apache/kafka/0.8.2.2/kafka_2.11-0.8.2.2.tgz1.3.2、解压安装包
tar -zxvf /home/tuzq/software/kafka_2.11-0.9.0.1.tgz -C /home/tuzq/software/kafka/servers/

cd /home/tuzq/software/kafka/servers/

ln -s kafka_2.11-0.9.0.1 kafka
修改kafka的环境变量
vim /etc/profile

在文件的最底部写上:

#set kafka env

export KAFKA_HOME=/home/tuzq/software/kafka/servers/kafka

export PATH=$PATH:$KAFKA_HOME/bin
保存,然后执行:
source /etc/profile1.3.3、修改配置文件
[root@hadoop1 kafka]# cp /home/tuzq/software/kafka/servers/kafka/config/server.properties

/home/tuzq/software/kafka/servers/kafka/config/server.properties.bak

[root@hadoop1 kafka]# vim /home/tuzq/software/kafka/servers/kafka/config/server.properties
输入以下内容:
#broker的全局唯一编号,不能重复

broker.id=0

##用来监听链接的端口,producer或consumer将在此端口建立连接

port=9092

# 处理网络请求的线程数量

num.network.threads=3

# 用来处理磁盘IO的现成数量

num.io.threads=8

# 接受套接字的缓冲区大小

socket.send.buffer.bytes=102400

#接受套接字的缓冲区大小

socket.receive.buffer.bytes=102400

# 请求套接字的缓冲区的大小

socket.request.max.bytes=104857600

# kafka运行日志存放的路径

log.dirs=/home/tuzq/software/kafka/servers/logs/kafka

# topic在当前broker上的分片个数

num.partitions=2

# 用来恢复和清理data下数据的线程数量

num.recovery.threads.per.data.dir=1

# segment文件保留的最长时间,超时将被删除

log.retention.hours=168

#滚动生成新的segment文件的最大时间

log.roll.hours=168

# 日志文件中每个segment的大小,默认为1G

log.segment.bytes=1073741824

# 周期性检查文件的时间,这里是300秒,即5分钟

log.retention.check.interval.ms=300000

##日志清理是否打开

log.cleaner.enable=true

#broker需要使用zookeeper保存meta数据

zookeeper.connect=hadoop11:2181,hadoop12:2181,hadoop13:2181

# zookeeper链接超时时间

zookeeper.connection.timeout.ms=6000

# partition buffer中,消息的条数达到阈值,将触发flush到磁盘

log.flush.interval.messages=10000

# 消息buffer的时间,达到阈值,将触发flush到磁盘

log.flush.interval.ms=3000

#删除topic需要server.properties中设置delete.topic.enable=true否则只是标记删除

delete.topic.enable=true

#此处的host.name为本机IP(重要),如果不改,则客户端会抛出:Producer connection to localhost:9092 unsuccessful 错误!   (如果是hadoop2机器,下面配置成hadoop2)

host.name=hadoop1

#外网访问配置(如果是hadoop2的,下面是192.168.106.92)

advertised.host.name=192.168.106.91
1.3.4、分发安装包
将包分发到hadoop2和hadoop3上
[root@hadoop1 software]# pwd

/home/tuzq/software

[root@hadoop1 software]# scp -r kafka root@hadoop2:$PWD

[root@hadoop1 software]# scp -r kafka root@hadoop3:$PWD
然后分别在hadoop1机器上创建软连
[root@hadoop2 software]# cd /home/tuzq/software/kafka/servers/

[root@hadoop2 servers]# ls

kafka  kafka_2.11-0.9.0.1

[root@hadoop2 servers]# rm -rf kafka

[root@hadoop2 servers]# ln -s kafka_2.11-0.9.0.1 kafka

[root@hadoop2 servers]#
在hadoop2上修改配置
[root@hadoop3 servers]# cd /home/tuzq/software/kafka/servers/

[root@hadoop3 servers]# ls

kafka  kafka_2.11-0.9.0.1

[root@hadoop3 servers]# rm -rf kafka

[root@hadoop3 servers]# ls

kafka_2.11-0.9.0.1

[root@hadoop3 servers]# ln -s kafka_2.11-0.9.0.1 kafka

[root@hadoop3 servers]# ls

kafka  kafka_2.11-0.9.0.1

[root@hadoop3 servers]#
修改kafka的环境变量
vim /etc/profile

在文件的最底部写上:

#set kafka env

export KAFKA_HOME=/home/tuzq/software/kafka/servers/kafka

export PATH=$PATH:$KAFKA_HOME/bin
保存,然后执行:
source /etc/profile1.3.5、再次修改配置文件(重要)
依次修改各服务器上配置文件的的broker.id,分别是0,1,2不得重复。
1.3.6、启动集群(注意在三台服务器上都要执行下面的命令)
依次在各节点上启动kafka
cd $KAFKA_HOME
bin/kafka-server-start.sh config/server.properties
让kafka后台运行:
[root@hadoop1 kafka]# bin/kafka-server-start.sh config/server.properties 1>/dev/null 2>&1 &

[1] 9412

[root@hadoop1 kafka]# jps

4624 DataNode

4241 DFSZKFailoverController

9475 Jps

9412 Kafka

5093 NodeManager

3981 JournalNode

4974 ResourceManager

4095 NameNode

[root@hadoop1 kafka]#
从上面可以看出有一个kafka进程 9412 Kafka
停止kafka的命令:
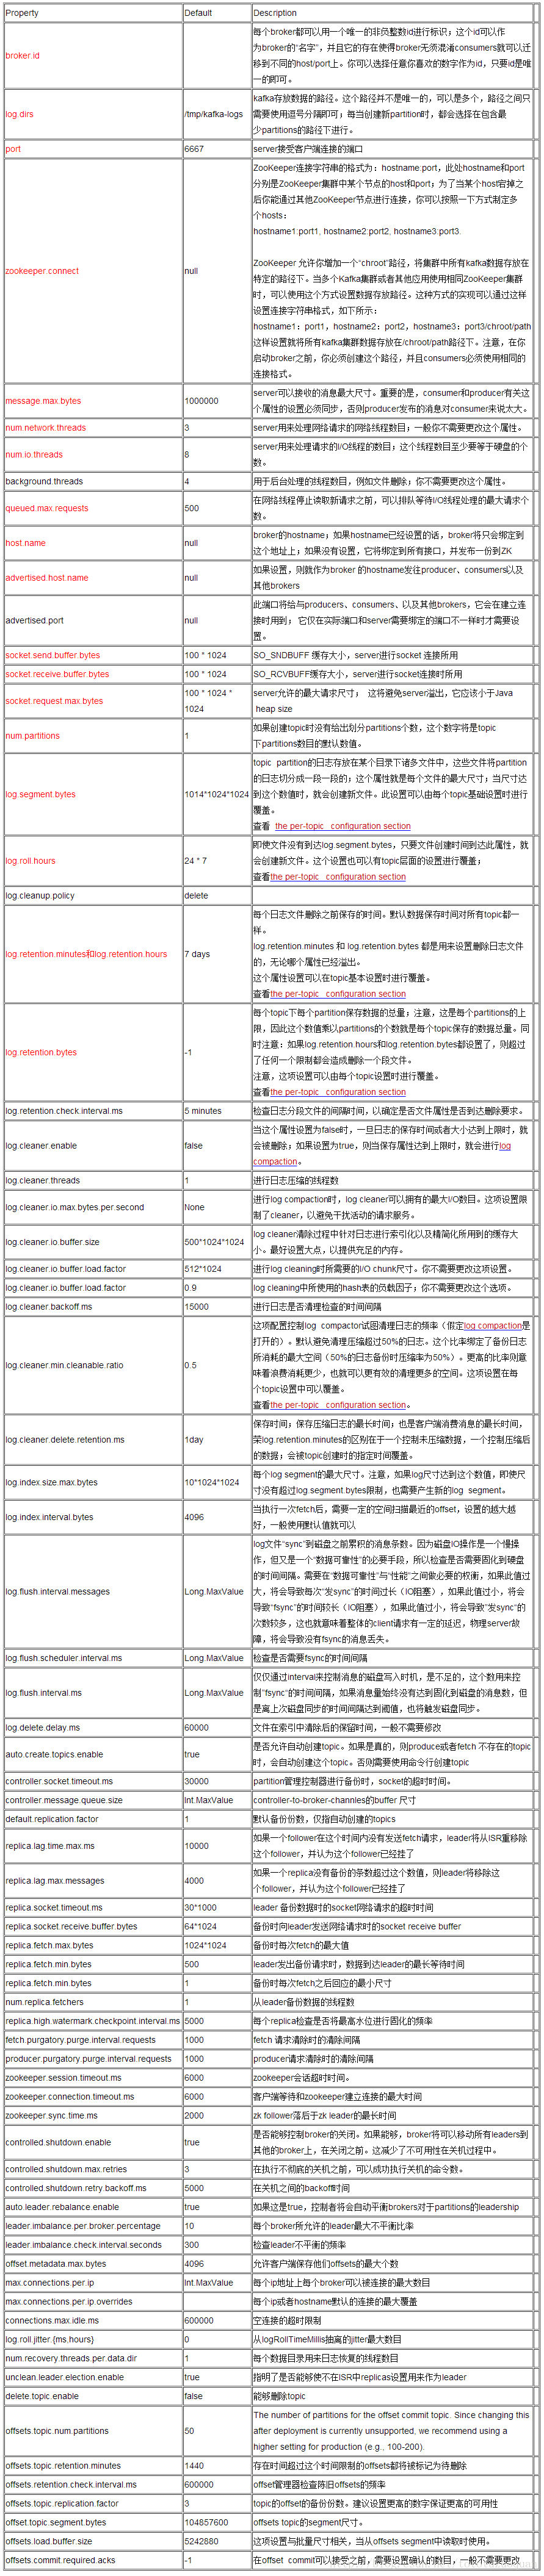
[root@hadoop1 kafka]# bin/kafka-server-stop.sh config/server.propertieskafka-broker配置文件
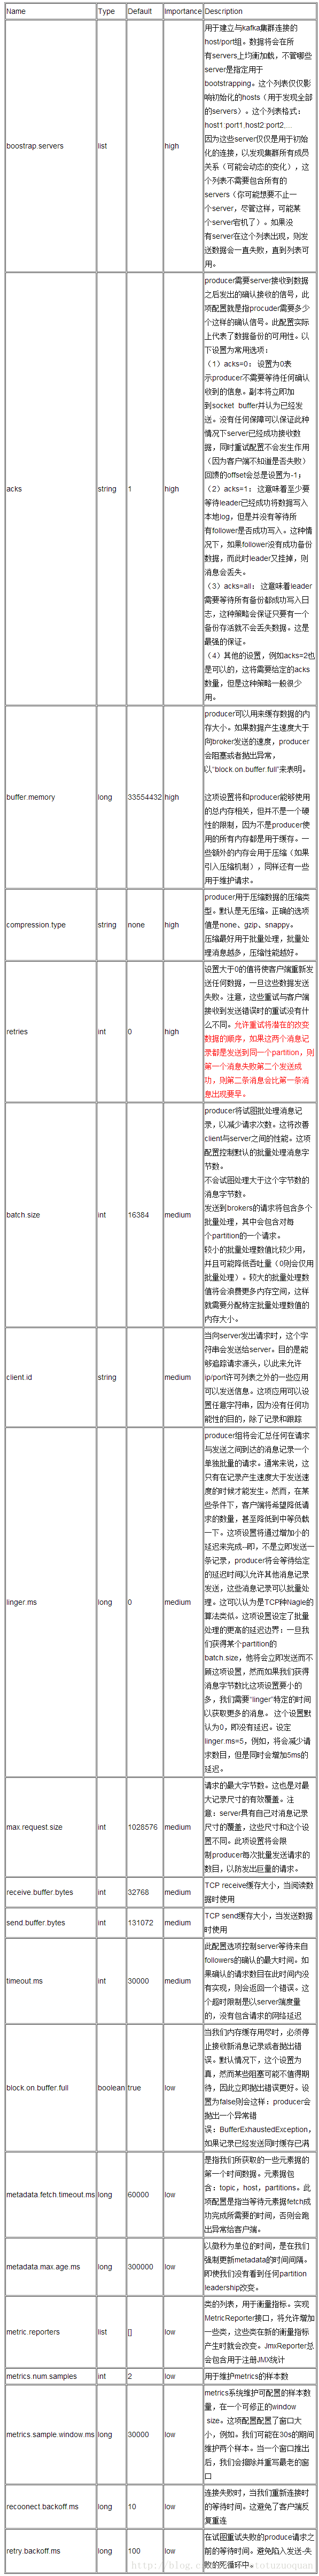
kafka-producer配置文件
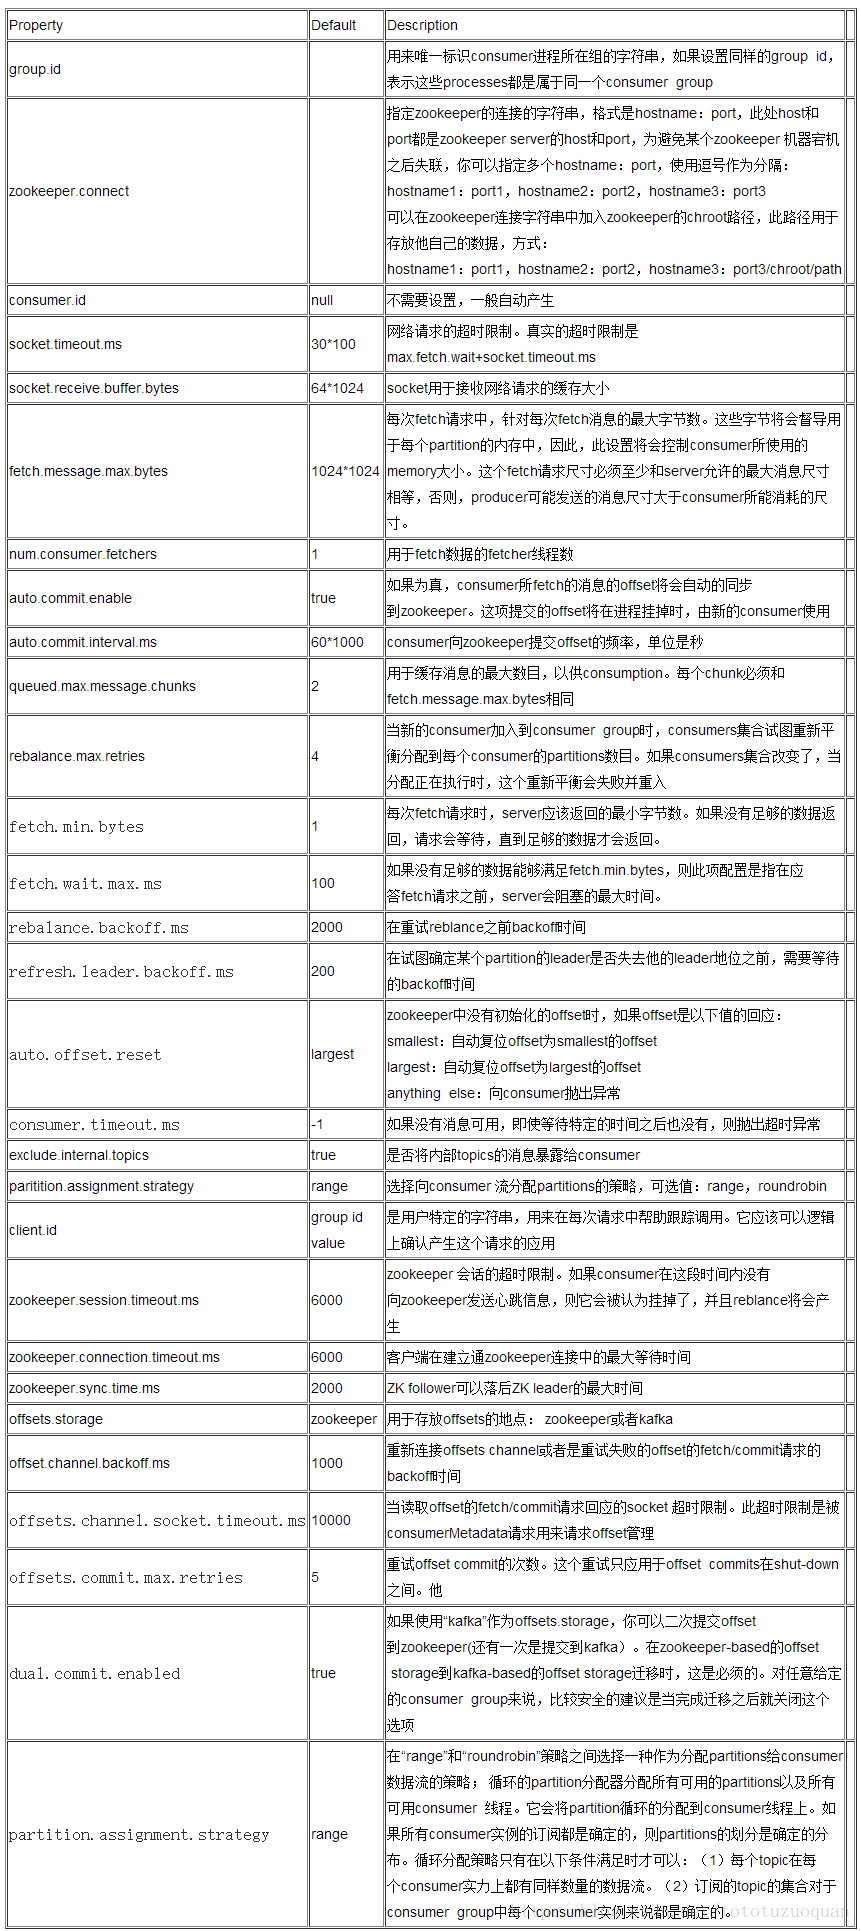
kafka-consumer配置文件
Kafka集群部署 (守护进程启动)的更多相关文章
- 分布式消息系统之Kafka集群部署
一.kafka简介 kafka是基于发布/订阅模式的一个分布式消息队列系统,用java语言研发,是ASF旗下的一个开源项目:类似的消息队列服务还有rabbitmq.activemq.zeromq:ka ...
- zookeeper集群+kafka集群 部署
zookeeper集群 +kafka 集群部署 1.Zookeeper 概述: Zookeeper 定义 zookeeper是一个开源的分布式的,为分布式框架提供协调服务的Apache项目 Zooke ...
- kafka 集群部署 多机多broker模式
kafka 集群部署 多机多broker模式 环境IP : 172.16.1.35 zookeeper kafka 172.16.1.36 zookeeper kafka 172.16 ...
- Zookeeper+Kafka集群部署(转)
Zookeeper+Kafka集群部署 主机规划: 10.200.3.85 Kafka+ZooKeeper 10.200.3.86 Kafka+ZooKeeper 10.200.3.87 Kaf ...
- 3、Kafka集群部署
Kafka集群部署 1)解压安装包 [ip101]$ tar -zxvf kafka_2.11-0.11.0.0.tgz -C /opt/app/ 2)修改解压后的文件名称 [ip101]$ mv k ...
- Zookeeper+Kafka集群部署
Zookeeper+Kafka集群部署 主机规划: 10.200.3.85 Kafka+ZooKeeper 10.200.3.86 Kafka+ZooKeeper 10.200.3.87 Kaf ...
- Kafka集群部署以及使用
Kafka集群部署 部署步骤 hadoop102 hadoop103 hadoop104 zk zk zk kafka kafka kafka http://kafka.apache.org/down ...
- 4 kafka集群部署及kafka生产者java客户端编程 + kafka消费者java客户端编程
本博文的主要内容有 kafka的单机模式部署 kafka的分布式模式部署 生产者java客户端编程 消费者java客户端编程 运行kafka ,需要依赖 zookeeper,你可以使用已有的 zo ...
- 基于Centos7xELK+Kafka集群部署方案
本次集群部署使用ELK版本统一为6.8.10,kafka为2.12-2.51 均可在官网下载 elasticsearch下载地址:https://www.elastic.co/cn/downloads ...
随机推荐
- PHPExcel正确读取excel表格时间单元格(转载)
error_reporting(E_ALL); date_default_timezone_set('Asia/shanghai'); /** PHPExcel_IOFactory */ requir ...
- 防止网页被别站用 iframe嵌套
将下面的代码加到您的页面 <head></head> 位置即可: <script language="javascript"> <!-- ...
- SQL 模糊查询LIKE concat用法
concat用来拼接查询的字符串,如下代码所示 SELECT * FROM deployment WHERE name LIKE concat(concat('%',#{queryMessage}), ...
- storm深入研究
著作权归作者所有.商业转载请联系作者获得授权,非商业转载请注明出处.作者:He Ransom链接:http://www.zhihu.com/question/23441639/answer/28075 ...
- 学习使用资源文件[11] - DLL 中的资源文件
本例将把一张 bmp 图片, 以资源文件的方式嵌入 dll, 然后再调用. 第一步: 建一个 DLL 工程, 如图: 然后保存, 我这里使用的名称都是默认的. 第二步: 建一个资源原文件, 如图: ...
- jQuery继承extend用法详解
/直接基于jQuery的扩展,判断是否为空 $.isBlank = function(obj){ return(typeof(obj)=='undefined'||obj==''||obj==nu ...
- VC++ :实现简单的文件拖放(Drag and Drop)功能
1) VC++ 6.0 新建一个基于对话框的MFC的工程,取名MfcDropFiles: 2) 去除默认的控件,包括确定/取消按钮,以及一个静态文本: 3) 在对话框空白区域拖放一个ListBox控件 ...
- python2.7.13环境搭建
查看当前系统中的 Python 版本,可以看到实验室的这台服务器已经安装了 Python 2.6.6 python --version 检查 CentOS 版本,我们可以看到这台服务器的 CentOS ...
- 查看当前mysql数据库实例中,支持的字符集有哪些,或者是否支持某个特定字符集
需求描述: 查看当前mysql实例中支持哪些字符集,过滤特定的字符集 操作过程: 1.通过show character set来进行查看 mysql> show character set; + ...
- mybatise 实现同一字段多模糊查询
mybatise 同一字段多模糊查询 <foreach collection="typeList" index="index" item="it ...