
python大战机器学习——半监督学习
半监督学习:综合利用有类标的数据和没有类标的数据,来生成合适的分类函数。它是一类可以自动地利用未标记的数据来提升学习性能的算法
1、生成式半监督学习
优点:方法简单,容易实现。通常在有标记数据极少时,生成式半监督学习方法比其他方法性能更好
缺点:假设的生成式模型必须与真实数据分布吻合。如果不吻合则可能效果很差。而如何给出与真实数据分布吻合的生成式模型,这就需要对问题领域的充分了解
2、图半监督学习
(1)标记传播算法:
优点:概念清晰
缺点:存储开销大,难以直接处理大规模数据;而且对于新的样本加入,需要对原图重构并进行标记传播
(2)迭代式标记传播算法:
输入:有标记样本集Dl,未标记样本集Du,构图参数δ,折中参数α
输出:未标记样本的预测结果y
步骤:
1)计算W
2)基于W构造标记传播矩阵S
3)根据公式初始化F<0>
4)t=0
5)迭代,迭代终止条件是F收敛至F*:
F<t+1>=αSF<t>+(1-α)Y
t=t+1
6)构造未标记样本的预测结果yi
7)输出结果y
LabelPropagation实验代码:
 import numpy as np

 import matplotlib.pyplot as plt

 from sklearn import metrics

 from sklearn import datasets

 from sklearn.semi_supervised import LabelPropagation

 def load_data():

     digits=datasets.load_digits()

     rng=np.random.RandomState(0)

     index=np.arange(len(digits.data))

     rng.shuffle(index)

     X=digits.data[index]

     Y=digits.target[index]

     n_labeled_points=int(len(Y)/10)

     unlabeled_index=np.arange(len(Y))[n_labeled_points:]

     return X,Y,unlabeled_index

 def test_LabelPropagation(*data):

     X,Y,unlabeled_index=data

     Y_train=np.copy(Y)

     Y_train[unlabeled_index]=-1

     cls=LabelPropagation(max_iter=100,kernel='rbf',gamma=0.1)

     cls.fit(X,Y_train)

     print("Accuracy:%f"%cls.score(X[unlabeled_index],Y[unlabeled_index]))

 X,Y,unlabeled_index=load_data()

 test_LabelPropagation(X,Y,unlabeled_index)
实验结果:
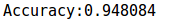 可见预测的准确率还是挺高的
LabelSpreading实验代码:
 import numpy as np

 import matplotlib.pyplot as plt

 from sklearn import metrics

 from sklearn import datasets

 from sklearn.semi_supervised import LabelPropagation,LabelSpreading

 def load_data():

     digits=datasets.load_digits()

     rng=np.random.RandomState(0)

     index=np.arange(len(digits.data))

     rng.shuffle(index)

     X=digits.data[index]

     Y=digits.target[index]

     n_labeled_points=int(len(Y)/10)

     unlabeled_index=np.arange(len(Y))[n_labeled_points:]

     return X,Y,unlabeled_index

 def test_LabelPropagation(*data):

     X,Y,unlabeled_index=data

     Y_train=np.copy(Y)

     Y_train[unlabeled_index]=-1

     cls=LabelPropagation(max_iter=100,kernel='rbf',gamma=0.1)

     cls.fit(X,Y_train)

     print("Accuracy:%f"%cls.score(X[unlabeled_index],Y[unlabeled_index]))

 def test_LabelSpreading(*data):

     X,Y,unlabeled_index=data

     Y_train=np.copy(Y)

     Y_train[unlabeled_index]=-1

     cls=LabelSpreading(max_iter=100,kernel='rbf',gamma=0.1)

     cls.fit(X,Y_train)

     predicted_labels=cls.transduction_[unlabeled_index]

     true_labels=Y[unlabeled_index]

     print("Accuracy:%f"%metrics.accuracy_score(true_labels,predicted_labels))

 X,Y,unlabeled_index=load_data()

 #test_LabelPropagation(X,Y,unlabeled_index)

 test_LabelSpreading(X,Y,unlabeled_index)
注:LabelSpreading类似于LabelPropagation,但是使用基于normalized graph Laplacian and soft clamping的距离矩阵
实验结果:
 预测效果也很不错
3、总结
半监督学习在利用未标记样本后并非必然提升泛化性能,在有些情况下甚至会导致性能下降。对生成式方法,原因通常是模型假设不准确。因此需要依赖充分可靠的领域知识来设计模型。更一般的安全半监督学习仍然是未加解决的难题。安全是指:利用未标记样本后,能确保返回性能至少不差于仅利用有标记样本
python大战机器学习——半监督学习的更多相关文章
- 吴裕雄 python 机器学习——半监督学习LabelSpreading模型
import numpy as np import matplotlib.pyplot as plt from sklearn import metrics from sklearn import d ...
- 吴裕雄 python 机器学习——半监督学习标准迭代式标记传播算法LabelPropagation模型
import numpy as np import matplotlib.pyplot as plt from sklearn import metrics from sklearn import d ...
- python大战机器学习——模型评估、选择与验证
1.损失函数和风险函数 (1)损失函数:常见的有 0-1损失函数 绝对损失函数 平方损失函数 对数损失函数 (2)风险函数:损失函数的期望 经验风险:模型在数据集T上的平均损失 根据大 ...
- python大战机器学习——数据预处理
数据预处理的常用流程: 1)去除唯一属性 2)处理缺失值 3)属性编码 4)数据标准化.正则化 5)特征选择 6)主成分分析 1.去除唯一属性 如id属性,是唯一属性,直接去除就好 2.处理缺失值 ( ...
- python大战机器学习——集成学习
集成学习是通过构建并结合多个学习器来完成学习任务.其工作流程为: 1)先产生一组“个体学习器”.在分类问题中,个体学习器也称为基类分类器 2)再使用某种策略将它们结合起来. 通常使用一种或者多种已有的 ...
- python大战机器学习——人工神经网络
人工神经网络是有一系列简单的单元相互紧密联系构成的,每个单元有一定数量的实数输入和唯一的实数输出.神经网络的一个重要的用途就是接受和处理传感器产生的复杂的输入并进行自适应性的学习,是一种模式匹配算法, ...
- python大战机器学习——支持向量机
支持向量机(Support Vector Machine,SVM)的基本模型是定义在特征空间上间隔最大的线性分类器.它是一种二类分类模型,当采用了核技巧之后,支持向量机可以用于非线性分类. 1)线性可 ...
- python大战机器学习——聚类和EM算法
注:本文中涉及到的公式一律省略(公式不好敲出来),若想了解公式的具体实现,请参考原著. 1.基本概念 (1)聚类的思想: 将数据集划分为若干个不想交的子集(称为一个簇cluster),每个簇潜在地对应 ...
- python大战机器学习——数据降维
注:因为公式敲起来太麻烦,因此本文中的公式没有呈现出来,想要知道具体的计算公式,请参考原书中内容 降维就是指采用某种映射方法,将原高维空间中的数据点映射到低维度的空间中 1.主成分分析(PCA) 将n ...
随机推荐
- 使用ceph命令提示handle_connect_reply connect got BADAUTHORIZER
输入命令提示如下错误: [root@node1 ~]# rados -p testpool ls 2017-10-21 06:13:25.743045 7f8f89b6d700 0 -- 192.16 ...
- 三 akka学习 actor的例子
(转载: http://blog.csdn.net/chenleixing/article/details/44044243 ) Java并发编程的4种风格:Threads,Executors,For ...
- GIF助手帮助说明
生成的文件位置? 生成的GIF等文件存储在 /sdcard/gifdir/ 目录下. 为什么分享到微信.Twitter等平台失败? 微信.Twitter等平台对GIF文件大小有限制,微信限制为1MB, ...
- [51nod1138]正整数分解为几个连续自然数之和
解题关键:注意为什么上界是$\sqrt {2n} $ 因为函数是关于m的递减函数,而结果必须为正整数 $a = \frac{{2n + m - {m^2}}}{{2m}} = \frac{n}{m} ...
- JOptionPane简介
------------------siwuxie095 JOptionPane 是弹出窗体(对话框)的集合类,它本身 并不是一个具体的 ...
- VS编译器中设置 输出窗口 只显示error,不显示warning 要如何配置
VS编译器中设置 输出窗口 只显示error,不显示warning 要如何配置 在编译大型项目的时候,总是VS编译器的输出窗口总是会出现一堆warning警告,要想在里面找到error错误,要使用鼠标 ...
- std::min error C2059: 语法错误:“::” 的解决方法
std::min error C2059: 语法错误:"::" 的解决方法 下面这段代码: size_t n = std::min(count_, num_elements); 编 ...
- PCLVisualizer可视化类(2)
博客转载自:http://www.pclcn.org/study/shownews.php?lang=cn&id=163 可视化点云颜色特征 所示,点赋予不同的颜色表征其对应的z轴值不同.PC ...
- Impala介绍
Impala介绍 Impala支持的文件格式 Impala可以对Hadoop中大多数格式的文件进行查询.它能通过create table和insert的方式将一部分格式的数据加载到table中,但值得 ...
- ubuntu 13.04 安装 JDK
ubuntu 13.04 安装 JDK 具体步骤参详了如下链接: http://blog.csdn.net/yang_hui1986527/article/details/6677450 1.到 Su ...