
python3爬虫——下载unsplash美图到本地
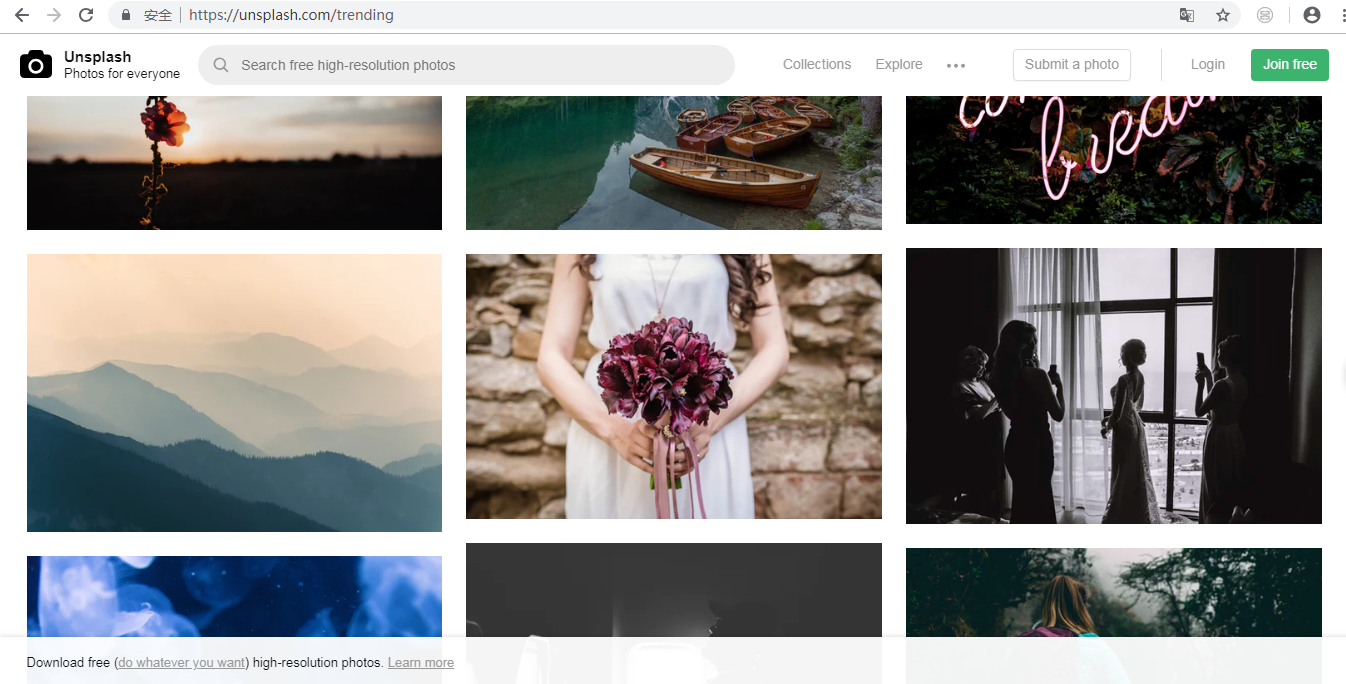
最近发现一个网站www.unsplash.com ( 没有广告费哈,纯粹觉得不错 ),网页做得很美观,上面也都是一些免费的摄影照片,觉得很好看,就决定利用蹩脚的技能写个爬虫下载图片。
先随意感受一下这个网站:
接下来开始对网页进行解析:
在该网页检查元素,选择其中一张图片查看它的代码
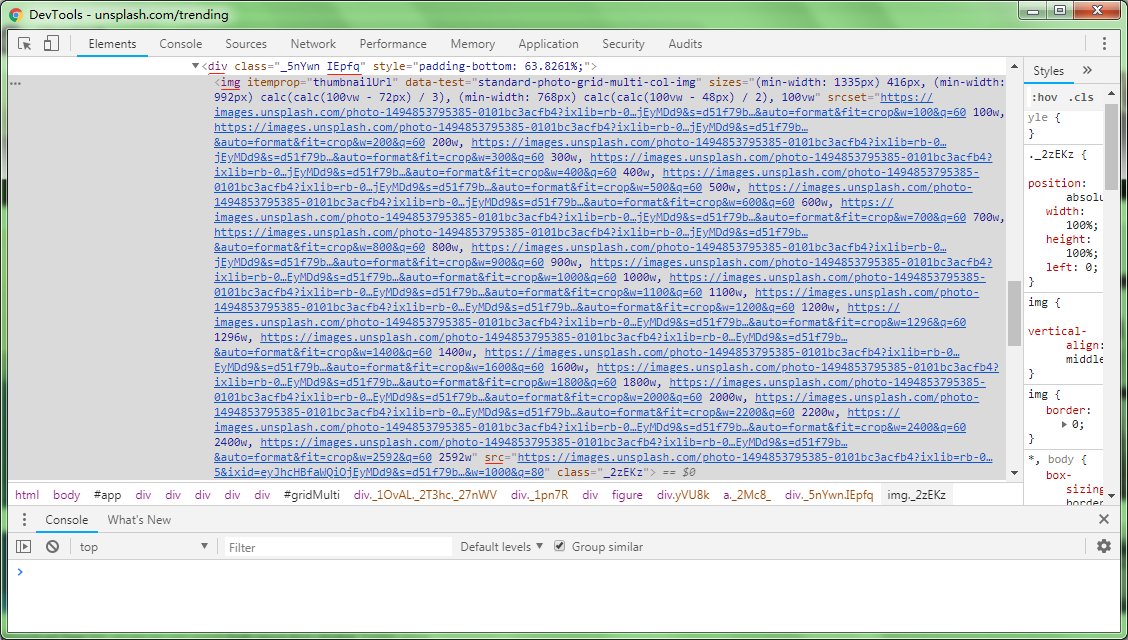
可以看到,图片 img 在一个 div 的 tag 里面,而且 class = ”IEpfq“,不过那么多内容,虽然有点乱,但其实看 src = ” “ 就行了。
但这只是一张图片的内容,得再看看其他的图片是不是一样。检查一下发现都是这样。这样子就算解析完成了。可以开始写代码了
 #!/usr/bin/env python

 # _*_ coding utf-8 _*_

 from bs4 import BeautifulSoup

 import requests

 i = 0

 url = 'https://unsplash.com/'

 html = requests.get(url)

 soup = BeautifulSoup(html.text, 'lxml')

 img_class = soup.find_all('div', {"class": "IEpfq"})        # 找到div里面有class = "IEpfq"的内容

 for img_list in img_class:

     imgs = img_list.find_all('img')                         # 接着往下找到 img 标签

     for img in imgs:

         src = img['src']                                    # 以"src"为 key,找到 value

         r = requests.get(src, stream=True)

         image_name = 'unsplash_' + str(i) + '.jpg'          # 图片命名

         i += 1

         with open('./img/%s' % image_name, 'wb') as file:   # 打开文件

             for chunk in r.iter_content(chunk_size=1024):   # 以chunk_size = 1024的长度进行遍历

                 file.write(chunk)

         print('Saved %s' % image_name)
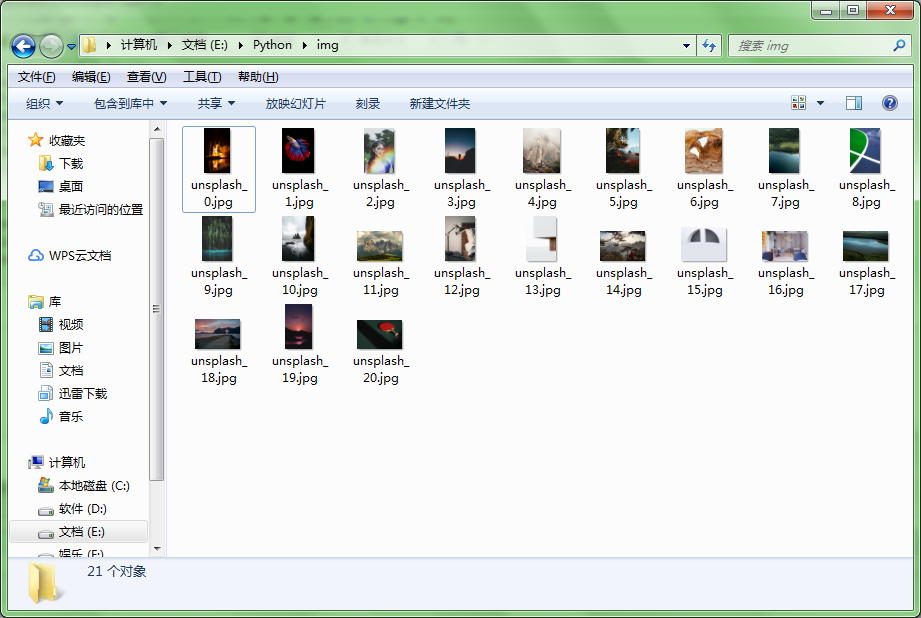
运行结果:
Saved unsplash_0.jpg

Saved unsplash_1.jpg

         ......

Saved unsplash_19.jpg

Saved unsplash_20.jpg
python3爬虫——下载unsplash美图到本地的更多相关文章
- 自学Python九 爬虫实战二(美图福利)
作为一个新世纪有思想有文化有道德时刻准备着的屌丝男青年,在现在这样一个社会中,心疼我大慢播抵制大百度的前提下,没事儿上上网逛逛YY看看斗鱼翻翻美女图片那是必不可少的,可是美图虽多翻页费劲!今天我们就搞 ...
- python 站点爬虫 下载在线盗墓笔记小说到本地的脚本
近期闲着没事想看小说,找到一个全是南派三叔的小说的站点,决定都下载下来看看,于是动手,在非常多QQ群里高手的帮助下(本人正則表達式非常烂.程序复杂的正则都是一些高手指导的),花了三四天写了一个脚本 须 ...
- 【Python3网络爬虫开发实战】6.4-分析Ajax爬取今日头条街拍美图【华为云技术分享】
[摘要] 本节中,我们以今日头条为例来尝试通过分析Ajax请求来抓取网页数据的方法.这次要抓取的目标是今日头条的街拍美图,抓取完成之后,将每组图片分文件夹下载到本地并保存下来. 1. 准备工作 在本节 ...
- 【Python3网络爬虫开发实战】 分析Ajax爬取今日头条街拍美图
前言本文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理.作者:haoxuan10 本节中,我们以今日头条为例来尝试通过分析Ajax请求 ...
- 转:【Python3网络爬虫开发实战】6.4-分析Ajax爬取今日头条街拍美图
[摘要] 本节中,我们以今日头条为例来尝试通过分析Ajax请求来抓取网页数据的方法.这次要抓取的目标是今日头条的街拍美图,抓取完成之后,将每组图片分文件夹下载到本地并保存下来. 1. 准备工作 在本节 ...
- Python3爬虫系列:理论+实验+爬取妹子图实战
Github: https://github.com/wangy8961/python3-concurrency-pics-02 ,欢迎star 爬虫系列: (1) 理论 Python3爬虫系列01 ...
- python爬虫之分析Ajax请求抓取抓取今日头条街拍美图(七)
python爬虫之分析Ajax请求抓取抓取今日头条街拍美图 一.分析网站 1.进入浏览器,搜索今日头条,在搜索栏搜索街拍,然后选择图集这一栏. 2.按F12打开开发者工具,刷新网页,这时网页回弹到综合 ...
- Qt Quick 图像处理实例之美图秀秀(附源代码下载)
在<Qt Quick 之 QML 与 C++ 混合编程具体解释>一文中我们解说了 QML 与 C++ 混合编程的方方面面的内容,这次我们通过一个图像处理应用.再来看一下 QML 与 C++ ...
- python3爬虫(4)各种网站视频下载方法
python3爬虫(4)各种网站视频下载方法原创H-KING 最后发布于2019-01-09 11:06:23 阅读数 13608 收藏展开理论上来讲只要是网上(浏览器)能看到图片,音频,视频,都能够 ...
随机推荐
- Java并发集合(一)-CopyOnWriteArrayList分析与使用
CopyOnWriteArrayList分析与使用 原文链接: http://ifeve.com/java-copy-on-write/ 一.Copy-On-Write Copy-On-Write简称 ...
- AC自动机——1 Trie树(字典树)介绍
AC自动机——1 Trie树(字典树)介绍 2013年10月15日 23:56:45 阅读数:2375 之前,我们介绍了Kmp算法,其实,他就是一种单模式匹配.当要检查一篇文章中是否有某些敏感词,这其 ...
- Web 研发模式的演变
前不久徐飞写了一篇很好的文章:Web 应用的组件化开发.本文尝试从历史发展角度,说说各种研发模式的优劣. 一.简单明快的早期时代 可称之为 Web 1.0 时代,非常适合创业型小项目,不分前后端,经常 ...
- Python:每日一题002
题目: 企业发放的奖金根据利润提成.利润(I)低于或等于10万元时,奖金可提10%:利润高于10万元,低于20万元时,低于10万元的部分按10%提成,高于10万元的部分,可提成7.5%:20万到40万 ...
- leveldb 学习记录(四)Log文件
前文记录 leveldb 学习记录(一) skiplistleveldb 学习记录(二) Sliceleveldb 学习记录(三) MemTable 与 Immutable Memtablelevel ...
- 可以用到的XSS跨站语句
我们常用的测试XSS跨站的语句一般是alert比如: <script>alert(“sex”)</script> <script>alert(/sex/)</ ...
- C#语言不常用语法笔记
只看过3天C#语法书,了解个大概,与C++等不同之处,或者看开源遇到一些奇异用法,记录一下,脑子不够用的情况下,还是记笔记靠谱. ==================== 顺便吐槽下,这年头得会各种编 ...
- python闭包和延迟绑定
一.什么是闭包: 1.函数内定义函数. 2.外函数的返回时内函数的引用. 3.内函数使用外函数的局部变量(至少一个). 1 def outfunc(): 2 for num in range(4): ...
- 【慕课网实战】Spark Streaming实时流处理项目实战笔记十六之铭文升级版
铭文一级: linux crontab 网站:http://tool.lu/crontab 每一分钟执行一次的crontab表达式: */1 * * * * crontab -e */1 * * * ...
- golang注意问题
关于slice 我们都知道slice是在通过参数传递的时候传递的是引用 slice的appen操作是有返回值的,并不改变原值 例如 b := [],,,} c:=append(b, ) // b 不变 ...