
scrapy 部署
下面简单介绍两种部署的方式,crontab定时任务+日志,第二种则是scrapyd+spiderkeeper,更推荐后者,图形界面的方式,管理方便,清晰。
scrapy 开发调试
1、在spiders同目录下新建一个run.py文件,内容如下(列表里面最后可以加上参数,如--nolog)
2、下面命令只限于,快速调试的作用或一个项目下单个spider的爬行任务。
from scrapy.cmdline import execute

execute(['scrapy','crawl','app1'])
多爬虫并发:
1、在spiders同级创建任意目录,如:commands
2、在其中创建 crawlall.py 文件 (此处文件名就是自定义的命令)
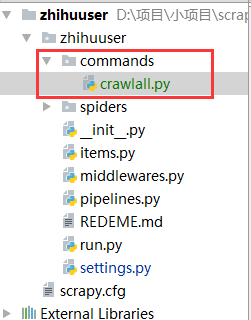
crawlall.py
from scrapy.commands import ScrapyCommand

from scrapy.crawler import CrawlerRunner

from scrapy.exceptions import UsageError

from scrapy.utils.conf import arglist_to_dict

class Command(ScrapyCommand):

    requires_project = True

    def syntax(self):

        return '[options]'

    def short_desc(self):

        return 'Runs all of the spiders'

    def add_options(self, parser):

        ScrapyCommand.add_options(self, parser)

        parser.add_option("-a", dest="spargs", action="append", default=[], metavar="NAME=VALUE",

                          help="set spider argument (may be repeated)")

        parser.add_option("-o", "--output", metavar="FILE",

                          help="dump scraped items into FILE (use - for stdout)")

        parser.add_option("-t", "--output-format", metavar="FORMAT",

                          help="format to use for dumping items with -o")

    def process_options(self, args, opts):

        ScrapyCommand.process_options(self, args, opts)

        try:

            opts.spargs = arglist_to_dict(opts.spargs)

        except ValueError:

            raise UsageError("Invalid -a value, use -a NAME=VALUE", print_help=False)

    def run(self, args, opts):

        # settings = get_project_settings()

        spider_loader = self.crawler_process.spider_loader

        for spidername in args or spider_loader.list():

            print("*********cralall NewsSpider************")

            self.crawler_process.crawl(spidername, **opts.spargs)

        self.crawler_process.start()
3、到这里还没完,settings.py配置文件还需要加一条。
COMMANDS_MODULE = ‘项目名称.目录名称’
COMMANDS_MODULE = 'NewSpider.commands'
4、执行命令
$ scrapy crawlall
5、 日志输出,
# 保存log信息的文件名

LOG_FILE = "myspider.log"

LOG_LEVEL = "INFO"
scrapyd+spiderkeeper
1.安装
$ pip install scrapyd

$ pip install scrapyd-client

$ pip install spiderkeeper
2.配置
配置scrapy.cfg文件,取消注释url
[settings]

default = project.settings

[deploy:project_deploy]

url = http://localhost:6800/

project = project

username = root

password = password
scrapyd-deploy在linux和mac下可运行,windows下需在python/scripts路径下新建scrapyd-deploy.bat,注意了,下面python路径以及scrapyd-deploy路径需要修改
@echo off

"C:\Users\CZN\scrapyVir\Scripts\python.exe" "C:\Users\CZN\scrapyVir\Scripts\scrapyd-deploy" %1 %2 %3 %4 %5 %6 %7 %8 %9
cmd下进入scrapy项目根目录,
1)敲入scrapyd-deploy -l
project http://localhost:6800/
2)敲入scrapy list 显示 spider 列表
LOG_STDOUT = True # 大坑,导致scrapy list 失效
3)scrapyd #在scrapy.cfg同路径下启动scrapyd服务器 端口6800
4)spiderkeeper --server=http://localhost:6800 --username=root --password=password #启动spiderkeep 端口5000
5)scrapyd-deploy project_deploy -p project #发布工程到scrapyd
成功返回json数据
6)scrapyd-deploy --build-egg output.egg #生成output.egg文件
7)spiderkeep图形界面上传output.egg即可
部署完成,设置定时爬取任务或启动单个spider
settings.py 几个具有普适性配置
# Obey robots.txt rules

ROBOTSTXT_OBEY = False

CONCURRENT_REQUESTS = 32

DOWNLOAD_DELAY = 0.1

DOWNLOAD_TIMEOUT = 10

RETRY_TIMES = 5

# The download delay setting will honor only one of:

#CONCURRENT_REQUESTS_PER_DOMAIN = 16

#CONCURRENT_REQUESTS_PER_IP = 16

COOKIES_ENABLED = False
scrapy 部署的更多相关文章
- scrapy爬虫学习系列三:scrapy部署到scrapyhub上
系列文章列表: scrapy爬虫学习系列一:scrapy爬虫环境的准备: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_00 ...
- centos环境的python、scrapy部署
1 操作系统 Centos 6.5 64bit 或以上版本 2 软件环境 提示:(1)用什么软件:(2)运行环境(3)开发包. Python:Python-2.7.6.tgz Scrapy:Scrap ...
- 【爬虫】将 Scrapy 部署到 k8s
一. 概述 因为学习了 docker 和 k8s ,不管什么项目都想使用容器化部署,一个最主要的原因是,使用容器化部署是真的方便.上一篇文章 [爬虫]从零开始使用 Scrapy 介绍了如何使用 scr ...
- 如何将Scrapy 部署到Scrapyd上?
安装上传工具 1.上传工具 scrapyd-client 2.安装方法: pip install scrapyd-client 3.上传方法: python d:\Python27\Scripts\s ...
- 爬虫(十八):scrapy分布式部署
scrapy部署神器-scrapyd -->GitHub地址 -->官方文档 一:安装scrapyd 安装:pip3 install scrapyd 这里我在另外一台ubuntu lin ...
- Scrapy 爬虫框架入门案例详解
欢迎大家关注腾讯云技术社区-博客园官方主页,我们将持续在博客园为大家推荐技术精品文章哦~ 作者:崔庆才 Scrapy入门 本篇会通过介绍一个简单的项目,走一遍Scrapy抓取流程,通过这个过程,可以对 ...
- scrapy爬虫学习系列五:图片的抓取和下载
系列文章列表: scrapy爬虫学习系列一:scrapy爬虫环境的准备: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_00 ...
- scrapy爬虫学习系列四:portia的学习入门
系列文章列表: scrapy爬虫学习系列一:scrapy爬虫环境的准备: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_00 ...
- scrapy爬虫学习系列二:scrapy简单爬虫样例学习
系列文章列表: scrapy爬虫学习系列一:scrapy爬虫环境的准备: http://www.cnblogs.com/zhaojiedi1992/p/zhaojiedi_python_00 ...
随机推荐
- Luogu P1966 火柴排队
这还是一道比较简单的题目,稍微想一下就可以解决.终于有NOIP难度的题目了 首先我们看那个∑(ai-bi)^2的式子,发现这个的最小值就是排序不等式 所以我们只需要改变第一组火柴的顺序,使它和第二组火 ...
- [Oacle][Partition]Partition操作与 Index, Global Index 的关系
[Oacle][Partition]Partition操作与 Index, Global Index 的关系: ■ Regarding the local index and the global i ...
- ABP+AdminLTE+Bootstrap Table权限管理系统第十一节--Bootstrap Table用户管理列表以及Module Zero之用户管理
返回总目录:ABP+AdminLTE+Bootstrap Table权限管理系统一期 用户实体 用户实体代表应用的一个用户,它派生自AbpUser类,如下所示: public class User : ...
- Nagios图像绘制插件PNP4Nagios部署和测试
注:本篇博客Nagios版本Nagios-3.5.1 1. 概述2. 关于PNP4Nagios3. 部署PNP4Nagios3.1 下载PNP4Nagios3.2 编译安装3.3 目录文件说明4. 配 ...
- Nginx中防盗链(下载防盗链和图片防盗链)及图片访问地址操作记录
日常运维工作中,设置防盗链的需求会经常碰到,这也是优化网站的一个必要措施.今天在此介绍Nginx中设置下载防盗链和图片防盗链的操作~ 一.Nginx中下载防盗链的操作记录对于一些站点上的下载操作,有很 ...
- LVS负载均衡-基础知识梳理
一. 集群的概念 服务器集群简称集群是一种服务器系统,它通过一组松散集成的服务器软件和/或硬件连接起来高度紧密地协作完成计算工作.在某种意义上,他们可以被看作是一台服务器.集群系统中的单个服务器通常称 ...
- iOS网络请求安全认证(JWT,RSA)
在网络世界中,安全是一个很重要的问题,以往的HTTP请求已经不能承担这个安全任务,抓包工具一抓,你的所有网络请求全都曝光.当然,你可能会采用加密算法来加密数据,但是这仍然不够. 在移动端和服务器的通信 ...
- Java Swing 实现系统托盘图标
在实现托盘图标时,出现弹出式菜单显示中文乱码,无法显示正确的文字 查询相关资料后发现是字符编码不匹配,查询资料出处 解决方法 1.通过修改Java项目的默认编码为GBK: 2.在Run Configu ...
- Axios插件和loading的实现
axios插件就是一个ajax插件 axios具有ajax的所有方法如 get post delete put等等的方法 使用时只需要引入即可 如import Axios form 'axios' 不 ...
- [读书笔记]SQLSERVER企业级平台管理实践读书笔记02
记录一下 这一块 join的理解了 再完善过来. 1. Statistics的用法: 清空执行计划用的命令 dbcc freeproccache 清空buffer pool 里面的缓存命令 dbcc ...