
crawlspider爬虫:定义url规则
spider爬虫,适合meta传参的爬虫(列表页,详情页都有数据要爬取的时候)
crawlspider爬虫,适合不用meta传参的爬虫
scrapy genspider -t crawl it it.com
# -*- coding: utf-8 -*-

import scrapy

from scrapy.linkextractors import LinkExtractor

from scrapy.spiders import CrawlSpider, Rule

from Sun.items import SunItem

class DongguanSpider(CrawlSpider):

    name = 'dongguan'

    # 修改允许的域

    allowed_domains = ['sun0769.com']

    # 修改起始的url

    start_urls = ['http://wz.sun0769.com/index.php/question/questionType?type=4']

    rules = (

        # 构建列表url的提取规则

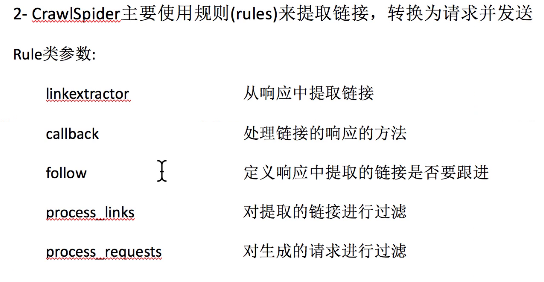
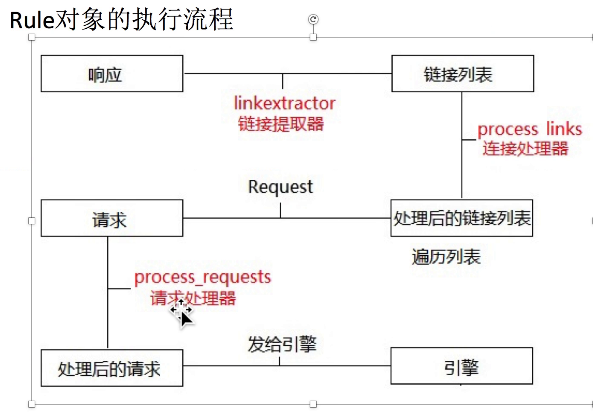
        Rule(LinkExtractor(allow=r'questionType'), follow=True),

        # 构建详情页面url提取规则

        # 'html/question/201711/352271.shtml'

        Rule(LinkExtractor(allow=r'html/question/\d+/\d+.shtml'), callback='parse_item'),

    )

    def parse_item(self, response):

        # print (response.url,'--------')

        # 构建item实例

        item = SunItem()

        # 抽取数据,将数据存放到item中

        item['number'] = response.xpath('/html/body/div[6]/div/div[1]/div[1]/strong/text()').extract()[0].split(':')[-1].strip()

        item['title'] = response.xpath('/html/body/div[6]/div/div[1]/div[1]/strong/text()').extract()[0].split(':')[-1].split(' ')[0]

        item['link'] = response.url

        data = ''.join(response.xpath('//div[@class="c1 text14_2"]/text()|//div[@class="contentext"]/text()').extract())

        item['content'] = data.replace('\xa0','')

        # print(item)

        # 返回数据

        yield item
链接提取器的使用
scrapy shell http://hr.tencent.com/position.php
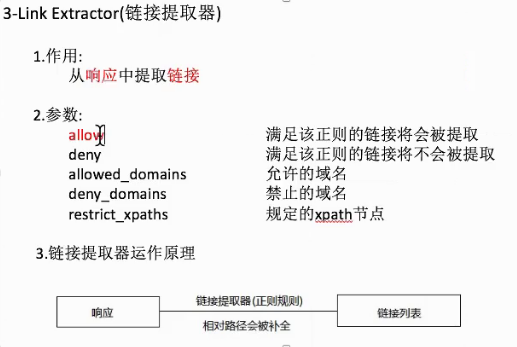
>>> from scrapy.linkextractors import LinkExtractor
>>> le = LinkExtractor(allow=('position_detail.php\?id=\d+&keywords=&tid=0&lid=0'))
或者直接 le = LinkExtractor(allow=('position_detail.php')) 也可以
>>> links=le.extract_links(response)
>>> for link in links:
... print(link)
...
>>> for link in links:
... print(link.url)
...


crawlspider爬虫:定义url规则的更多相关文章
- scrapy进阶(CrawlSpider爬虫__爬取整站小说)
# -*- coding: utf-8 -*- import scrapy,re from scrapy.linkextractors import LinkExtractor from scrapy ...
- Django学习(四) Django提供的后台管理系统以及如何定义URL路由
一旦你建立了模型Models,那么Django就可以为你创建一个专业的,可以提供给生成用的后台管理站点.这个站点可以提供给有权限的人进行已有模型Models数据的增删改查. 将新建的模型Models是 ...
- python爬虫主要就是五个模块:爬虫启动入口模块,URL管理器存放已经爬虫的URL和待爬虫URL列表,html下载器,html解析器,html输出器 同时可以掌握到urllib2的使用、bs4(BeautifulSoup)页面解析器、re正则表达式、urlparse、python基础知识回顾(set集合操作)等相关内容。
本次python爬虫百步百科,里面详细分析了爬虫的步骤,对每一步代码都有详细的注释说明,可通过本案例掌握python爬虫的特点: 1.爬虫调度入口(crawler_main.py) # coding: ...
- scrapy 中crawlspider 爬虫
爬取目标网站: http://www.chinanews.com/rss/rss_2.html 获取url后进入另一个页面进行数据提取 检查网页: 爬虫该页数据的逻辑: Crawlspider爬虫类: ...
- 《玩转Django2.0》读书笔记-编写URL规则
<玩转Django2.0>读书笔记-编写URL规则 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. URL(Uniform Resource Locator,统一资源定位 ...
- Scrapy - CrawlSpider爬虫
crawlSpider 爬虫 思路: 从response中提取满足某个条件的url地址,发送给引擎,同时能够指定callback函数. 1. 创建项目 scrapy startproject mysp ...
- 创建CrawlSpider爬虫简要步骤
创建CrawlSpider爬虫简要步骤: 1. 创建项目文件: e.g: scrapy startproject douyu (douyu为项目名自定义) 2. 进入项目文件: e.g: cd dou ...
- dt框架自定义url规则
destoon的列表的地址规则是定义在/api/url.inc.php,然后又是在include/global.func.php中进行的listpages这个函数调用实现 if($page < ...
- PHPCMS V9静态化HTML生成设置及URL规则优化
先讲讲Phpcms V9在后台怎么设置生成静态化HTML,之后再讲解怎么自定义URL规则,进行URL地址优化.在这一篇中,伪静态就不涉及了,大家可以移步到Phpcms V9全站伪静态设置方法. 一.静 ...
随机推荐
- mysql基础知识笔记
Mysql基础笔记 环境配置 基本概念 mysql命令行 进入 use show 查询 select order by where like 数据过滤regexp concat 文本函数 日期函数 数 ...
- 在linux下如何判断是否已经安装某个软件?
如果你使用rpm -ivh matlab装的,用rpm -qa | grep matlab肯定是能够找到的. 如果你是用make && make install装的.那么最好直接去找执 ...
- codeforces水题100道 第十题 Codeforces Round #277 (Div. 2) A. Calculating Function (math)
题目链接:www.codeforces.com/problemset/problem/486/A题意:求表达式f(n)的值.(f(n)的表述见题目)C++代码: #include <iostre ...
- 《转载》Tomcat内存设置详解
原文地址:Java内存溢出详解 一.常见的Java内存溢出有以下三种: 1. java.lang.OutOfMemoryError: Java heap space ----JVM Heap(堆)溢出 ...
- Androd Toolbar 的简单使用(转)
14年Android开发者大会提出了Android5.0 系统以及 材料设置 Material Design.在 材料设计中推出了大量的UI效果,其中某些功能 已添加进 兼容包,所以可以在低版本中来实 ...
- Mobx与Redux区别
Mobx的实现思想和Vue几乎一样,所以其优点跟Vue也差不多:通过监听数据(对象.数组)的属性变化,可以通过直接在数据上更改就能触发UI的渲染,从而做到MVVM.响应式.上手成本低.开发效率高,在数 ...
- php curl-class post
use \Curl\Curl; $curl = new Curl();$curl->setHeader('Content-Type', 'application/json');$curl-> ...
- Elasticsearch学习之快速入门案例
1. document数据格式 面向文档的搜索分析引擎 (1)应用系统的数据结构都是面向对象的,复杂的(2)对象数据存储到数据库中,只能拆解开来,变为扁平的多张表,每次查询的时候还得还原回对象格式,相 ...
- Internet Explorer 9 已安装在此系统上
问题: win7系统,IE11浏览器,想换成IE9,安装IE9的时候,提示错误. 解决方案: 方案一: 1.打开 控制面板--程序--程序和功能--点击打开或者关闭Windows功能,找到Intern ...
- 前端开发利器 Emmet 介绍与基础语法教程
在前端开发的过程中,编写 HTML.CSS 代码始终占据了很大的工作比例.特别是手动编写 HTML 代码,效率特别低下,因为需要敲打各种“尖括号”.闭合标签等.而现在 Emmet 就是为了提高代码编写 ...