
scrapy-splash抓取动态数据例子八
一、介绍
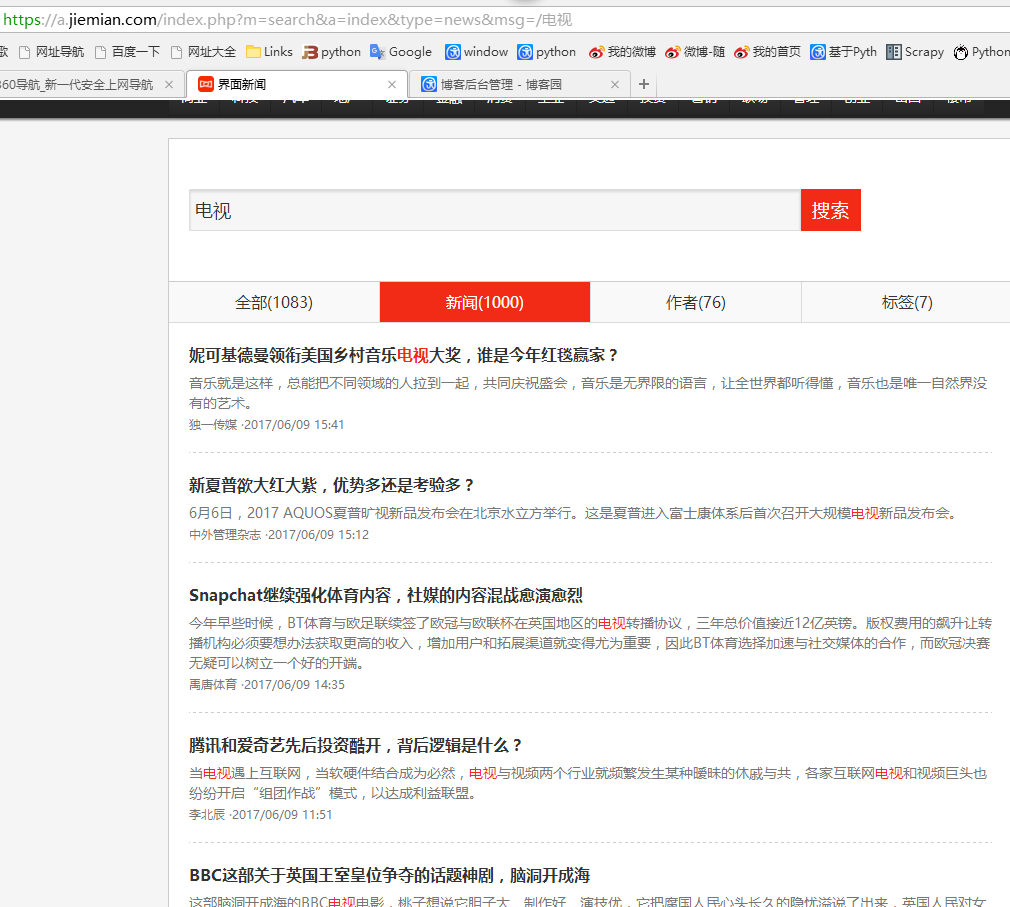
本例子用scrapy-splash抓取界面网站给定关键字抓取咨询信息。
给定关键字:个性化;融合;电视
抓取信息内如下:
1、资讯标题
2、资讯链接
3、资讯时间
4、资讯来源
二、网站信息
三、数据抓取
针对上面的网站信息,来进行抓取
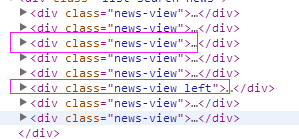
1、首先抓取信息列表
抓取代码:sels = site.xpath('//div[contains(@class,"news-view")]')
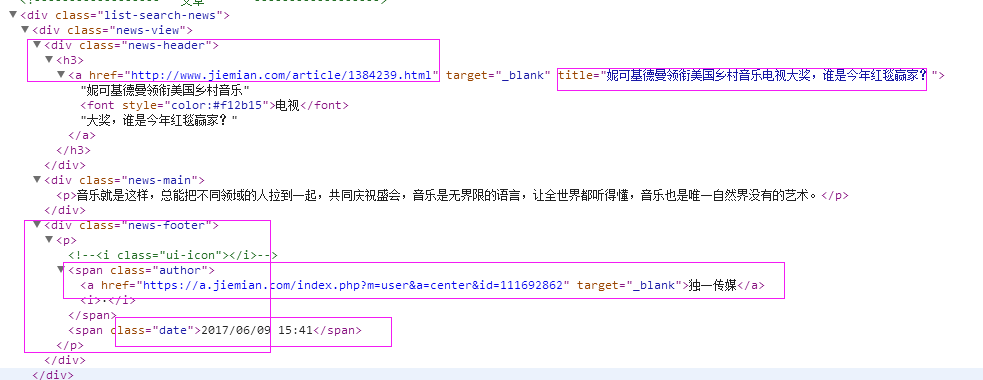
2、抓取标题
抓取代码:title = sel.xpath('.//div[@class="news-header"]/h3/a/@title')[0].extract()
3、抓取链接
抓取代码:it['url'] = sel.xpath('.//div[@class="news-header"]/h3/a/@href')[0].extract()
4、抓取日期
抓取代码:dates = sel.xpath('.//div[@class="news-footer"]/p/span[2]/text()')
5、抓取来源
抓取代码:sources =sel.xpath('.//div[@class="news-footer"]/p/span[1]/a/text()')
四、完整代码
# -*- coding: utf-8 -*-

import scrapy

from scrapy import Request

from scrapy.spiders import Spider

from scrapy_splash import SplashRequest

from scrapy_splash import SplashMiddleware

from scrapy.http import Request, HtmlResponse

from scrapy.selector import Selector

from scrapy_splash import SplashRequest

from splash_test.items import SplashTestItem

import IniFile

import sys

import os

import re

import time

reload(sys)

sys.setdefaultencoding('utf-8')

# sys.stdout = open('output.txt', 'w')

class jiemianSpider(Spider):

    name = 'jiemian'

    configfile = os.path.join(os.getcwd(), 'splash_test\spiders\setting.conf')

    cf = IniFile.ConfigFile(configfile)

    information_keywords = cf.GetValue("section", "information_keywords")

    information_wordlist = information_keywords.split(';')

    websearchurl = cf.GetValue("jiemian", "websearchurl")

    start_urls = []

    for word in information_wordlist:

        print websearchurl + word

        start_urls.append(websearchurl + word)

    # request需要封装成SplashRequest

    def start_requests(self):

        for url in self.start_urls:

            index = url.rfind('=')

            yield SplashRequest(url

                                , self.parse

                                , args={'wait': ''},

                                meta={'keyword': url[index + 1:]}

                                )

    def Comapre_to_days(self,leftdate, rightdate):

        '''

        比较连个字符串日期,左边日期大于右边日期多少天

        :param leftdate: 格式:2017-04-15

        :param rightdate: 格式:2017-04-15

        :return: 天数

        '''

        l_time = time.mktime(time.strptime(leftdate, '%Y-%m-%d'))

        r_time = time.mktime(time.strptime(rightdate, '%Y-%m-%d'))

        result = int(l_time - r_time) / 86400

        return result

    def date_isValid(self, strDateText):

        currentDate = time.strftime('%Y-%m-%d')

        datePattern = re.compile(r'\d{4}-\d{1,2}-\d{1,2}')

        dt = strDateText.replace('/', '-')

        strDate = re.findall(datePattern, dt)

        if len(strDate) == 1:

            if self.Comapre_to_days(currentDate, strDate[0]) == 0:

                return True, currentDate

        return False, ''

    def parse(self, response):

        site = Selector(response)

        sels = site.xpath('//div[contains(@class,"news-view")]')

        keyword = response.meta['keyword']

        item_list = []

        for sel in sels:

            dates = sel.xpath('.//div[@class="news-footer"]/p/span[2]/text()')

            flag,date =self.date_isValid(dates[0].extract())

            title = sel.xpath('.//div[@class="news-header"]/h3/a/@title')[0].extract()

            if  flag and title.find(keyword)>-1:

                it = SplashTestItem()

                it['title'] = title

                it['url'] = sel.xpath('.//div[@class="news-header"]/h3/a/@href')[0].extract()

                it['date'] = date

                it['keyword'] = keyword

                sources =sel.xpath('.//div[@class="news-footer"]/p/span[1]/a/text()')

                if len(sources)>0:

                    it['source'] = sources[0].extract()

                item_list.append(it)

        return item_list
scrapy-splash抓取动态数据例子八的更多相关文章
- scrapy-splash抓取动态数据例子一
目前,为了加速页面的加载速度,页面的很多部分都是用JS生成的,而对于用scrapy爬虫来说就是一个很大的问题,因为scrapy没有JS engine,所以爬取的都是静态页面,对于JS生成的动态页面都无 ...
- scrapy-splash抓取动态数据例子七
一.介绍 本例子用scrapy-splash抓取36氪网站给定关键字抓取咨询信息. 给定关键字:个性化:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二.网站信 ...
- scrapy-splash抓取动态数据例子六
一.介绍 本例子用scrapy-splash抓取中广互联网站给定关键字抓取咨询信息. 给定关键字:打通:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二.网站信 ...
- scrapy-splash抓取动态数据例子五
一.介绍 本例子用scrapy-splash抓取智能电视网网站给定关键字抓取咨询信息. 给定关键字:打通:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二.网站 ...
- scrapy-splash抓取动态数据例子四
一.介绍 本例子用scrapy-splash抓取微众圈网站给定关键字抓取咨询信息. 给定关键字:打通:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二.网站信息 ...
- scrapy-splash抓取动态数据例子三
一.介绍 本例子用scrapy-splash抓取今日头条网站给定关键字抓取咨询信息. 给定关键字:打通:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二.网站信 ...
- scrapy-splash抓取动态数据例子二
一.介绍 本例子用scrapy-splash抓取一点资讯网站给定关键字抓取咨询信息. 给定关键字:打通:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二.网站信 ...
- scrapy-splash抓取动态数据例子十六
一.介绍 本例子用scrapy-splash爬取梅花网(http://www.meihua.info/a/list/today)的资讯信息,输入给定关键字抓取微信资讯信息. 给定关键字:数字:融合:电 ...
- scrapy-splash抓取动态数据例子十五
一.介绍 本例子用scrapy-splash爬取电视之家(http://www.tvhome.com/news/)网站的资讯信息,输入给定关键字抓取微信资讯信息. 给定关键字:数字:融合:电视 抓取信 ...
随机推荐
- %和format的区别
在python中字符串的格式化分为两种:%和format.那么我们在什么时候来使用它们呢?它们有什么区别呢? 举个例子:我们根据一个坐标来表示一个动作 #定义一个坐标 point = (250,250 ...
- redis之(五)redis的散列类型的命令
[一]赋值与取值 -->命令:HSET key field value -->往某个key的某个属性设置值 -->命令:HGET key field --> 获取某个k ...
- 玩转树莓派 - 修改Raspbian软件源加快软件下载速度
这是 meelo 原创的 玩转树莓派 系列文章 步骤1:登录到Raspbian的命令行界面 步骤2:修改Raspbian的软件源 软件源是Linux系统免费的应用程序安装仓库,很多的应用软件都会这收录 ...
- Accord.NET入门
0.序 园子里介绍Accord.NET的文章不少,但是具体讲如何使用的反而不多,可能跟.NET在机器学习领域应用不多有关.诚然,如果做项目的话,可能用Python更好一些,但是如果把了解Accord. ...
- loadrunner中文件的操作
loadrunner中文件的操作 我们可以使用fopen().fscanf().fprintf().fclose()函数进行文件操作,但是因为LoadRunner不支持FILE数据类型,所以我们需要做 ...
- Mac安装Maven
1.从官网(https://maven.apache.org/download.cgi)下载 Maven 并解压. 2.配置环境 . vim ~/.bash_profile export MAVEN ...
- rpm包管理和源码包管理
(1)软件类型 源码包 需要gcc编译 nginx-1.12.1.tar.gz 二进制包 已编译 mysql-community-common-5.7.12-1.el7.x86_64.rpm 常见的二 ...
- ZOJ 3279-Ants(线段树)
传送门:zoj 3279 Ants Ants Time Limit: 2 Seconds Memory Limit: 32768 KB echo is a curious and cleve ...
- No module named '_Sqlite3' 解决方法
今晚,在学习Python的时候,(学习链接:http://yidao620c.github.io/blog/20150420/simpleblog-01.html(搭载自己的博客案例)): 想为系统生 ...
- HDU 6071 Lazy Running (同余最短路)
Lazy Running Time Limit: 2000/1000 MS (Java/Others) Memory Limit: 524288/524288 K (Java/Others)To ...