
scrapy-splash抓取动态数据例子六
一、介绍
本例子用scrapy-splash抓取中广互联网站给定关键字抓取咨询信息。
给定关键字:打通;融合;电视
抓取信息内如下:
1、资讯标题
2、资讯链接
3、资讯时间
4、资讯来源
二、网站信息
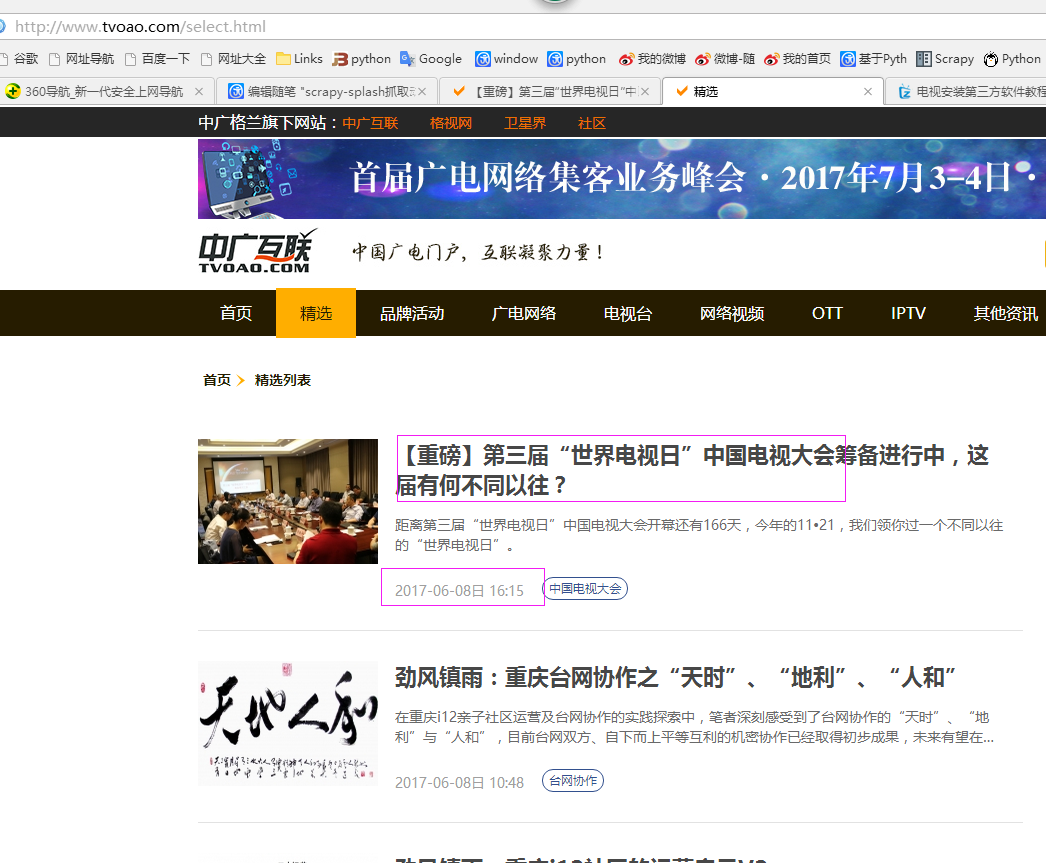
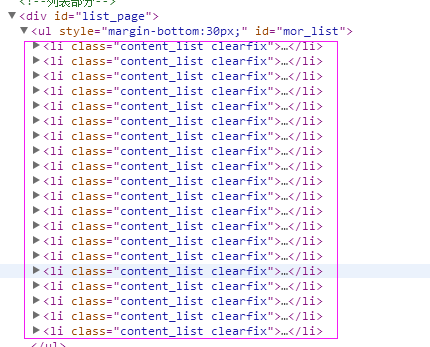
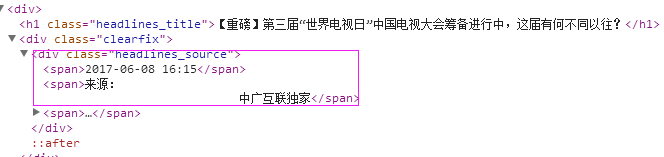
三、数据抓取
针对上面的网站信息,来进行抓取
1、首先抓取信息列表
抓取代码:sels = site.xpath('//li[@class="content_list clearfix"]')
2、抓取标题
首先列表页面,根据标题和日期来判断是否自己需要的资讯,如果是,就今日到资讯对应的链接,来抓取来源,如果不是,就不用抓取了
抓取代码:titles = sel.xpath('.//div[@class="content_listtext"]/a/h3/text()')
3、抓取链接
抓取代码:url = 'http://www.tvoao.com' + str(sel.xpath('.//a/@href')[0].extract())
4、抓取日期
抓取代码:strdates = sel.xpath('.//div[@class="listtext_label"]/span/text()')
5、抓取来源
抓取代码:sources = site.xpath('//div[@class="headlines_source"]/span[2]/text()')
四、完整代码
# -*- coding: utf-8 -*-

import scrapy

from scrapy import Request

from scrapy.spiders import Spider

from scrapy_splash import SplashRequest

from scrapy_splash import SplashMiddleware

from scrapy.http import Request, HtmlResponse

from scrapy.selector import Selector

from scrapy_splash import SplashRequest

from splash_test.items import SplashTestItem

import IniFile

import sys

import os

import re

import time

reload(sys)

sys.setdefaultencoding('utf-8')

sys.stdout = open('output.txt', 'w')

class tvoaoSpider(Spider):

    name = 'tvoao'

    configfile = os.path.join(os.getcwd(), 'splash_test\spiders\setting.conf')

    cf = IniFile.ConfigFile(configfile)

    information_wordlist = cf.GetValue("section", "information_keywords").split(';')

    websearch_urls = cf.GetValue("tvoao", "websearchurl").split(';')

    start_urls = []

    for url in websearch_urls:

        start_urls.append(url)

    # request需要封装成SplashRequest

    def start_requests(self):

        for url in self.start_urls:

            yield SplashRequest(url

                                , self.parse

                                , args={'wait': ''}

                                )

    def Comapre_to_days(self,leftdate, rightdate):

        '''

        比较连个字符串日期,左边日期大于右边日期多少天

        :param leftdate: 格式:2017-04-15

        :param rightdate: 格式:2017-04-15

        :return: 天数

        '''

        l_time = time.mktime(time.strptime(leftdate, '%Y-%m-%d'))

        r_time = time.mktime(time.strptime(rightdate, '%Y-%m-%d'))

        result = int(l_time - r_time) / 86400

        return result

    def date_isValid(self, strDateText):

        '''

        判断日期时间字符串是否合法:如果给定时间大于当前时间是合法,或者说当前时间给定的范围内

        :param strDateText: 四种格式 '2小时前'; '2天前' ; '昨天' ;'2017.2.12 '

        :return: True:合法;False:不合法

        '''

        currentDate = time.strftime('%Y-%m-%d')

        datePattern = re.compile(r'\d{4}-\d{2}-\d{2}')

        strDate = re.findall(datePattern, strDateText)

        if len(strDate) == 1:

            if self.Comapre_to_days(currentDate, strDate[0]) == 0:

                return True, currentDate

        return False, ''

    def parse(self, response):

        site = Selector(response)

        sels = site.xpath('//li[@class="content_list clearfix"]')

        for sel in sels:

            strdates = sel.xpath('.//div[@class="listtext_label"]/span/text()')

            if len(strdates)>0:

                flag, date = self.date_isValid(str(strdates[0].extract()))

                if flag:

                    titles = sel.xpath('.//div[@class="content_listtext"]/a/h3/text()')

                    if len(titles) > 0:

                        title = str(titles[0].extract())

                    url = 'http://www.tvoao.com' + str(sel.xpath('.//a/@href')[0].extract())

                    for keyword in self.information_wordlist:

                        if title.find(keyword) > -1:

                            yield SplashRequest(url

                                                , self.parse_item

                                                , args={'wait': ''},

                                                meta={'date': date, 'url': url,

                                                      'keyword': keyword, 'title': title}

                                                )

    def parse_item(self, response):

        site = Selector(response)

        it = SplashTestItem()

        it['title'] = response.meta['title']

        it['url'] = response.meta['url']

        it['date'] = response.meta['date']

        it['keyword'] = response.meta['keyword']

        sources = site.xpath('//div[@class="headlines_source"]/span[2]/text()')

        if len(sources)>0:

            it['source'] = str(sources[0].extract()).replace(u'来源: ', '')

        return it
scrapy-splash抓取动态数据例子六的更多相关文章
- scrapy-splash抓取动态数据例子十六
一.介绍 本例子用scrapy-splash爬取梅花网(http://www.meihua.info/a/list/today)的资讯信息,输入给定关键字抓取微信资讯信息. 给定关键字:数字:融合:电 ...
- scrapy-splash抓取动态数据例子一
目前,为了加速页面的加载速度,页面的很多部分都是用JS生成的,而对于用scrapy爬虫来说就是一个很大的问题,因为scrapy没有JS engine,所以爬取的都是静态页面,对于JS生成的动态页面都无 ...
- scrapy-splash抓取动态数据例子八
一.介绍 本例子用scrapy-splash抓取界面网站给定关键字抓取咨询信息. 给定关键字:个性化:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二.网站信息 ...
- scrapy-splash抓取动态数据例子七
一.介绍 本例子用scrapy-splash抓取36氪网站给定关键字抓取咨询信息. 给定关键字:个性化:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二.网站信 ...
- scrapy-splash抓取动态数据例子五
一.介绍 本例子用scrapy-splash抓取智能电视网网站给定关键字抓取咨询信息. 给定关键字:打通:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二.网站 ...
- scrapy-splash抓取动态数据例子四
一.介绍 本例子用scrapy-splash抓取微众圈网站给定关键字抓取咨询信息. 给定关键字:打通:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二.网站信息 ...
- scrapy-splash抓取动态数据例子三
一.介绍 本例子用scrapy-splash抓取今日头条网站给定关键字抓取咨询信息. 给定关键字:打通:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二.网站信 ...
- scrapy-splash抓取动态数据例子二
一.介绍 本例子用scrapy-splash抓取一点资讯网站给定关键字抓取咨询信息. 给定关键字:打通:融合:电视 抓取信息内如下: 1.资讯标题 2.资讯链接 3.资讯时间 4.资讯来源 二.网站信 ...
- scrapy-splash抓取动态数据例子十五
一.介绍 本例子用scrapy-splash爬取电视之家(http://www.tvhome.com/news/)网站的资讯信息,输入给定关键字抓取微信资讯信息. 给定关键字:数字:融合:电视 抓取信 ...
随机推荐
- hdu 3572(构图+最大流)
Task Schedule Time Limit: 2000/1000 MS (Java/Others) Memory Limit: 65536/32768 K (Java/Others)Tot ...
- Python datetime描述
(1)字符串转datetime:>>> string = '2014-01-08 11:59:58'>>> time1 = datetime.datetime.st ...
- MSSQL为单独数据库创建登录账户
如果要为一个数据库创建一个独立的账号需要这个数据库为包含数据库 当前(非包含)的数据库所面临的问题在描述什么是包含数据库之前,先了解一下为什么会出现包含数据库.当前的数据库有一些问题,如下:1.在数据 ...
- nodejs里的express自动刷新高级篇【转载】
搬运自[简书:http://www.jianshu.com/p/2f923c8782c8]亲测可用哦! 最近在使用express框架及mongodb,由于前端和后端代码修改后都需要实现自动刷新功能,刚 ...
- H264 帧边界识别简介
http://blog.csdn.net/wzw88486969/article/details/50364017
- react native android应用启动画面
参考地址:https://www.youtube.com/watch?v=rnLR65OGtic 第一步:生成启动画面的背景图片 生成一个2048*2048的背景图片,打开网站https://apet ...
- 洛谷 P2680 运输计划-二分+树上差分(边权覆盖)
P2680 运输计划 题目背景 公元 20442044 年,人类进入了宇宙纪元. 题目描述 公元20442044 年,人类进入了宇宙纪元. L 国有 nn 个星球,还有 n-1n−1 条双向航道,每条 ...
- 转:使用IDA动态调试WanaCrypt0r中的tasksche.exe
逆向分析——使用IDA动态调试WanaCrypt0r中的tasksche.exe 转:http://www.4hou.com/technology/4832.html 2017年5月19日发布 导语: ...
- 使用keras时出现 `pydot` failed to call GraphViz的解决办法
问题来源于使用了 keras.utils.plot_model,报错内容为: 2018-08-29 08:58:21.937037: I tensorflow/core/platform/cpu_fe ...
- 洛谷——P1123 取数游戏
P1123 取数游戏 题目描述 一个N×M的由非负整数构成的数字矩阵,你需要在其中取出若干个数字,使得取出的任意两个数字不相邻(若一个数字在另外一个数字相邻8个格子中的一个即认为这两个数字相邻),求取 ...