
Task的运行原理和工作窃取(work stealing)
在net4.0以前,当调用ThreadPool.QueueUserWorkItem方法往线程池中插入作业时,会把作业内容(其实就是一个委托)放到线程池中的一个全局队列中,然后线程池中的线程按照先进先出的方式取出作业,并处理。
如下图中的方式,主程序创建了Item到Queue中,然后分配到了各个工作线程中。
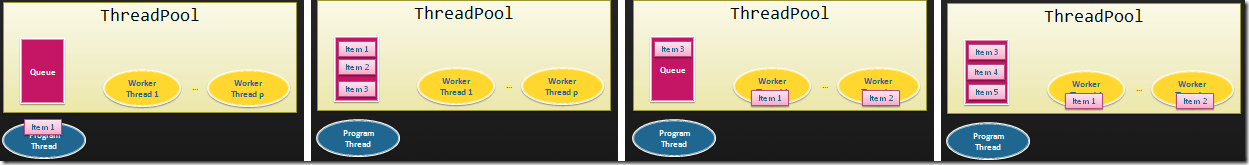
但
是在.net 4.0以后,线程池做了一些改进,比如增加了TPL(Task Parallel Library),TPL使用到了.net
4.0中新增加的一些特性。这些特性只能通过TPL运用,不能直接通过ThreadPool类运用
。TPL中的Task并不是线程,Task的执行是需要依靠线程池中的线程来完成的。
创建和启动一个Task类似调用
ThreadPool.QueueUserWorkItem,但不同的是线程池中的每一个线程都有一个本地队列。线程池通过一个任务调度器来分配任务,当
主程序创建了一个Task后,由于创建这个Task的线程不是线程池中的线程,则任务调度器会把该Task放入全局队列中。
如果这个Task是由线程池中的线程创建,并且未设置TaskCreationOptions.PreferFairness标记(默认情况下未设置),则任务调度器会把该Task放入到该线程的本地队列中。如果设置了TaskCreationOptions.PreferFairness标记,则放入全局队列。
如下面的演示图,Task1和Task2都是主程序创建的,因此都是放在全局队列中,当工作者线程处理Task2时,创建了一个Task3,此时Task3被放入本地队列

为什么要设计本地队列?这样做的优势是充分利用并行。随着越来越多线程竞争工作项,所有的线程访问单一的队列并不是最优的,并且也不安全。所以,将任务放入本地队列,并且由同一个线程处理,这就避免了竞争。
本地队列中的Task,线程会按照LIFO的方式去处理。这是因为在大多数场景下,最后创建的Task可能仍然在cache中,处理它能够提供缓存命中率。显然这意味放弃部分公平性而保证性能。如下面的演示图,
工作者线程1创建了Task2,Task2创建了Task3,Task4,Task5,但最先处理的还是Task5。
线程窃取work stealing
当
A线程开始执行的时候,优先总是处理本地队列中的任务,当它发现本地队列已经空了,那么它会去全局队列中获取Task,当全局队列中也是空的,那么就会发
生工作窃取(work
stealing)。任务调度器会把该线程池中额外的任务分配给A线程处理,其效果就好比该线程会才从其他线程的队列中“窃取”一个Task来执行。这样
的目的是提高了cpu的使用效率。

这种策略是任务调度器的默认策略,通常是不需要改变的。如果需要改变,需要在创建任务时,设置任务的TaskCreationOptions.PreferFairness。
----------------------
参考资料
http://www.danielmoth.com/Blog/New-And-Improved-CLR-4-Thread-Pool-Engine.aspx
Task的运行原理和工作窃取(work stealing)的更多相关文章
- Task的运行原理和工作窃取
在net4.0以前,当调用ThreadPool.QueueUserWorkItem方法往线程池中插入作业时,会把作业内容(其实就是一个委托)放到线程池中的一个全局队列中,然后线程池中的线程按照先进先出 ...
- java线程池,工作窃取算法
前言 在上一篇<java线程池,阿里为什么不允许使用Executors?>中我们谈及了线程池,同时又发现一个现象,当最大线程数还没有满的时候耗时的任务全部堆积给了单个线程, 代码如下: T ...
- ASP.NET Core 运行原理剖析2:Startup 和 Middleware(中间件)
ASP.NET Core 运行原理剖析2:Startup 和 Middleware(中间件) Startup Class 1.Startup Constructor(构造函数) 2.Configure ...
- 【转载】Spark系列之运行原理和架构
参考 http://www.cnblogs.com/shishanyuan/p/4721326.html 1. Spark运行架构 1.1 术语定义 lApplication:Spark Applic ...
- ASP.NET Core 运行原理解剖[1]:Hosting
ASP.NET Core 是新一代的 ASP.NET,第一次出现时代号为 ASP.NET vNext,后来命名为ASP.NET 5,随着它的完善与成熟,最终命名为 ASP.NET Core,表明它不是 ...
- [Spark内核] 第40课:CacheManager彻底解密:CacheManager运行原理流程图和源码详解
本课主题 CacheManager 运行原理图 CacheManager 源码解析 CacheManager 运行原理图 [下图是CacheManager的运行原理图] 首先 RDD 是通过 iter ...
- Spark核心技术原理透视一(Spark运行原理)
在大数据领域,只有深挖数据科学领域,走在学术前沿,才能在底层算法和模型方面走在前面,从而占据领先地位. Spark的这种学术基因,使得它从一开始就在大数据领域建立了一定优势.无论是性能,还是方案的统一 ...
- SPARK:作业基本运行原理
Spark作业基本运行原理: 我们使用spark-submit提交一个spark作业之后,这个作业就会启动一个对应的Driver进程.根据你使用的部署模式(deploy-mode)不同:1)Drive ...
- spark 任务运行原理
调优概述 在开发完Spark作业之后,就该为作业配置合适的资源了.Spark的资源参数,基本都可以在spark-submit命令中作为参数设置.很多Spark初学者,通常不知道该设置哪些必要的参数,以 ...
随机推荐
- npm查看全局安装过的包
在使用node的时候,用npm安装了很多软件,过一段时间没有使用就会忘记,怎么查看自己全局安装过的包,用命令 npm list -g --depth 0 在百度里搜不到结果的,我在google里老外的 ...
- angularJS指令动态加载template
angularJS提供了自定义指令的功能,指令可以定义自己的模板控制器,这个就类似于现在框架的组件,一个指令一般对应一个模板, templateUrl: 'templates/exportTmp.ht ...
- linux 下 ifcfg-eth0 配置/CentOS_minimal安装和开发环境部署
CentOS_minimal安装和开发环境部署:http://www.th7.cn/system/lin/201305/39002.shtml 网络接口配置文件 [root@localhost ~]# ...
- codevs 计算器的改良
#include<iostream> #include<cctype> #include<vector> #include<cstdio> using ...
- 面试总结之数据结构(Data Structure)
常用数据结构及复杂度 http://www.cnblogs.com/gaochundong/p/3813252.html 常用数据结构的时间复杂度 Data Structure Add Find De ...
- php error_log记录日志的使用方法和配置 (日志目录一定要手动创建)
对于PHP开发者来 说,一旦某个产品投入使用,应该立即将 display_errors选项关闭,以免因为这些错误所透露的路径.数据库连接.数据表等信息而遭到黑客攻击.但是,任何一个产品在投入使用后,都 ...
- shell编程: 获得目录下(包括子目录)所有文件名,路径和文件大小
转自:http://blog.chinaunix.net/uid-26000296-id-3575475.html function ergodic(){ ` do "/"$fil ...
- MySQL创建函数报“ERROR 1418 ”错误,不能创建函数
MySQL创建函数报ERROR 1418错误,不能创建函数,根据官方提示是说,不能创建函数可能是一个安全设置方面的配置或功能未开启原因,下面我们一起来看. 错误 ERROR 1418 (HY000 ...
- Windows下python3安装pip管理包(转贴)
方法有两种: 请参考:http://www.pip-installer.org/en/latest/installing.html#prerequisites 1.通过setuptools安装 安装s ...
- 11 MySQL--Navicat与pymysql模块
1.Navicat的安装下载 一.Navicat 在生产环境中操作MySQL数据库还是推荐使用命令行工具mysql,但在我们自己开发测试时, 可以使用可视化工具Navicat,以图形界面的形式操作My ...