
Hadoop【MR的分区、排序、分组】
[toc]
一.分区
问题:按照条件将结果输出到不同文件中
自定义分区步骤
1.自定义继承Partitioner类,重写getPartition()方法
2.在job驱动Driver中设置自定义的Partitioner
3.在Driver中根据分区数设置reducetask数
分区数和reducetask关系
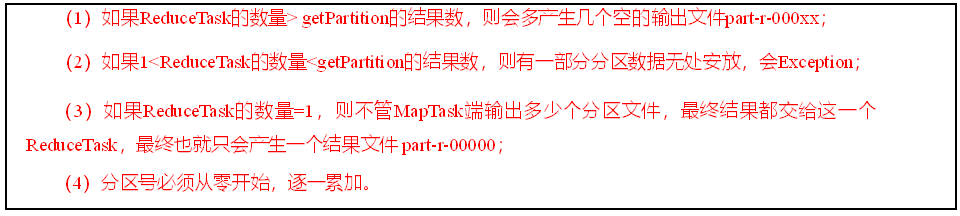
案例实操
将统计结果按照手机归属地不同省份输出到不同文件中(分区),手机号136、137、138、139开头都分别放到一个独立的4个文件中,其他开头的放到一个文件中
(1)自定义分区类
MyPartitioner.class
import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Partitioner;

public class MyPartioner extends Partitioner<Text, FlowBean> {

    @Override

    public int getPartition(Text text, FlowBean flowBean, int numPartitions) {

        String phone = text.toString();

        if (phone.startsWith("136")) {

            return 0;

        } else if (phone.startsWith("137")) {

            return 1;

        } else if (phone.startsWith("138")) {

            return 2;

        }else if (phone.startsWith("139")){

            return 3;

        }else {

            return 4;

        }

    }

}
(2)在Driver类设置分区和reducetask数
//设置自定义partitioner

job.setPartitionerClass(MyPartioner.class);

//设置reducetask数量

job.setNumReduceTasks(5);
二.全排序、分区排序、分组
当自定义的对象作为key,按照指定条件进行排序
实现排序的2种方式
1.对象实现WritableComparable接口
实现WritableComparable接口,重写compareTo方法,就可以实现排序(二次排序)
public class OrderBean implements WritableComparable<OrderBean> {

    //自定义排序,先按pid升序,再按pname降序

    @Override

    public int compareTo(OrderBean o) {

        int compare = this.pid.compareTo(o.pid);

        if (compare == 0) {

            return -this.pname.compareTo(o.pname);

        }

        return compare;

    }

}
2.继承WritableComparator类
自定义比较器继承WritableComparator类,父类构造方法增加需要比较的Bean对象,
//继承WritableComparator类

public class MyGroupCompartor extends WritableComparator {

    public MyGroupCompartor(){

		//增加Bean对象

        super(OrderBean.class,true);

    }

	// 对Bean的排序方法

    @Override

    public int compare(WritableComparable a, WritableComparable b) {

        OrderBean oa = (OrderBean) a;

        OrderBean ob = (OrderBean) b;

        return oa.getPid().compareTo(ob.getPid());

    }

}
全排序
不分区,只有一个reducetask,针对Key进行排序
分区排序
针对key全排序,然后针对key进行分区
辅助排序【自定义分组】
分析:已经对key进行排序,比如key对象为OrderBean的排序是id,pname的二次排序
,在进入reduce()的分组希望是id相同的进入一组,那么就需要自定义分组针对id进行分组
OrderBean

id		pname  amount

1		小米

1				 2400

1            1500

2		华为

2				2400

2           3400
自定义分组比较器
MyGroupCompartor.class
import org.apache.hadoop.io.WritableComparable;

import org.apache.hadoop.io.WritableComparator;

public class MyGroupCompartor extends WritableComparator {

    public MyGroupCompartor(){

        super(OrderBean.class,true);

    }

    @Override

    public int compare(WritableComparable a, WritableComparable b) {

        OrderBean oa = (OrderBean) a;

        OrderBean ob = (OrderBean) b;

        return oa.getPid().compareTo(ob.getPid());

    }

}
在Driver类中声明自定义分组
job.setGroupingComparatorClass(MyGroupCompartor.class);
Hadoop【MR的分区、排序、分组】的更多相关文章
- Hadoop Mapreduce分区、分组、二次排序过程详解[转]
原文地址:Hadoop Mapreduce分区.分组.二次排序过程详解[转]作者: 徐海蛟 教学用途 1.MapReduce中数据流动 (1)最简单的过程: map - reduce (2) ...
- 2 weekend110的hadoop的自定义排序实现 + mr程序中自定义分组的实现
我想得到按流量来排序,而且还是倒序,怎么达到实现呢? 达到下面这种效果, 默认是根据key来排, 我想根据value里的某个排, 解决思路:将value里的某个,放到key里去,然后来排 下面,开始w ...
- Hadoop Mapreduce分区、分组、二次排序
1.MapReduce中数据流动 (1)最简单的过程: map - reduce (2)定制了partitioner以将map的结果送往指定reducer的过程: map - partiti ...
- Hadoop Mapreduce分区、分组、二次排序过程详解
转载:http://blog.tianya.cn/m/post.jsp?postId=53271442 1.MapReduce中数据流动 (1)最简单的过程: map - reduce (2)定制了 ...
- Hadoop日记Day18---MapReduce排序分组
本节所用到的数据下载地址为:http://pan.baidu.com/s/1bnfELmZ MapReduce的排序分组任务与要求 我们知道排序分组是MapReduce中Mapper端的第四步,其中分 ...
- 9.2.3 hadoop reduce端连接-分区分组聚合
1.1.1 reduce端连接-分区分组聚合 reduce端连接则是利用了reduce的分区功能将stationid相同的分到同一个分区,在利用reduce的分组聚合功能,将同一个st ...
- 【Hadoop】Hadoop MR 自定义分组 Partition机制
1.概念 2.Hadoop默认分组机制--所有的Key分到一个组,一个Reduce任务处理 3.代码示例 FlowBean package com.ares.hadoop.mr.flowgroup; ...
- 【Hadoop】Hadoop MR 自定义排序
1.概念 2.代码示例 FlowSort package com.ares.hadoop.mr.flowsort; import java.io.IOException; import org.apa ...
- Hadoop MapReduce 二次排序原理及其应用
关于二次排序主要涉及到这么几个东西: 在0.20.0 以前使用的是 setPartitionerClass setOutputkeyComparatorClass setOutputValueGrou ...
随机推荐
- 面试官问我JVM内存结构,我真的是
面试官:今天来聊聊JVM的内存结构吧? 候选者:嗯,好的 候选者:前几次面试的时候也提到了:class文件会被类加载器装载至JVM中,并且JVM会负责程序「运行时」的「内存管理」 候选者:而JVM的内 ...
- js 事件流和事件冒泡阻止
js 事件流和事件冒泡阻止 事件流 当浏览器发展到第四代的时候(IE4与Netscape4)浏览器开发团队遇到一个有意思的的问题: 页面的哪一部分会拥有某个特定的事件? 比如在纸上画上一组同心圆,如果 ...
- LeetCode 199. 二叉树的右视图 C++ 用时超100%
/** * Definition for a binary tree node. * struct TreeNode { * int val; * TreeNode *left; * TreeNode ...
- @PostConstruct和static静态块初始化的区别
static blocks are invoked when the class is being initialized, after it is loaded. The dependencies ...
- oracle 使用union提示ORA-00907:缺少右括号
在使用union的时候提示:ORA-00907:缺少右括号 此原因是因为在union的左边和右边都有order by,因此需要去掉一边的order by,保留一个即可. 例如: select * fr ...
- java注解@Transactional事务类内调用不生效问题及解决办法
@Transactional 内部调用例子 在 Spring 的 AOP 代理下,只有目标方法由外部调用,目标方法才由 Spring 生成的代理对象来管理,这会造成自调用问题.若同一类中的其他没有@T ...
- NOIP模拟96(多校29)
T1 子集和 解题思路 大概是一个退背包的大白板,然而我考场上想复杂了,竟然还用到了组合数. 但是大概意思是一样的,有数的最小值一定是一个在 \(a\) 数组中存在的数字. 那么我们想办法除去它对应的 ...
- 获取鼠标在 canvas 中的位置
一般情况 一般情况下,如果需要在 canvas 中获取鼠标指针坐标,可以通过监听鼠标的 mousemove(如果只需单击时的坐标,可以用 click)事件. 当事件被触发时,我们可以获取鼠标相对于 v ...
- Django笔记&教程 6-4 forms进阶操作,重写forms方法
Django 自学笔记兼学习教程第6章第4节--forms进阶操作,重写forms方法 点击查看教程总目录 1 - 重写clean方法 在本章第三节中,我们举了个注册学生账号的例子,里面我们使用模型来 ...
- Python使用cx_Oracle模块操作Oracle数据库--通过sql语句和存储操作
https://www.jb51.net/article/125160.htm?utm_medium=referral Python使用cx_Oracle调用Oracle存储过程的方法示例 http ...