
【Hadoop】Hadoop MR 自定义排序
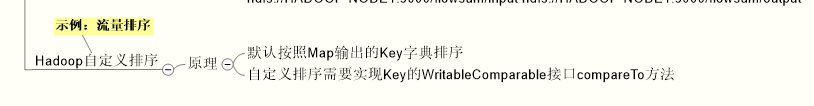
1、概念
2、代码示例
FlowSort
package com.ares.hadoop.mr.flowsort;

import java.io.IOException;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.conf.Configured;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.NullWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.Mapper;

import org.apache.hadoop.mapreduce.Reducer;

import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;

import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

import org.apache.hadoop.util.StringUtils;

import org.apache.hadoop.util.Tool;

import org.apache.hadoop.util.ToolRunner;

import org.apache.log4j.Logger;

import com.ares.hadoop.mr.exception.LineException;

public class FlowSort extends Configured implements Tool {

    private static final Logger LOGGER = Logger.getLogger(FlowSort.class);

    enum Counter {

        LINESKIP

    }

    public static class FlowSortMapper extends Mapper<LongWritable, Text,

        FlowBean, NullWritable> {

        private String line;

        private int length;

        private final static char separator = '\t';

        private String phoneNum;

        private long upFlow;

        private long downFlow;

        private long sumFlow;

        private FlowBean flowBean = new FlowBean();

        private NullWritable nullWritable = NullWritable.get();

        @Override

        protected void map(

                LongWritable key,

                Text value,

                Mapper<LongWritable, Text, FlowBean, NullWritable>.Context context)

                throws IOException, InterruptedException {

            // TODO Auto-generated method stub

            //super.map(key, value, context);

            String errMsg;

            try {

                line = value.toString();

                String[] fields = StringUtils.split(line, separator);

                length = fields.length;

                if (length != ) {

                    throw new LineException(key.get() + ", " + line + " LENGTH INVALID, IGNORE...");

                }

                phoneNum = fields[];

                upFlow = Long.parseLong(fields[]);

                downFlow = Long.parseLong(fields[]);

                sumFlow = Long.parseLong(fields[]);

                flowBean.setPhoneNum(phoneNum);

                flowBean.setUpFlow(upFlow);

                flowBean.setDownFlow(downFlow);

                flowBean.setSumFlow(sumFlow);

                context.write(flowBean, nullWritable);

            } catch (LineException e) {

                // TODO: handle exception

                LOGGER.error(e);

                System.out.println(e);

                context.getCounter(Counter.LINESKIP).increment();

                return;

            } catch (NumberFormatException e) {

                // TODO: handle exception

                errMsg = key.get() + ", " + line + " FLOW DATA INVALID, IGNORE...";

                LOGGER.error(errMsg);

                System.out.println(errMsg);

                context.getCounter(Counter.LINESKIP).increment();

                return;

            } catch (Exception e) {

                // TODO: handle exception

                LOGGER.error(e);

                System.out.println(e);

                context.getCounter(Counter.LINESKIP).increment();

                return;

            }

        }

    }

    public static class FlowSortReducer extends Reducer<FlowBean, NullWritable,

        FlowBean, NullWritable> {

        @Override

        protected void reduce(

                FlowBean key,

                Iterable<NullWritable> values,

                Reducer<FlowBean, NullWritable, FlowBean, NullWritable>.Context context)

                throws IOException, InterruptedException {

            // TODO Auto-generated method stub

            //super.reduce(arg0, arg1, arg2);

            context.write(key, NullWritable.get());

        }

    }

    @Override

    public int run(String[] args) throws Exception {

        // TODO Auto-generated method stub

        String errMsg = "FlowSort: TEST STARTED...";

        LOGGER.debug(errMsg);

        System.out.println(errMsg);

        Configuration conf = new Configuration();

        //FOR Eclipse JVM Debug

        //conf.set("mapreduce.job.jar", "flowsum.jar");

        Job job = Job.getInstance(conf);

        // JOB NAME

        job.setJobName("FlowSort");

        // JOB MAPPER & REDUCER

        job.setJarByClass(FlowSort.class);

        job.setMapperClass(FlowSortMapper.class);

        job.setReducerClass(FlowSortReducer.class);

        // MAP & REDUCE

        job.setOutputKeyClass(FlowBean.class);

        job.setOutputValueClass(NullWritable.class);

        // MAP

        job.setMapOutputKeyClass(FlowBean.class);

        job.setMapOutputValueClass(NullWritable.class);

        // JOB INPUT & OUTPUT PATH

        //FileInputFormat.addInputPath(job, new Path(args[0]));

        FileInputFormat.setInputPaths(job, args[]);

        FileOutputFormat.setOutputPath(job, new Path(args[]));

        // VERBOSE OUTPUT

        if (job.waitForCompletion(true)) {

            errMsg = "FlowSort: TEST SUCCESSFULLY...";

            LOGGER.debug(errMsg);

            System.out.println(errMsg);

            return ;

        } else {

            errMsg = "FlowSort: TEST FAILED...";

            LOGGER.debug(errMsg);

            System.out.println(errMsg);

            return ;

        }

    }

    public static void main(String[] args) throws Exception {

        if (args.length != ) {

            String errMsg = "FlowSort: ARGUMENTS ERROR";

            LOGGER.error(errMsg);

            System.out.println(errMsg);

            System.exit(-);

        }

        int result = ToolRunner.run(new Configuration(), new FlowSort(), args);

        System.exit(result);

    }

}
FlowBean
package com.ares.hadoop.mr.flowsort;

import java.io.DataInput;

import java.io.DataOutput;

import java.io.IOException;

import org.apache.hadoop.io.WritableComparable;

public class FlowBean implements WritableComparable<FlowBean>{

    private String phoneNum;

    private long upFlow;

    private long downFlow;

    private long sumFlow;

    public FlowBean() {

        // TODO Auto-generated constructor stub

    }

//    public FlowBean(String phoneNum, long upFlow, long downFlow, long sumFlow) {

//        super();

//        this.phoneNum = phoneNum;

//        this.upFlow = upFlow;

//        this.downFlow = downFlow;

//        this.sumFlow = sumFlow;

//    }

    public String getPhoneNum() {

        return phoneNum;

    }

    public void setPhoneNum(String phoneNum) {

        this.phoneNum = phoneNum;

    }

    public long getUpFlow() {

        return upFlow;

    }

    public void setUpFlow(long upFlow) {

        this.upFlow = upFlow;

    }

    public long getDownFlow() {

        return downFlow;

    }

    public void setDownFlow(long downFlow) {

        this.downFlow = downFlow;

    }

    public long getSumFlow() {

        return sumFlow;

    }

    public void setSumFlow(long sumFlow) {

        this.sumFlow = sumFlow;

    }

    @Override

    public void readFields(DataInput in) throws IOException {

        // TODO Auto-generated method stub

        phoneNum = in.readUTF();

        upFlow = in.readLong();

        downFlow = in.readLong();

        sumFlow = in.readLong();

    }

    @Override

    public void write(DataOutput out) throws IOException {

        // TODO Auto-generated method stub

        out.writeUTF(phoneNum);

        out.writeLong(upFlow);

        out.writeLong(downFlow);

        out.writeLong(sumFlow);

    }

    @Override

    public String toString() {

        return "" + phoneNum + "\t" + upFlow + "\t" + downFlow + "\t" + sumFlow;

    }

    @Override

    public int compareTo(FlowBean o) {

        // TODO Auto-generated method stub

        return sumFlow>o.getSumFlow()?-:;

    }

}
LineException
package com.ares.hadoop.mr.exception;

public class LineException extends RuntimeException {

    private static final long serialVersionUID = 2536144005398058435L;

    public LineException() {

        super();

        // TODO Auto-generated constructor stub

    }

    public LineException(String message, Throwable cause) {

        super(message, cause);

        // TODO Auto-generated constructor stub

    }

    public LineException(String message) {

        super(message);

        // TODO Auto-generated constructor stub

    }

    public LineException(Throwable cause) {

        super(cause);

        // TODO Auto-generated constructor stub

    }

}
【Hadoop】Hadoop MR 自定义排序的更多相关文章
- hadoop提交作业自定义排序和分组
现有数据如下: 3 3 3 2 3 1 2 2 2 1 1 1 要求为: 先按第一列从小到大排序,如果第一列相同,按第二列从小到大排序 如果是hadoop默认的排序方式,只能比较key,也就是第一列, ...
- 2 weekend110的hadoop的自定义排序实现 + mr程序中自定义分组的实现
我想得到按流量来排序,而且还是倒序,怎么达到实现呢? 达到下面这种效果, 默认是根据key来排, 我想根据value里的某个排, 解决思路:将value里的某个,放到key里去,然后来排 下面,开始w ...
- Hadoop学习之自定义二次排序
一.概述 MapReduce框架对处理结果的输出会根据key值进行默认的排序,这个默认排序可以满足一部分需求,但是也是十分有限的.在我们实际的需求当中,往 往有要对reduce输出结果进行二次排 ...
- 自定义排序及Hadoop序列化
自定义排序 将两列数据进行排序,第一列按照升序排列,当第一列相同时,第二列升序排列. 在map和reduce阶段进行排序时,比较的是k2.v2是不参与排序比较的.如果要想让v2也进行排序,需要把k2和 ...
- Hadoop学习之路(7)MapReduce自定义排序
本文测试文本: tom 20 8000 nancy 22 8000 ketty 22 9000 stone 19 10000 green 19 11000 white 39 29000 socrate ...
- Hadoop【MR的分区、排序、分组】
[toc] 一.分区 问题:按照条件将结果输出到不同文件中 自定义分区步骤 1.自定义继承Partitioner类,重写getPartition()方法 2.在job驱动Driver中设置自定义的Pa ...
- Hadoop MapReduce 二次排序原理及其应用
关于二次排序主要涉及到这么几个东西: 在0.20.0 以前使用的是 setPartitionerClass setOutputkeyComparatorClass setOutputValueGrou ...
- Hadoop【MR开发规范、序列化】
Hadoop[MR开发规范.序列化] 目录 Hadoop[MR开发规范.序列化] 一.MapReduce编程规范 1.Mapper阶段 2.Reducer阶段 3.Driver阶段 二.WordCou ...
- Hadoop基础-MapReduce的排序
Hadoop基础-MapReduce的排序 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.MapReduce的排序分类 1>.部分排序 部分排序是对单个分区进行排序,举个 ...
随机推荐
- [xsy1129] flow [树链剖分和线段树一起优化网络流][我也不知道这是什么鬼标签]
题面 内部OJ 思路 考虑一个决策方案${x}$,$x_i$表示第$i$个点选不选,$f^k_i$表示点$i$的第$k$个父亲 那么可以得到总花费的表达式$ans=\sum V_i x_i - \su ...
- echarts移动端字体模糊解决方法
echarts使用canvas画图,在移动端使用rem时候,若viewport的scale被缩放,则字体会发生模糊,本人采用的解决方法是在不同的dpr下使用不同的字体大小,具体代码如下: 获取字体大小 ...
- sass mixin 持续更新
控制多行显示省略号... //文字溢出省略号@mixin coveText($num:1){ @if $num == 1{ white-space: normal; overflow: hidden; ...
- 汕头市队赛SRM14 T3覆盖
我们可以考虑两种情况 区间之间不相重叠 和 重叠 f[i][j]表示以当前最后一个区间以 i 结尾 并且选了 j 个区间 不相重叠的话 只要选 1-i-w 的max再加上 包含i在内的前四个数的和 相 ...
- 昨天用到的一个sql查询。可取处,用max
SELECT T_AssetInfos_ID, MAX(T_AssetConstruct_Name), MAX(T_AssetProperties_Name), SUM(CAST(PropertyVa ...
- [bzoj1833][ZJOI2010]count 数字计数——数位dp
题目: (传送门)[http://www.lydsy.com/JudgeOnline/problem.php?id=1833] 题解: 第一次接触数位dp,真的是恶心. 首先翻阅了很多很多一维dp,因 ...
- 第18章 Active控件
转自: https://blog.csdn.net/u014162133/article/details/46573873 容器和服务器程序 容器应用程序时可以嵌入或链接对象的应用程序.Word就是容 ...
- zabbix 硬盘状态收集,制作表格
将zabbix首页复制到a文件里,这里主要是用到首页里 最近出现的问题 的信息 # -*- coding:utf-8 -*- import time import os from openpyxl i ...
- Cookies/Session机制详解
# 转载自:https://blog.csdn.net/fangaoxin/article/details/6952954/ 会话(Session)跟踪是Web程序中常用的技术,用来跟踪用户的整个会话 ...
- 【linux高级程序设计】(第十四章)TCP高级应用 3
控制socket文件描述符属性 1.set/getsockopt()修改socket属性 int getsockopt (int __fd, int __level, int __optname, v ...