
商业爬虫学习笔记day5
一. 发送post请求
import requests

url = ""

# 发送post请求

data = {

}

response = requests.post(url, data=data)
二. 内网认证
auth= (user,pwd)

response = requests.get(url, auth=auth)
三. 代理
import requests

url = "http://www.baidu.com"

headers = {

    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.100 Safari/557.36"

}

free_proxy = {'http': '118.187.58.35:53281'}

response = requests.get(url, proxies = free_proxy)

data = response.content.decode()

with open("proxy.html", "w") as f:

    f.write(data)
四. 第三方CA证书
由day1中https与http的区别知道,https是有第三方CA证书认证的,但有些网站虽然是https,但是它不是CA证书(可以是自己颁布的证书,如以前的12306),这样的话就访问不了该网站,报如下错

解决方法:告诉web忽略证书去访问
代码如下
import requests

url = 'https://10.10.10.9/'

headers = {

    'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_12_6) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.67 Safari/537.36'

}

response = requests.get(url=url, headers=headers, verify=False)

data = response.content.decode()

with open('03-ssl.html', 'w') as f:

    f.write(data)
五. cookie
1. cookie的工作流程:
当用户A浏览某个使用Cookie的网站时,该网站的服务器就为A产生一个唯一的识别码,并以此作为索引在服务器的后端数据库中产生一个项目。接着在给A的HTTP响应报文中添加一个叫做Set-cookie的首部行。这里的“”“首部字段名”就是“Set-cookie”,而后面的值就是赋予该用户的“”识别码“”,例如这个首部行是这样的
Set-cookie:31d4d96e407aad42
当A收到这个响应时,其浏览器就在它管理的特定Cookie文件中添加一行,其中包括这个服务器的主机名和Set-cookie后面给出的识别码。当A继续浏览这个网站时,每发送一个HTTP请求报文时,其浏览器就会从其Cookie文件中取出这个网站的识别码,并放到HTTP请求报文的cookie
首部行中:
Cookie:31d4d96e407aad42
于是,这个网站就能够跟踪用户31d4d96e407aad42(用户A)在该网站的活动。需要注意的是,服务器并不需要知道这个用户的真实姓名以及其他信息。但服务器能够知道用户31d4d96e407aad42在什么时候访问了哪些页面,以及访问这些页面的顺序。如果A是在网上购物,那么这个服务器可以为A维护一个所购物品的列表,使A在结束这次购物时一起付费
如果A在几天后再次访问这个网站,那么他的浏览器会在其HTTP请求报文中继续使用首部行 Cookie:31d4d96e407aad42 ,而这个网站服务器根据A过去的访问记录可以向他推荐商品。如果A已经在该网站登记过和使用过信用卡付费,那么这个网站就已经保存了A的姓名、电子邮件、信用卡号码等信息。这样,当A继续在该网站购物时,只要还是用同一台电脑,由于浏览器产生的HTTP请求报文中都携带了同样的Cookie首部行,服务器就可以利用Cookie来验证出这是用户A,因此以后A在这个网站购物时就不必重新在键盘输入姓名、信用卡号码等信息。这对顾客显然是方便的。
尽管Cookie能够简化用户网上购物的过程,但Cookie的使用一直引起很多争议。有人认为Cookie会把计算机病毒带到用户的计算机中。其实这是对Cookie的误解。Cookie只是一个小小的文本文件,不是计算机的可执行程序,因此不可能传播计算机病毒,也不可能用来获取用户计算机硬盘中的信息。对于Cookie的另一个争议,是关于用户隐私的保护问题。例如,网站服务器知道了A的一些信息,就有可能把这些信息出卖给第三方。Cookie还可以用来收集用户在万维网网站上的行为。这些都属于用户个人隐私。有些网站为了使顾客放心,就公开声明他们会保护顾客的隐私,绝对不会把顾客的识别码或和个人信息出售或转移给其他厂商。
2. 使用cookie的两种方式
(1)人为获取cookie,再将其添加至请求中
requests模块中的cookie的形式为字典或者cookieJar对象,如下图源码所示:
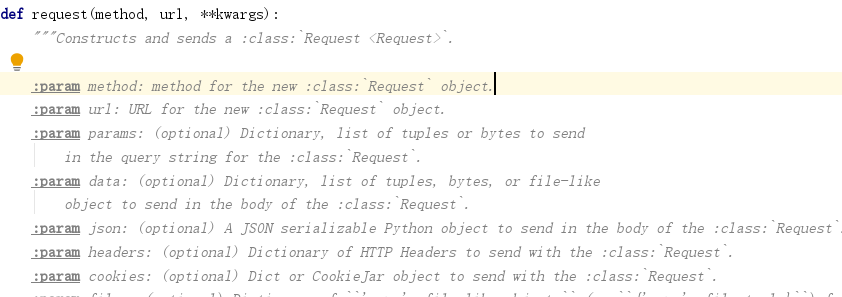
一般从数据包中获取的cookie为字符串,要人为的转换成dict会很麻烦(可以用sublime图形界面进行正则匹配,然后将得到的字典copy过来),下面代码是直接用代码进行正则匹配,得到dict形式的cookie,代码如下
import requests

member_url = 'https://www.yaozh.com/member/'

headers = {

    'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_12_6) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.67 Safari/537.36'

}

# cookies的字符串

cookies = 'acw_tc=2f624a2a15635259218338401e63e5d881869f24ac893d6eef3e3a125160f6; _ga=GA1.2.217274285.1563525921; _gid=GA1.2.2017411935.1563525921; _gat=1; Hm_lpvt_65968db3ac154c3089d7f9a4cbb98c94=1563611476; yaozh_userId=786936; UtzD_f52b_saltkey=vG51G41g; UtzD_f52b_lastvisit=1563607885; yaozh_uidhas=1; acw_tc=2f624a2a15635259218338401e63e5d881869f24ac893d6eef3e3a125160f6; Hm_lvt_65968db3ac154c3089d7f9a4cbb98c94=1563522881%2C1563523792%2C1563525921%2C1563611474; UtzD_f52b_ulastactivity=1563523048%7C0; UtzD_f52b_creditnotice=0D0D2D0D0D0D0D0D0D696235; UtzD_f52b_creditbase=0D0D0D0D0D0D0D0D0; UtzD_f52b_creditrule=%E6%AF%8F%E5%A4%A9%E7%99%BB%E5%BD%95; _ga=GA1.1.2067661254.1563611505; _gid=GA1.1.484577145.1563611505; MEIQIA_VISIT_ID=1OGl2skSTjPKvqcpWkd9Il9EqnL; yaozh_logintime=1563611638; yaozh_user=786936%09jjfeng123; db_w_auth=696235%09jjfeng123; UtzD_f52b_lastact=1563611638%09uc.php%09; UtzD_f52b_auth=9e94yt5nXd1XEO2zCaqRPMm3nVIP4co2Z5Rt3At8%2BvqcTkbtetREmvBHW5EhMJEd5tAFnnwR6GelOYZc53%2F6GPrQcJo; MEIQIA_VISIT_ID=1OGl2skSTjPKvqcpWkd9Il9EqnL; PHPSESSID=c1395bscfl2h36ksdoverjk9o5; yaozh_mylogin=1563690804'

# 第一种方法str--> dict

# cook_dict = {}

# cookies_list = cookies.split('; ')

# for cookie in cookies_list:

#     cook_dict[cookie.split('=')[0]] = cookie.split('=')[1]

# 第二种方法,字典推导式

cook_dict = {cookie.split('=')[0]:cookie.split('=')[1] for cookie in cookies.split('; ')}

response = requests.get(member_url, headers=headers, cookies=cook_dict)

data = response.content

print(type(data))

with open('03-cookie.html','wb') as f:

    f.write(data)
(2)利用session(先登录,利用session能自动保存cookies的特性,然后再去请求网站),代码如下:
import requests

# 请求数据url

member_url = 'https://www.yaozh.com/member/'

headers = {

    'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_12_6) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.67 Safari/537.36'

}

# session类可以自动保存cookies,等价于cookiesJar

session = requests.session()

# 1.代码登录

login_url = 'https://www.yaozh.com/login'

login_form_data = {

    'username':'j',

    'pwd': 'y',

    'formhash': 'EAACD4636B',

    'backurl': 'https%3A%2F%2Fwww.yaozh.com%2F',

}

# 发送登录请求

login_response = session.post(login_url,data=login_form_data,headers=headers)

print(login_response.content.decode())

# 2.登录成功之后 带着 有效的cookies 访问 请求目标数据

data = session.get(member_url,headers=headers).content

with open('04-cookie2.html','wb') as f:

    f.write(data)
六. 正则匹配(解析数据)
(1)python中的正则匹配默认为贪婪模式(在满足匹配的条件下尽可能多的匹配),解决办法:非贪婪操作符“?”,这个操作符可以用在"*","+","?"的后面,要求正则匹配的越少越好。
‘.’ 除了换行符号\n之外的都能匹配(若要匹配换行符,则用re.S)
注意:匹配出来的结果类型为list,此外正则匹配严格区分大小写(re.I表示忽略大小写)
 1 import re

 2

 3 # '.'除了换行符号\n之外的都匹配

 4 one = """

 5     mjfkajndgkdjfgkdfgn

 6     sdjfaksjdfasdjfsdkfsdnN

 7 """

 8 pattern = re.compile(r'm(.*)n')

 9 result = pattern.findall(one)

10 print(result.group())
此时匹配的结果为 [‘jfkajndgkdjfgkdfg’](贪婪模式下的结果),此处没有匹配到下一行的n,是因为“.”不匹配换行符
若将第8行代码改成 pattern = re.compile('m(.*?)n'),则结果为[’jfkaj’]
若将第8行代码换成
pattern = re.compile(r'm(.*)n', re.S)
则匹配结果为:['jfkajndgkdjfgkdfgn\n sdjfaksjdfasdjfsdkfsd']
若将第8行代码换成
pattern = re.compile(r'm(.*)n', re.S | re.I) # “|”为或,re.I表示忽略大小写
正则匹配结果为:['jfkajndgkdjfgkdfgn\n sdjfaksjdfasdjfsdkfsdn']
(2) match,search,findall,sub,split
a. match: 从头匹配 只匹配一次
1 import re

2

3 one = 'abc 123'

4 patter = re.compile('\d+')

5 # match 从头匹配 匹配一次

6 result = patter.match(one)  # 类型为 <class '_sre.SRE_Match'>

7 print(result.group())
运算结果为None
b. search 从任意位置 , 匹配一次
若将第6行代码改成
result = patter.search(one) # 其类型为 <class '_sre.SRE_Match'>
运算结果为123
c. findall 查找符合正则的内容 -- list
若将第6行代码改成如下(此处匹配的结果为list,所以前面第10行代码改成print(result))
result = patter.findall(one) # 类型为<class 'list'>,即为列表类型
运算结果为[‘123’]
d sub 替换字符串
若将第6行代码改成如下(第10 行也要改成print(result))
result = patter.sub('#',one) # 类型为<class 'str'>即为字符串类型,此中无goup()方法
运算结果为 abc #
e split 拆分
import re

one = 'abc 123'

#patter = re.compile('\d+')

# # split  拆分

patter = re.compile(' ')

result = patter.split(one)  # <class 'list'>

print(result)
运算结果为
['abc', '123']
f 匹配中文 [\u4e00-\u9fa5] 表示匹配中文的意思
1 import re

2 two = 'asdlkjadskjfdf  sdlfkdfk  哈哈  我是你爹,你的亲爹'

3 patern = re.compile('[\u4e00-\u9fa5]+')

4 result = patern.findall(two)

5 print(result)
运行的结果
['哈哈', '我是你爹', '你的亲爹']
商业爬虫学习笔记day5的更多相关文章
- 商业爬虫学习笔记day1
day1 一. HTTP 1.介绍: https://www.cnblogs.com/vamei/archive/2013/05/11/3069788.html http://blog.csdn.ne ...
- 商业爬虫学习笔记day2
1. get传参 (1)url中包含中文报错解决方法 urllib.request.quote("包含中文的url", safe = "string.printtable ...
- 商业爬虫学习笔记day4
一.获取登录后页面信息的两种方法 1.第一种方法: 人为把有效cookies加到请求头中,代码如下 import urllib.request # 确定url url = "https:// ...
- 商业爬虫学习笔记day3
一. 付费代理发送请求的两种方式 第一种方式: (1)代理ip,形式如下: money_proxy = {"http":"username:pwd@192.168.12. ...
- 商业爬虫学习笔记day8-------json的使用
一. 简介 JSON,全称为JavaScript Object Notation(JavaScript对象标记),它通过对象和数组的组合来表示数据,是一种轻量级的数据交换格式.它基于 ECMAScri ...
- 商业爬虫学习笔记day7-------解析方法之bs4
一.Beautiful Soup 1.简介 Beautiful Soup 是python的一个库,最主要的功能是从网页抓取数据.其特点如下(这三个特点正是bs强大的原因,来自官方手册) a. Beau ...
- 商业爬虫学习笔记day6
一. 正则解析数据 解析百度新闻中每个新闻的title,url,检查每个新闻的源码可知道,其title和url都位于<a></a>标签中,因为里面参数的具体形式不一样,同一个正 ...
- python网络爬虫学习笔记
python网络爬虫学习笔记 By 钟桓 9月 4 2014 更新日期:9月 4 2014 文章文件夹 1. 介绍: 2. 从简单语句中開始: 3. 传送数据给server 4. HTTP头-描写叙述 ...
- python网络爬虫学习笔记(二)BeautifulSoup库
Beautiful Soup库也称为beautiful4库.bs4库,它可用于解析HTML/XML,并将所有文件.字符串转换为'utf-8'编码.HTML/XML文档是与“标签树一一对应的.具体地说, ...
随机推荐
- 链表中环的入口结点 牛客网 剑指Offer
链表中环的入口结点 牛客网 剑指Offer 题目描述 给一个链表,若其中包含环,请找出该链表的环的入口结点,否则,输出null. # class ListNode: # def __init__(se ...
- 求1+2+3...+n 牛客网 剑指Offer
求1+2+3...+n 牛客网 剑指Offer 题目描述 求1+2+3+...+n,要求不能使用乘除法.for.while.if.else.switch.case等关键字及条件判断语句(A?B:C). ...
- 面试官:熟悉JS中的new吗?能手写实现吗?
目录 1 new 运算符简介 2 new 究竟干了什么事 3 模拟实现 new 运算符 4 补充 预备知识: 了解原型和原型链 了解this绑定 1 new 运算符简介 MDN文档:new 运算符创建 ...
- C语言图书管理借阅系统——ncurses库的使用
一.前言 作为一只大四狗,最近还跟着大二同学修了一门课(当然不是之前没通过啦),课程是高级语言课程设计,高级语言指的是C语言 :),内容是做一个XX管理系统,我选择了图书管理系统,先介绍下我做的系统: ...
- 【浏览器】聊聊DOM
[浏览器]聊聊DOM 博客说明 文章所涉及的资料来自互联网整理和个人总结,意在于个人学习和经验汇总,如有什么地方侵权,请联系本人删除,谢谢! 说明 作为前端开发,在以前的工作中大多是和DOM打交道,到 ...
- css 按钮悬停效霓虹灯特效
css 按钮悬停效霓虹灯特效 <!DOCTYPE html> <html lang="en"> <head> <meta charset=
- 蓝图before request
方法1 @bp.before_request def test(): print("test") 方法2 def bp_before_request(): print(test) ...
- Idea tomcat debug按钮灰色无法运行
打开Project Structure 2.选中src,点击按钮关闭界面,重启idea即可
- FZU ICPC 2020 寒假训练 4 —— 模拟(二)
P1056 排座椅 题目描述 上课的时候总会有一些同学和前后左右的人交头接耳,这是令小学班主任十分头疼的一件事情.不过,班主任小雪发现了一些有趣的现象,当同学们的座次确定下来之后,只有有限的 D 对同 ...
- Solon 1.5.67 发布,增加 GraalVm Native 支持
Solon 已有120个生态扩展插件,此次更新主要为细节打磨: 添加 solon.extend.graalvm 插件,用于适配 graalvm native image 模式 从此,solon 进入 ...