
商业爬虫学习笔记day6
一. 正则解析数据
解析百度新闻中每个新闻的title,url,检查每个新闻的源码可知道,其title和url都位于<a></a>标签中,因为里面参数的具体形式不一样,同一个正则并不能匹配并提取所有新闻的标题和url,如下图
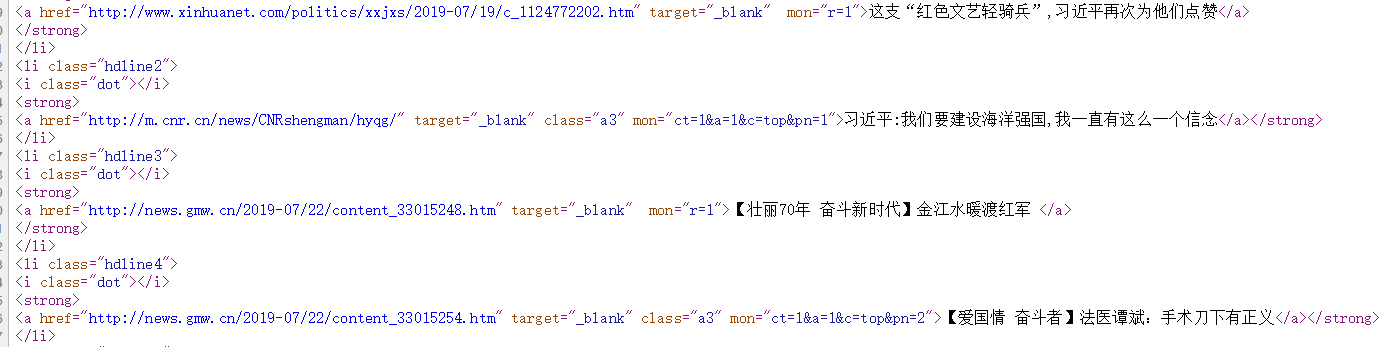
target为确定值,在正则中可以写死,class也为确定值,在正则中也可写死,但class并不存在于所有的a标签中(自己的想法是写2个正则进行匹配(带class与否),最后将得到的数据汇总),mon里的数值也不一样,所以需要用正则匹配出来,到时候进行二次处理(若不需要的话),以下为代码(带class,同理不带class)
import re

import requests

url = 'http://news.baidu.com/'

headers = {

    "User-Agent": 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_12_6) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.77 Safari/537.36'

}

# response.text 不太准确 转码 是靠推测

data = requests.get(url, headers=headers).content.decode()

# 正则解析 数据[\u4e00-\u9fa5]
pattern = re.compile('<a href="(.*?)" target="_blank" class="a3" mon="(.*?)"(.*)</a>')
result = pattern.findall(data)
print(result)
结果如下(截取部分图):

二. xpath解析数据
1. 安装支持并能解析html和XML的解析库 ------lxml:
pip install lxml
2. 转换数据的解析类型
xpath_data = etree.HTML(data)
3. xpath语法
1. “/” 表示节点
result = xpath_data.xpath('/html/head/title//text()') # 按照节点顺序一级一级获取内容
2. “//” 表示跨节点
result = xpath_data.xpath('//a/text()') # 跨节点获取内容
3.精确的标签: //a[@属性="属性值"]
result = xpath_data.xpath('//a[@mon="ct=1&a=2&c=top&pn=18"]')  # 得到a标签对象
result = xpath_data.xpath('//a[@mon="ct=1&a=2&c=top&pn=18"]/text()')  # 获取内容
4. 获取某个标签的url: @href
result = xpath_data.xpath('//a[@mon="ct=1&a=2&c=top&pn=18"]/@href')
代码
import re

import requests

# 安装支持 解析html和XML的解析库 lxml

# pip install lxml

from lxml import etree

url = 'http://news.baidu.com/'

headers = {

    "User-Agent": 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_12_6) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.77 Safari/537.36'

}

# response.text 不太准确 转码 是靠推测

data = requests.get(url, headers=headers).content.decode()

# 1.转解析类型

xpath_data = etree.HTML(data)

# 2调用 xpath的方法

result = xpath_data.xpath('/html/head/title//text()')

result = xpath_data.xpath('//a/text()')

result = xpath_data.xpath('//a[@mon="ct=1&a=2&c=top&pn=18"]')

result = xpath_data.xpath('//a[@mon="ct=1&a=2&c=top&pn=18"]/@href')

result = xpath_data.xpath('//li/a/text()')

print(result)


with open('02news.html', 'w') as f:
  f.write(data)
三 练习1 爬取btc论坛title以及相应的url
这个论坛爬取不到信息(html源码),应该是做了反爬处理了,可能的原因:
Ajax动态加载
ajax动态加载的工作原理是:从网页的url加载网页的源代码之后,会在浏览器里执行javaScript程序。这些程序会加载出更多的内容,并把这些内容传输到网页中。这就是为什么有些网页直接爬取它的URL时却没有数据的原因。
解决方案:
使用审查元素分析“请求”对应的连接(方法:审查元素--->Network---->清空,点击加载更多,出现对应的Get连接寻找Type为text/html的,点击,查看get参数或者复制Request URL),循环过程。如果请求之前有页面,依据上一步的网址进行分析推导第一页。以此类推,抓取Ajax地址的数据。对返回的json使用request中的json进行解析,使用eval()转成字典处理
商业爬虫学习笔记day6的更多相关文章
- 商业爬虫学习笔记day1
day1 一. HTTP 1.介绍: https://www.cnblogs.com/vamei/archive/2013/05/11/3069788.html http://blog.csdn.ne ...
- 商业爬虫学习笔记day2
1. get传参 (1)url中包含中文报错解决方法 urllib.request.quote("包含中文的url", safe = "string.printtable ...
- 商业爬虫学习笔记day4
一.获取登录后页面信息的两种方法 1.第一种方法: 人为把有效cookies加到请求头中,代码如下 import urllib.request # 确定url url = "https:// ...
- 商业爬虫学习笔记day3
一. 付费代理发送请求的两种方式 第一种方式: (1)代理ip,形式如下: money_proxy = {"http":"username:pwd@192.168.12. ...
- 商业爬虫学习笔记day8-------json的使用
一. 简介 JSON,全称为JavaScript Object Notation(JavaScript对象标记),它通过对象和数组的组合来表示数据,是一种轻量级的数据交换格式.它基于 ECMAScri ...
- 商业爬虫学习笔记day7-------解析方法之bs4
一.Beautiful Soup 1.简介 Beautiful Soup 是python的一个库,最主要的功能是从网页抓取数据.其特点如下(这三个特点正是bs强大的原因,来自官方手册) a. Beau ...
- 商业爬虫学习笔记day5
一. 发送post请求 import requests url = "" # 发送post请求 data = { } response = requests.post(url, d ...
- python网络爬虫学习笔记
python网络爬虫学习笔记 By 钟桓 9月 4 2014 更新日期:9月 4 2014 文章文件夹 1. 介绍: 2. 从简单语句中開始: 3. 传送数据给server 4. HTTP头-描写叙述 ...
- python网络爬虫学习笔记(二)BeautifulSoup库
Beautiful Soup库也称为beautiful4库.bs4库,它可用于解析HTML/XML,并将所有文件.字符串转换为'utf-8'编码.HTML/XML文档是与“标签树一一对应的.具体地说, ...
随机推荐
- python语法与pycharm的基本使用
内容概要 pycharm基本使用 python注释语法 变量与常量 垃圾回收机制 数据类型 1. pycharm基本使用 pycharm安装完成后首次打开要注意: 文件路径(不要选择C盘) pytho ...
- 小米多模网关接入Home Assistant ZNDMWG03LM
一.小米zigbee网关使用 先下载米家app,打开手机蓝牙,登陆点"我的"界面,将网关设备插上电源,橙灯闪烁,点击蓝牙网关等待弹窗提示连接,选择连接路由器(需2.4GHz),输入 ...
- properties 文件解析
1.提供properties文件 jdbc.driver=com.mysql.jdbc.Driver jdbc.url=jdbc:mysql://localhost:3306/future?useUn ...
- NOIP模拟99(多校31)
T1 法阵 解题思路 原题3100,张口放 T1(出题人原话) 思维题,合法的情况其实就是上下两个梯形拼起来的样子. 他们的边界都是在 \(i\) 轴上面,但是不能相交. 于是我们可以尝试两者相交的纵 ...
- GDI绘制Winform工作流组件、具有独立图层的增删处理、防PPT效果
最近接了个小项目10K.用了2个下班时间写完,共花费了6-7个小时完成.如有同类需求的可以与本人联系,QQ:120772981 功能目标: 需要写一个仿PPT画泳道图的组件.之前写过工作流的组件,其实 ...
- C#练习4
//错误的程序using System; class Test { unsafe static void WriteLocations(byte[]arr) { fixed(byte*p_arr=ar ...
- 自定义 OpenShift s2i 镜像与模板——OracleJDK8
本文目标 由于 OpenShift 官方提供的镜像与模板(OpenJDK8)不完全满足业务需要: 不包含飞行记录功能.只有 OpenJDK11 以上才被 Oracle 开源 生成堆 dump 很大很慢 ...
- [luogu3781]切树游戏
考虑暴力的dp,即用$f_{i,j}$表示以$i$为根的子树内,强制$i$必须选且异或为$j$的方案数,转移用FWT即可,求出该dp数组的时间复杂度为$o(nm\log_{2}m)$ 由于是全局的方案 ...
- 在Ubuntu上安装Docker Engine
在Ubuntu上安装Docker Engine 这篇文章是介绍如何在在Ubuntu上安装Docker Engine,就是Google翻译官方文档的版本,英语好的直接官方原文.原文 要在Ubuntu上开 ...
- 2基因组间鉴定SV
本文学习费章军老师文章Genome of Solanum pimpinellifolium provides insights into structural variants during toma ...