
Hadoop MapReduce基本原理
一、什么是:
MapReduce是一种编程模型,用于大规模数据集(大于1TB)的并行运算。概念"Map(映射)"和"Reduce(归约)",是它们的主要思想,都是从函数式编程语言里借来的,还有从矢量编程语言里借来的特性。它极大地方便了编程人员在不会分布式并行编程的情况下,将自己的程序运行在分布式系统上。 当前的软件实现是指定一个Map(映射)函数,用来把一组键值对映射成一组新的键值对,指定并发的Reduce(归约)函数,用来保证所有映射的键值对中的每一个共享相同的键组。
源于Google MapReduce论文(04年)。
MapReduce的核心是:分而治之,并行处理;以及其调度和处理数据的自动化。
Hadoop中MR的主要内容:
hadoop序列化writable接口,数据类型
应用开发 (debug 单元测试)解决基本数据处理,作业调优
工作机制 作业提交流程,作业调度,shuffle与排序
MR类型 输入输出类型
特性:二次排序(全排、部分排),join
压缩算法
二、基本流程:
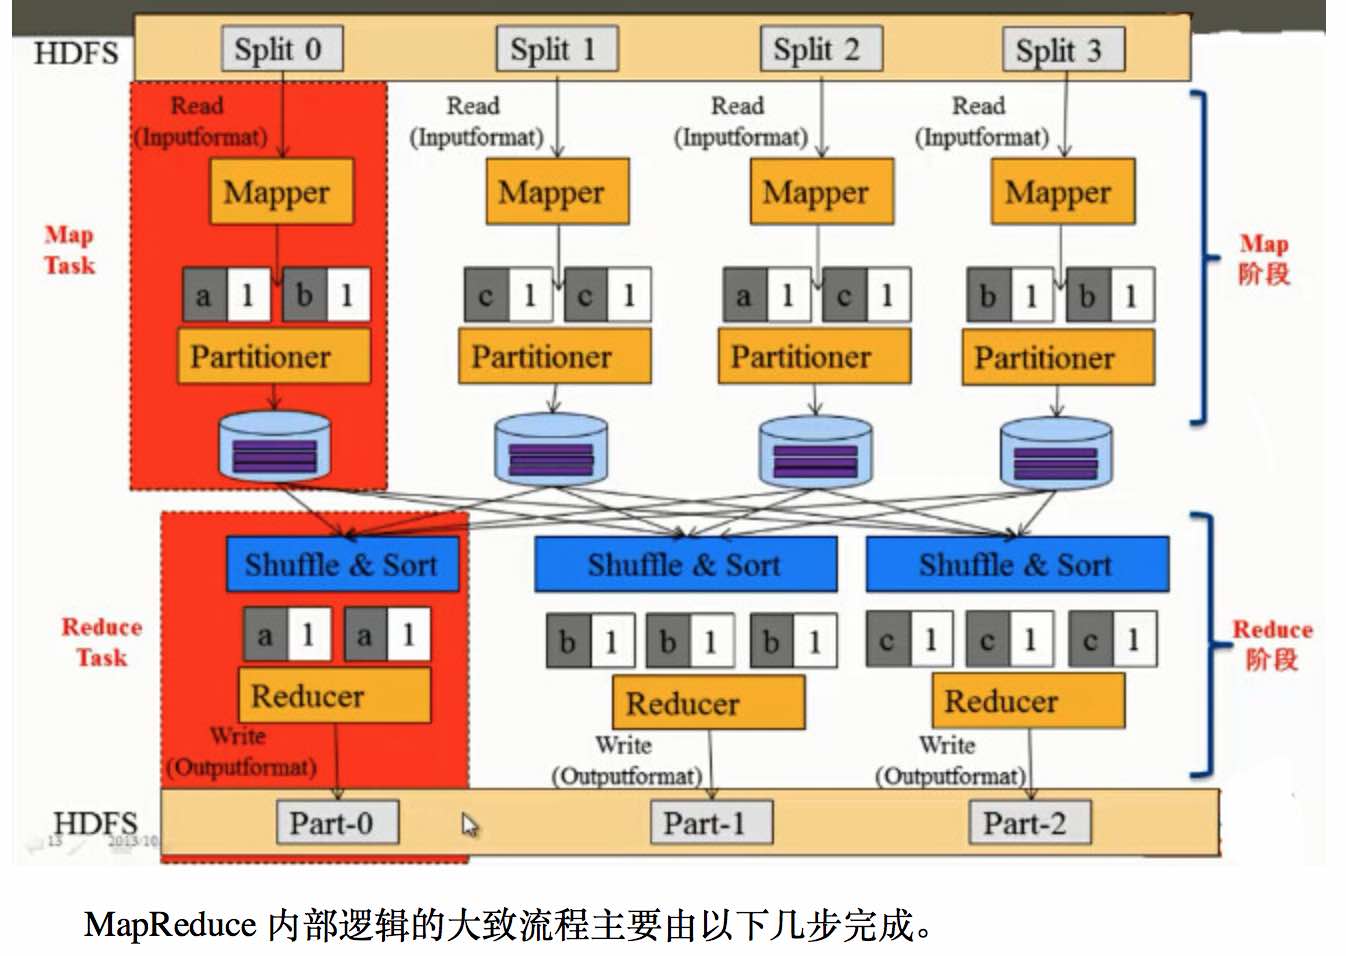
1、MR中主要是Map和Reduce两个阶段,其中基本流程是:
1、mr的数据处理单位是一个split,一个split对应一个map任务,处理时会有多个map任务同时运行;当map从HDFS上读取一个split时,这里会有“移动计算,不移动数据”的机制来减少网络的数据传输,使得效率能最大化;
2、获取到split时,默认会以TextInputFormat的格式读入,文件中的字符位置的偏移量作为 key,以及每一行的数据作为 value;
3、之后则进入map函数中进行处理,这个阶段可以获取需要的数据并加以处理,并以key value的形式写出,作为后面reduce函数的输入;
4、map到reduce之间会有一个shuffle的过程,大致过程是把不同key利用partitioner分散到各个reduce节点上去;
5、在reduce上会先通过 比较排序(前面shuffl会有预排序) 进行文件的归并,之后进入reduce函数,在每个reduce函数中key是唯一的,对应的value则是一个 Iterable接口类型,通过Iterable可以遍历所有当前key对应的所有value;
6、之后在reduce中对数据进行处理后,利用OutputFormat对处理后的key value保存到HDFS上即完成了整个流程。
注:一个split的大小计算:max( minimumSize, min( maximumSize, blockSize ));
通常 blockSize 在 minimumSize和maximumSize之间,所以一般分片大小就是块大小。
2、流程图:
3、编程中可定制的类:
InputFormat —> Mapper —> Partitioner (HashPartitioner) —> Combiner —> Reducer —> OutputFormat
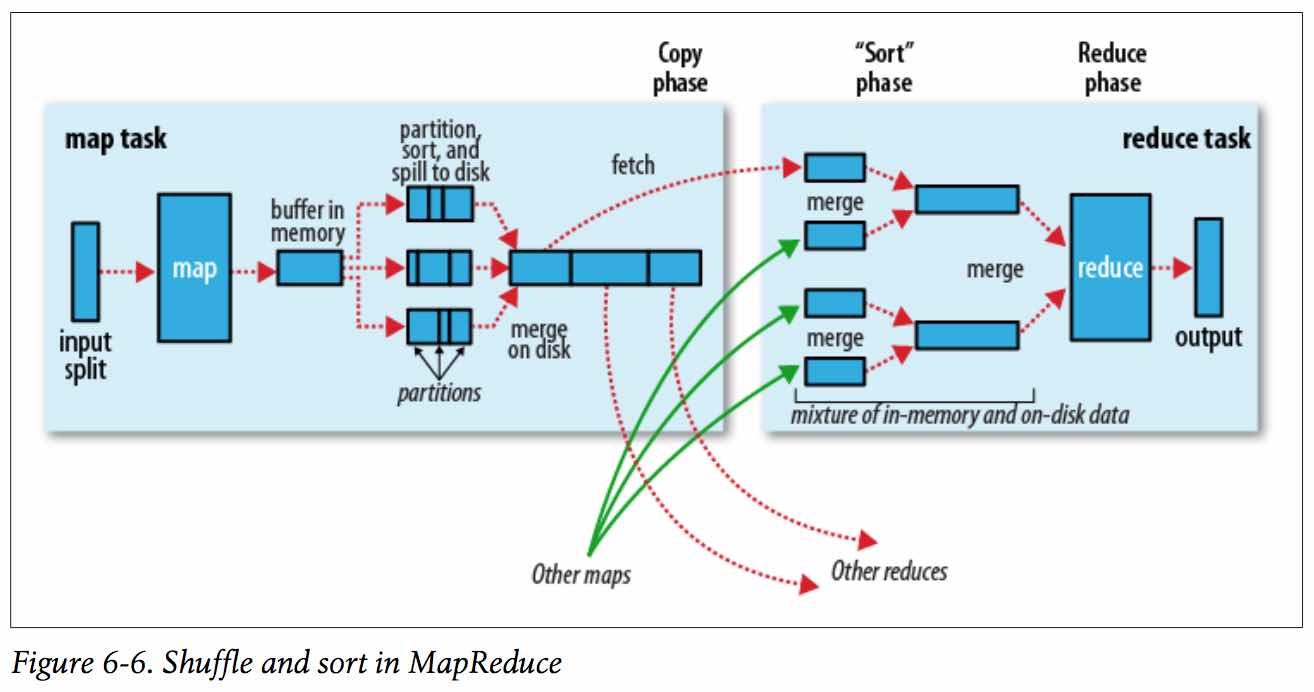
4、shuffle过程:map输出 到 reduce获取数据的过程。
三、优缺点:
优点:
Hadoop MapReduce基本原理的更多相关文章
- 从分治算法到 Hadoop MapReduce
从分治算法说起 要说 Hadoop MapReduce 就不得不说分治算法,而分治算法其实说白了,就是四个字 分而治之 .其实就是将一个复杂的问题分解成多组相同或类似的子问题,对这些子问题再分,然后再 ...
- python - hadoop,mapreduce demo
Hadoop,mapreduce 介绍 59888745@qq.com 大数据工程师是在Linux系统下搭建Hadoop生态系统(cloudera是最大的输出者类似于Linux的红帽), 把用户的交易 ...
- Hadoop MapReduce执行过程详解(带hadoop例子)
https://my.oschina.net/itblog/blog/275294 摘要: 本文通过一个例子,详细介绍Hadoop 的 MapReduce过程. 分析MapReduce执行过程 Map ...
- hadoop MapReduce Yarn运行机制
原 Hadoop MapReduce 框架的问题 原hadoop的MapReduce框架图 从上图中可以清楚的看出原 MapReduce 程序的流程及设计思路: 首先用户程序 (JobClient) ...
- Hadoop Mapreduce分区、分组、二次排序过程详解[转]
原文地址:Hadoop Mapreduce分区.分组.二次排序过程详解[转]作者: 徐海蛟 教学用途 1.MapReduce中数据流动 (1)最简单的过程: map - reduce (2) ...
- Hadoop MapReduce编程 API入门系列之薪水统计(三十一)
不多说,直接上代码. 代码 package zhouls.bigdata.myMapReduce.SalaryCount; import java.io.IOException; import jav ...
- Hadoop MapReduce编程 API入门系列之压缩和计数器(三十)
不多说,直接上代码. Hadoop MapReduce编程 API入门系列之小文件合并(二十九) 生成的结果,作为输入源. 代码 package zhouls.bigdata.myMapReduce. ...
- Hadoop MapReduce例子-新版API多表连接Join之模仿订单配货
文章为作者原创,未经许可,禁止转载. -Sun Yat-sen University 冯兴伟 一. 项目简介: 电子商务的发展以及电商平台的多样化,类似于京东和天猫这种拥有过亿用户的在线购 ...
- Writing an Hadoop MapReduce Program in Python
In this tutorial I will describe how to write a simpleMapReduce program for Hadoop in thePython prog ...
随机推荐
- cf711E ZS and The Birthday Paradox
ZS the Coder has recently found an interesting concept called the Birthday Paradox. It states that g ...
- 理解 virbr0
virbr0 是 KVM 默认创建的一个 Bridge,其作用是为连接其上的虚机网卡提供 NAT 访问外网的功能. virbr0 默认分配了一个IP 192.168.122.1,并为连接其上的其他虚拟 ...
- POJ 2185 Milking Grid [二维KMP next数组]
传送门 直接转田神的了: Milking Grid Time Limit: 3000MS Memory Limit: 65536K Total Submissions: 6665 Accept ...
- Netty构建游戏服务器(二)--Hello World
一,准备工作 1,netty-all-4.1.5.Final.jar(官网下载) 2,eclipse 二,步骤概要 1,服务器开发 (1),创建Server类 该类是程序的主入口,有main方法,服务 ...
- 你知道在springboot中如何使用WebSocket吗
一.背景 我们都知道 http 协议只能浏览器单方面向服务器发起请求获得响应,服务器不能主动向浏览器推送消息.想要实现浏览器的主动推送有两种主流实现方式: 轮询:缺点很多,但是实现简单 webso ...
- CodeBlock换肤
CodeBlock换肤 conf文件下载地址 我的是在D:\Program Files (x86)\CodeBlocks\AppData\codeblocks\default.conf 然后替换本地的 ...
- 前端模板Nunjucks简介
参考资料: https://mozilla.github.io/nunjucks/ https://mozilla.github.io/nunjucks/templating.html https:/ ...
- Go -- log4go日志
折腾: [已解决]go语言中实现log信息同时输出到文件和控制台(命令行) 期间,已经通过io的MultiWriter搞定了同时输出信息到文件和console,但是不支持level. 所以,再去试试这 ...
- git-flow 工作流 备忘清单
关于 git-flow 是一个 git 扩展集,按 Vincent Driessen 的分支模型提供高层次的库操作. 查看详情 ★ ★ ★ 这个备忘清单展示了 git-flow 的基本操作和效果. ★ ...
- openfalcon的安装和使用
蛮复杂的样子 根据官方文档指导,一步一步走起:https://book.open-falcon.org/zh_0_2/quick_install/prepare.html 单机安装的过程:单击安装会把 ...