
Kaggle-pandas(4)
Grouping-and-sorting
教程
映射使我们可以一次将整个列中的数据转换为DataFrame或Series中的一个值。 但是,通常我们希望对数据进行分组,然后对数据所在的组进行特定的操作。
正如您将学到的,我们使用groupby()操作来完成此操作。 我们还将介绍一些其他主题,例如为DataFrames编制索引的更复杂方法以及如何对数据进行排序。
Groupwise analysis
到目前为止,我们一直在使用的一个函数是value_counts()函数。 我们可以通过执行以下操作来复制value_counts()的功能:
reviews.groupby('points').points.count()
groupby()创建了一组reviews,这些reviews为给定的葡萄酒分配了相同的分值。 然后,对于每个组,我们都抓住了points()列并计算了它出现的次数。 value_counts()只是该groupby()操作的快捷方式。
我们可以将之前使用的任何汇总功能与此数据一起使用。 例如,要获取每个点值类别中最便宜的葡萄酒,我们可以执行以下操作:
reviews.groupby('points').price.min()
您可以将我们生成的每个组视为DataFrame的一部分,其中仅包含具有匹配值的数据。 我们可以使用apply()方法直接访问此DataFrame,然后我们可以按照自己认为合适的任何方式来操作数据。 例如,这是一种从数据集中的每个酿酒厂中选择第一批葡萄酒名称的方法:
reviews.groupby('winery').apply(lambda df: df.title.iloc[0])
为了获得更细粒度的控制,您还可以按多个列进行分组。 例如,以下是我们如何按国家和省份挑选最佳葡萄酒的方法:
reviews.groupby(['country', 'province']).apply(lambda df: df.loc[df.points.idxmax()])
分类结果如下

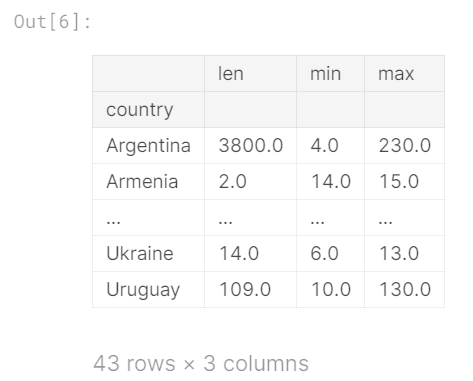
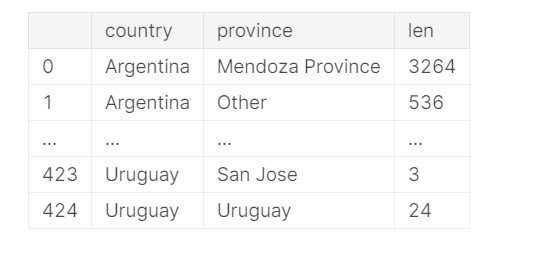
另一个值得一提的groupby()方法是agg(),它使您可以同时在DataFrame上运行许多不同的函数。 例如,我们可以生成数据集的简单统计摘要,如下所示:
reviews.groupby(['country']).price.agg([len, min, max])
Multi-indexes
到目前为止,在所有示例中,我们一直在使用带有单标签索引的DataFrame或Series对象。 groupby()稍有不同,因为它取决于我们运行的操作,有时会导致所谓的多索引。
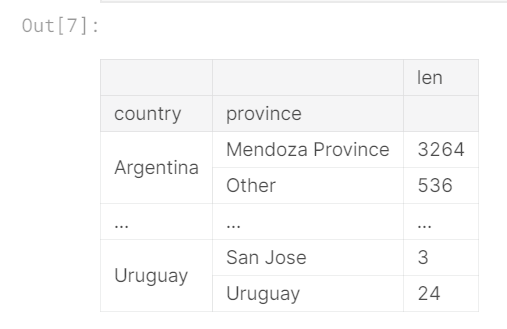
多索引与常规索引的不同之处在于它具有多个级别。 例如:
countries_reviewed = reviews.groupby(['country', 'province']).description.agg([len])

countries_reviewed
mi = countries_reviewed.index

type(mi)
Output:
pandas.core.indexes.multi.MultiIndex
多索引有几种方法来处理它们的分层结构,而单级索引则没有。 它们还需要两个级别的标签才能检索值。 对于刚接触pandas的用户来说,处理多索引输出是常见的“陷阱”。
pandas文档的“多索引/高级选择”部分中详细说明了多索引的使用案例以及使用说明。
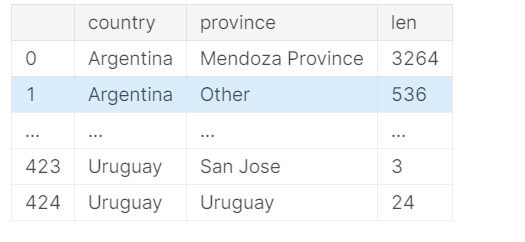
但是,通常,您最常使用的多索引方法是一种可转换回常规索引的方法,即reset_index()方法:
Sorting
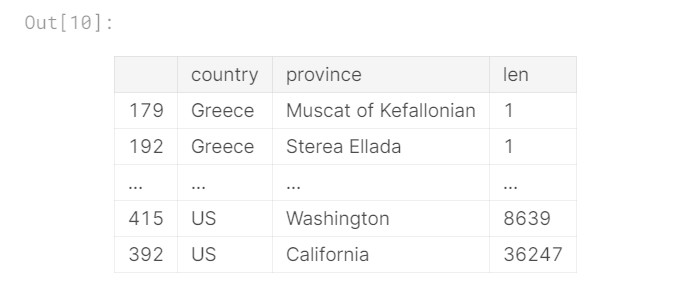
再次查看countries_reviewed,我们可以看到分组以索引顺序而不是以值顺序返回数据。 也就是说,在输出groupby的结果时,行的顺序取决于索引中的值,而不取决于数据中的值。
要按需要的顺序获取数据,我们可以自己对其进行排序。 sort_values()方法很方便。
countries_reviewed = countries_reviewed.reset_index()

countries_reviewed.sort_values(by='len')
Output:
要按索引值排序,请使用配套方法sort_index()。 此方法具有相同的参数和默认顺序:
countries_reviewed.sort_index()
Output:
练习
1
Who are the most common wine reviewers in the dataset? Create a Series whose index is the taster_twitter_handle category from the dataset, and whose values count how many reviews each person wrote.
# Your code here

reviews_written = reviews.groupby("taster_twitter_handle").taster_twitter_handle.count()

print(reviews_written)

# Check your answer

q1.check()
2.
What is the best wine I can buy for a given amount of money? Create a Series whose index is wine prices and whose values is the maximum number of points a wine costing that much was given in a review. Sort the values by price, ascending (so that 4.0 dollars is at the top and 3300.0 dollars is at the bottom).
best_rating_per_price = reviews.groupby('price')['points'].max().sort_index()

# Check your answer

q2.check()
3.
What are the minimum and maximum prices for each variety of wine? Create a DataFrame whose index is the variety category from the dataset and whose values are the min and max values thereof.
price_extremes = reviews.groupby('variety')["price"].agg([min,max])

# Check your answer

q3.check()
4.
What are the most expensive wine varieties? Create a variable sorted_varieties containing a copy of the dataframe from the previous question where varieties are sorted in descending order based on minimum price, then on maximum price (to break ties).
sorted_varieties = price_extremes.sort_values(by=['min', 'max'], ascending=False)

# Check your answer

q4.check()
5.
Create a Series whose index is reviewers and whose values is the average review score given out by that reviewer. Hint: you will need the taster_name and points columns.
reviewer_mean_ratings = reviews.groupby('taster_name').points.mean()

# Check your answer

q5.check()
6.
What combination of countries and varieties are most common? Create a Series whose index is a MultiIndexof {country, variety} pairs. For example, a pinot noir produced in the US should map to {"US", "Pinot Noir"}. Sort the values in the Series in descending order based on wine count.
country_variety_counts = reviews.groupby(['country', 'variety']).size().sort_values(ascending=False)

# Check your answer

q6.check()
Kaggle-pandas(4)的更多相关文章
- 由Kaggle竞赛wiki文章流量预测引发的pandas内存优化过程分享
pandas内存优化分享 缘由 最近在做Kaggle上的wiki文章流量预测项目,这里由于个人电脑配置问题,我一直都是用的Kaggle的kernel,但是我们知道kernel的内存限制是16G,如下: ...
- kaggle入门2——改进特征
1:改进我们的特征 在上一个任务中,我们完成了我们在Kaggle上一个机器学习比赛的第一个比赛提交泰坦尼克号:灾难中的机器学习. 可是我们提交的分数并不是非常高.有三种主要的方法可以让我们能够提高他: ...
- Kaggle入门教程
此为中文翻译版 1:竞赛 我们将学习如何为Kaggle竞赛生成一个提交答案(submisson).Kaggle是一个你通过完成算法和全世界机器学习从业者进行竞赛的网站.如果你的算法精度是给出数据集中最 ...
- 如何使用Python在Kaggle竞赛中成为Top15
如何使用Python在Kaggle竞赛中成为Top15 Kaggle比赛是一个学习数据科学和投资时间的非常的方式,我自己通过Kaggle学习到了很多数据科学的概念和思想,在我学习编程之后的几个月就开始 ...
- kaggle数据挖掘竞赛初步--Titanic<原始数据分析&缺失值处理>
Titanic是kaggle上的一道just for fun的题,没有奖金,但是数据整洁,拿来练手最好不过啦. 这道题给的数据是泰坦尼克号上的乘客的信息,预测乘客是否幸存.这是个二元分类的机器学习问题 ...
- kaggle& titanic代码
这两天报名参加了阿里天池的’公交线路客流预测‘赛,就顺便先把以前看的kaggle的titanic的训练赛代码在熟悉下数据的一些处理.题目根据titanic乘客的信息来预测乘客的生还情况.给了titan ...
- 初窥Kaggle竞赛
初窥Kaggle竞赛 原文地址: https://www.dataquest.io/mission/74/getting-started-with-kaggle 1: Kaggle竞赛 我们接下来将要 ...
- 逻辑回归应用之Kaggle泰坦尼克之灾(转)
正文:14pt 代码:15px 1 初探数据 先看看我们的数据,长什么样吧.在Data下我们train.csv和test.csv两个文件,分别存着官方给的训练和测试数据. import pandas ...
- kaggle之Grupo Bimbo Inventory Demand
Grupo Bimbo Inventory Demand kaggle比赛解决方案集合 Grupo Bimbo Inventory Demand 在这个比赛中,我们需要预测某个产品在某个销售点每周的需 ...
- kaggle之人脸特征识别
Facial_Keypoints_Detection github code facial-keypoints-detection, 这是一个人脸识别任务,任务是识别人脸图片中的眼睛.鼻子.嘴的位置. ...
随机推荐
- BERT模型图解
转载于 腾讯Bugly 发表于 腾讯Bugly的专栏 原文链接:https://cloud.tencent.com/developer/article/1389555 本文首先介绍BERT模型要做什么 ...
- CTFHub_技能树_文件上传
文件上传 无限制 直接上传一句话后门,使用蚁剑连接: 获得flag: 前端验证 尝试直接上传后门,发现被拦截,经过判断为Javascript前端验证: 这里可以使用Firefox浏览器插件禁用页面js ...
- Maven 专题(五):Maven核心概念详解(一)
**Maven 的核心程序中仅仅定义了抽象的生命周期,而具体的操作则是由 Maven 的插件来完成的.**可是 Maven 的插件并不包含在 Maven 的核心程序中,在首次使用时需要联网下载. 下载 ...
- python 并发专题(二):python线程以及线程池相关以及实现
一 多线程实现 线程模块 - 多线程主要的内容:直接进行多线程操作,线程同步,带队列的多线程: Python3 通过两个标准库 _thread 和 threading 提供对线程的支持. _threa ...
- 记录groupby的一次操作
df = pd.DataFrame({'key1':list('aabba'), 'key2': ['one','two','one','two','one'], 'data1': np.random ...
- python上selenium的弹框操作
selenium之弹框操作 1,分类 弹框类型自见解分为四种: 1,页面弹框 2,警告提示框(alert) 3,确认消息框(confirm) 4,提示消息对话(prompt) 提示:selenium ...
- JavaScript定时器及回调用法
JavaScript定时器及回调用法 循环定时任务 // 假设现在有这样一个需求:我需要请求一个接口,根据返回结果判断需不需要重复请求,直到达到某一条件为止,停止请求执行某操作 <script ...
- Java8——Stream流
Stream是数据渠道,用于操作集合.数组等生成的元素序列. Stream操作的三个步骤: 创建Stream 中间操作 终止操作 一.获取stream的四种方式 通过collection系列集合的st ...
- Python数据分析之全球人口数据
这篇文章用pandas对全球的人口数据做个简单分析.我收集全球各国1960-2019年人口数据,包含男女和不同年龄段,共6个文件. pop_total.csv: 各国每年总人口 pop_female. ...
- 使用Thanos实现Prometheus指标联邦
本文来自Rancher Labs Prometheus是CNCF中已经毕业的项目之一,主要用于监控和告警.在Kubernetes生态中,它是应用最为广泛的监控和告警工具之一.Rancher用户可以通过 ...