
『Scrapy』终端调用&选择器方法
Scrapy终端
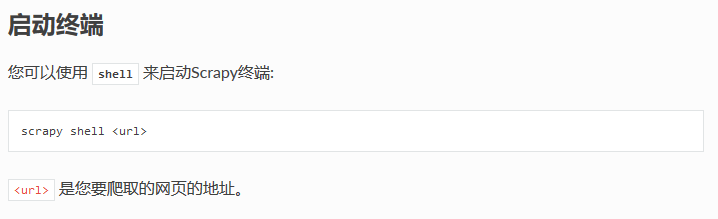
示例,输入如下命令后shell会进入Python(或IPython)交互式界面:
scrapy shell "http://www.itcast.cn/channel/teacher.shtml"
有一点注意的是必须是双引号,单引号会报错。
之后会显示当前保存的数据结构以供查询,这和我们编写py脚本时的数据结构完全相同,可以直接使用相关方法,
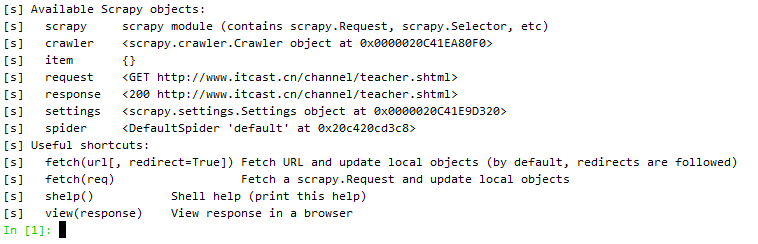
诸如:
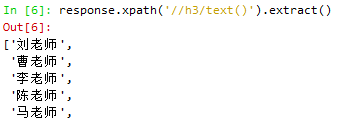
Scrapy Selectors
如下所示,
>>> response.xpath('//title/text()')

[<Selector (text) xpath=//title/text()>]

>>> response.css('title::text')

[<Selector (text) xpath=//title/text()>]
这两种方式提取的都是节点型数据,所以都可以使用.extract()或者.extract_first()方法提取data部分
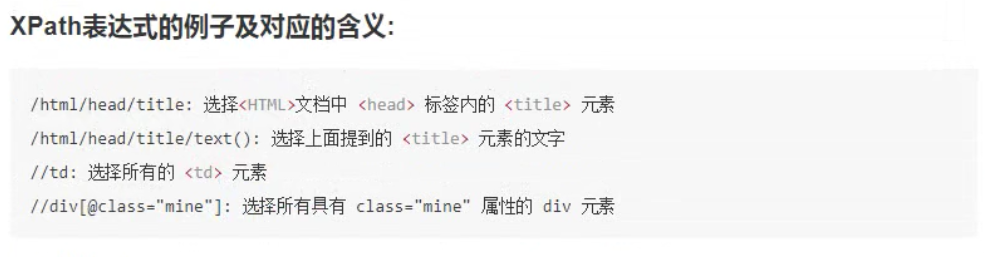
以下面的源码为例进行提取示范:
<html>

 <head>

  <base href='http://example.com/' />

  <title>Example website</title>

 </head>

 <body>

  <div id='images'>

   <a href='image1.html'>Name: My image 1 <br /><img src='image1_thumb.jpg' /></a>

   <a href='image2.html'>Name: My image 2 <br /><img src='image2_thumb.jpg' /></a>

   <a href='image3.html'>Name: My image 3 <br /><img src='image3_thumb.jpg' /></a>

   <a href='image4.html'>Name: My image 4 <br /><img src='image4_thumb.jpg' /></a>

   <a href='image5.html'>Name: My image 5 <br /><img src='image5_thumb.jpg' /></a>

  </div>

 </body>

</html>
提取标签属性,
>>> response.xpath('//base/@href').extract()

[u'http://example.com/']

>>> response.css('base::attr(href)').extract()

[u'http://example.com/']
对提取目标路径的标签进行筛选,contains(@href, "image")表示href熟悉需要包含image字符,css同理,
response.xpath('//a[contains(@href, "image")]/@href').extract()
Out[1]: ['image1.html', 'image2.html', 'image3.html', 'image4.html', 'image5.html']

response.xpath('//a[contains(@href, "image1")]/@href').extract()
Out[2]: ['image1.html']

response.css('a[href*=image]::attr(href)').extract()
Out[3]: ['image1.html', 'image2.html', 'image3.html', 'image4.html', 'image5.html']

esponse.css('a[href*=image2]::attr(href)').extract()
Out[4]: ['image2.html']
结合两者,
>>> response.xpath('//a[contains(@href, "image")]/img/@src').extract()

[u'image1_thumb.jpg',

 u'image2_thumb.jpg',

 u'image3_thumb.jpg',

 u'image4_thumb.jpg',

 u'image5_thumb.jpg']

>>> response.css('a[href*=image] img::attr(src)').extract()

[u'image1_thumb.jpg',

 u'image2_thumb.jpg',

 u'image3_thumb.jpg',

 u'image4_thumb.jpg',

 u'image5_thumb.jpg']
内置了正则表达式re和re_first方法,
response.xpath('//a[contains(@href, "image")]/text()')
Out[8]:
[<Selector xpath='//a[contains(@href, "image")]/text()' data='Name: My image 1 '>,
 <Selector xpath='//a[contains(@href, "image")]/text()' data='Name: My image 2 '>,
 <Selector xpath='//a[contains(@href, "image")]/text()' data='Name: My image 3 '>,
 <Selector xpath='//a[contains(@href, "image")]/text()' data='Name: My image 4 '>,
 <Selector xpath='//a[contains(@href, "image")]/text()' data='Name: My image 5 '>]

response.xpath('//a[contains(@href, "image")]/text()').re(r'Name:\s*(.*)')
Out[7]: ['My image 1 ', 'My image 2 ', 'My image 3 ', 'My image 4 ', 'My image 5 ']

response.xpath('//a[contains(@href, "image")]/text()').re_first(r'Name:\s*(.*)')
Out[9]: 'My image 1 '
『Scrapy』终端调用&选择器方法的更多相关文章
- 『GoLang』结构体与方法
结构体 结构体类型 Go 通过结构体的形式支持用户自定义类型,或者叫定制类型. Go 语言结构体是实现自定义类型的一种重要数据类型. 结构体是复合类型(composite types),它由一系列属性 ...
- 『Java』接口的使用方法
以下三个文件存在于同一个包下: 定义接口Dome_Interface.java: package cn.xxmmqg.Interface; // 接口不能直接使用,必须有一个"实现类&quo ...
- 『Scrapy』爬取斗鱼主播头像
分析目标 爬取的是斗鱼主播头像,示范使用的URL似乎是个移动接口(下文有提到),理由是网页主页属于动态页面,爬取难度陡升,当然爬取斗鱼主播头像这么恶趣味的事也不是我的兴趣...... 目标URL如下, ...
- 『Scrapy』爬取腾讯招聘网站
分析爬取对象 初始网址, http://hr.tencent.com/position.php?@start=0&start=0#a (可选)由于含有多页数据,我们可以查看一下这些网址有什么相 ...
- 『Scrapy』全流程爬虫demo
建立好的爬虫工程如下: item.py 它用来存储解析后的响应文件: # -*- coding: utf-8 -*- # Define here the models for your scraped ...
- 『Scrapy』爬虫框架入门
框架结构 引擎:处于中央位置协调工作的模块 spiders:生成需求url直接处理响应的单元 调度器:生成url队列(包括去重等) 下载器:直接和互联网打交道的单元 管道:持久化存储的单元 框架安装 ...
- 『Python』Python 调用 ZoomEye API 批量获取目标网站IP
#### 20160712 更新 原API的访问方式是以 HTTP 的方式访问的,根据官网最新文档,现在已经修改成 HTTPS 方式,测试可以正常使用API了. 0x 00 前言 ZoomEye 的 ...
- 『Python』为什么调用函数会令引用计数+2
一.问题描述 Python中的垃圾回收是以引用计数为主,分代收集为辅,引用计数的缺陷是循环引用的问题.在Python中,如果一个对象的引用数为0,Python虚拟机就会回收这个对象的内存. sys.g ...
- 『Java』StringBuilder类使用方法
String类存在的问题 String类的底层是一个被final修饰的byte[],不能改变. 为了解决以上问题,可以使用java.lang.StringBuilder类. StringBuilder ...
随机推荐
- Java SE 基础知识(一)
一.基础知识 1. Java SE : Java Standard Edition Java ME : Java Micro Edition Java EE : Java Enterprise Edi ...
- Linux下Tomcat同时部署两个工程然而只有一个能访问问题
Linux下Tomcat同时部署两个工程然而只有一个能访问问题 问题: Linux下单个部署到Tomcat下的时候都正常,两个一起部署,只有一个能访问: 解决方案: 由于采用#./shutdown.s ...
- 20145118 《Java程序设计》 实验报告三
实验三 敏捷开发与XP实践 实验内容 XP基础 XP核心实践 相关工具 实验要求 1.没有Linux基础的同学建议先学习<Linux基础入门(新版)><Vim编辑器> 课程 2 ...
- windows服务与自启动程序的区别(转载)
转载:http://blog.csdn.net/anddy926/article/details/8464142 在客户端服务器项目实践中,作为服务端必须保持程序的24小时不间断运行,需要做一个监控, ...
- java在访问https资源时的证书信任问题
java程序在访问https资源时,出现报错 sun.security.validator.ValidatorException: PKIX path building failed: sun.sec ...
- 使用fragment添加底部导航栏
切记:fragment一定要放在framlayout中,不然不会被替换完全(就是切换之后原来的fagment可能还会存在) main.xml <LinearLayout xmlns:androi ...
- C# 计算传入的时间距离今天的时间差
/// <summary> /// 计算传入的时间距离今天的时间差 /// </summary> /// <param name="dt">&l ...
- ubuntu14.04禁止触摸板和恢复触摸板
1.使用xinput list查看与触摸板相关的id,以下是本机的输出,没搞清楚为什么是Mouse!!! jello@jello:~$ xinput list⎡ Virtual core pointe ...
- JavaScript:正则表达式 全局
关于正则表达式的 RegExp方法:test,exec, String 方法:match,search, 全局 g var str = "abababa"; var re = /a ...
- extgcd 扩展欧几里得算法模板
#include <bits/stdc++.h> using namespace std; int extgcd (int a,int b,int &x,int &y){ ...