
K邻近分类算法
 # -*- coding: utf-8 -*-

 """

 Created on Thu Jun 28 17:16:19 2018

 @author: zhen

 """

 from sklearn.model_selection import train_test_split

 import mglearn

 import matplotlib.pyplot as plt

 x, y = mglearn.datasets.make_forge()

 x_train, x_test, y_train, y_test = train_test_split(x, y, random_state=0)  # 生成训练和测试集数据

 from sklearn.neighbors import KNeighborsClassifier

14 clf = KNeighborsClassifier(n_neighbors=3)  # 调用K近邻分类算法

15

16 clf.fit(x_train, y_train)  # 训练数据

 print("Test set predictions:{}".format(clf.predict(x_test)))  # 预测

 print("Test set accuracy:{:.2f}".format(clf.score(x_test, y_test)))

 fig, axes = plt.subplots(1, 3, figsize=(10, 3))  # 使用matplotlib画图

 for n_neighbors, ax in zip([1, 3, 9], axes):

     # fit 方法返回对象本身,所以我们可以将实例化和拟合放在一行代码中

     clf = KNeighborsClassifier(n_neighbors=n_neighbors).fit(x, y)

     mglearn.plots.plot_2d_separator(clf, x, fill=True, eps=0.5, ax=ax, alpha=0.4)

     mglearn.discrete_scatter(x[:, 0], x[:, 1], y, ax=ax)

     ax.set_title("{} neighbor(s)".format(n_neighbors))

     ax.set_xlabel("feature 0")

     ax.set_ylabel("feature 1")

 axes[0].legend(loc=3)
结果:

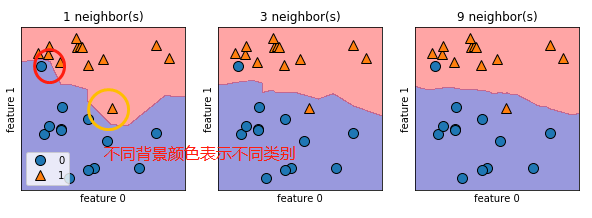
总结:从图中可以看出,使用单一邻居绘制的决策边界紧跟着训练数据,随着邻居的增多,决策边界也越来越平滑,更平滑的边界对应更简单的模型,换句话说,使用更少的邻居对应更高的模型复杂度。
K邻近分类算法的更多相关文章
- 数学建模:2.监督学习--分类分析- KNN最邻近分类算法
1.分类分析 分类(Classification)指的是从数据中选出已经分好类的训练集,在该训练集上运用数据挖掘分类的技术,建立分类模型,对于没有分类的数据进行分类的分析方法. 分类问题的应用场景:分 ...
- 监督学习-KNN最邻近分类算法
分类(Classification)指的是从数据中选出已经分好类的训练集,在该训练集上运用数据挖掘分类的技术建立分类模型,从而对没有分类的数据进行分类的分析方法. 分类问题的应用场景:用于将事物打上一 ...
- KNN邻近分类算法
K邻近(k-Nearest Neighbor,KNN)分类算法是最简单的机器学习算法了.它采用测量不同特征值之间的距离方法进行分类.它的思想很简单:计算一个点A与其他所有点之间的距离,取出与该点最近的 ...
- K近邻分类算法实现 in Python
K近邻(KNN):分类算法 * KNN是non-parametric分类器(不做分布形式的假设,直接从数据估计概率密度),是memory-based learning. * KNN不适用于高维数据(c ...
- 查看neighbors大小对K近邻分类算法预测准确度和泛化能力的影响
代码: # -*- coding: utf-8 -*- """ Created on Thu Jul 12 09:36:49 2018 @author: zhen &qu ...
- K邻近回归算法
代码: # -*- coding: utf-8 -*- """ Created on Fri Jul 13 10:40:22 2018 @author: zhen &qu ...
- sklearn_k邻近分类
# K邻近分类#--------------------------------# coding:utf-8 import pandas as pd from sklearn.neighbors im ...
- 《机器学习实战》学习笔记一K邻近算法
一. K邻近算法思想:存在一个样本数据集合,称为训练样本集,并且每个数据都存在标签,即我们知道样本集中每一数据(这里的数据是一组数据,可以是n维向量)与所属分类的对应关系.输入没有标签的新数据后,将 ...
- 监督学习——K邻近算法及数字识别实践
1. KNN 算法 K-近邻(k-Nearest Neighbor,KNN)是分类算法,是一个理论上比较成熟的方法,也是最简单的机器学习算法之一.该方法的思路是:如果一个样本在特征空间中的k个最相似( ...
随机推荐
- 采用太平洋AI的DINK框架一键运行3D点云识别,一键训练深度学习模型
DINK安装视频教程: http://fp-ai.com/video_details.html?id=072b030ba126b2f4b2374f342be9ed44 DINK一键启动视频教程: ...
- 记hangfire后台任务运行一段时间后不运行了。
什么是Hangfire Hangfire 是一个开源的.NET任务调度框架,目前1.6+版本已支持.NET Core.个人认为它最大特点在于内置提供集成化的控制台,方便后台查看及监控. https:/ ...
- resin远程调试配置
1.进入resin的安装路径下的conf目录,下面有个resin.conf的文件,打开它,将下面这段配置添加进去,然后重启resin(大家应该知道如何重启吧): <jvm-arg>-Xde ...
- 高手速成android开源项目【项目篇】
主要介绍那些Android还不错的完整项目,目前包含的项目主要依据是项目有意思或项目分层规范比较好.Linux项目地址:https://github.com/torvalds/linuxAndroid ...
- koa执行过程原理分析
本文原创,转载请注明出处https://i.cnblogs.com/EditPosts.aspx?postid=5710639 我们大家都知道,当koa接到请求经过中间件时,当执行到 yield ne ...
- 从零开始学 Web 之 移动Web(三)Zepto
大家好,这里是「 从零开始学 Web 系列教程 」,并在下列地址同步更新...... github:https://github.com/Daotin/Web 微信公众号:Web前端之巅 博客园:ht ...
- Python 虚拟环境 | Mac/Linux下如何避坑安装配置Virtualenv
1.为什么要使用虚拟环境 在Python中,不同的应用可能需要用到不同版本的第三方包,而这些第三方包被统一存放到目录site-packages中,不同版本的包容易相互覆盖,如安装Django 2.1时 ...
- nginx介绍(二) - 默认配置
前言 前面, 在浏览器中, 输入linux 的ip, 出现了以下页面: 那这个页面在哪里呢? 一. 工具 notepad++ 在进入主题之前, 先来介绍下, 一会使用到的工具. 在notepad++里 ...
- phpStorm使用技巧总结
工欲善其事,必先利其器. 拥有一个好的工具不仅可以事半功倍,而且也令人神清气爽. 在编辑器上,我所走过的路是这样的:notepad(对,就是最原始的WIN下的note) -> editplus ...
- Ansible系列(五):各种变量定义方式和变量引用
Ansible系列文章:http://www.cnblogs.com/f-ck-need-u/p/7576137.html 1.1 ansible facts facts组件是用来收集被管理节点信息的 ...