
crawler_exa4
优化中...
#! /usr/bin/env python
# -*- coding:utf-8 -*-
# Author: Tdcqma '''
获取漏洞目标站点:绿盟安全漏洞通告 v1.0:
由于网站结构存在变更的可能性,一旦爬虫爬取的页面发生变化则会影响正则表达式的匹配,导致爬虫失效。为了解决这个问题重新架构该爬虫,新的爬虫将分3个部分,即:
【1】信息收集:一旦网站结构发生变化只需要更改此部分的正则表达式即可,收集的信息需要保存至一个嵌套列表中。
【2】信息筛选:即使网站结构发生变化也不需要变更此部分。
【3】信息发送:即使网站结构发生变化也不需要变更此部分。
v1.1
添加 "风险级别" 功能到报警信息中,由【CVE 通用漏洞与披露】库中获取对应漏洞的风险级别
v1.2
添加漏洞总数功能
v1.3
删除"风险级别"选项,因为http://cve.scap.org.cn/站点故障
优化代码
v1.4
使用BeautifulSoup模块优化内容搜索
v1.5
优化模块2(信息筛选),对信息进行按系统分类显示
v1.6
优化v1.5部分,对代码部分进行函数化整理
''' import urllib.request
import ssl,re
import smtplib,email
import datetime
from bs4 import BeautifulSoup # ---------------------------------------------
# 【1】信息收集,正则表达匹配网站信息,包括date、title、url等,
# 将所有信息保存至sec_all_list列表中
# --------------------------------------------- f = open("secInfo-lvmeng.txt", 'w', encoding='utf-8') # 爬虫爬取当天的漏洞告警信息,也可指定如2017-10-09样式的日期格式用于开发过程中的测试
#today = str(datetime.date.today())
today = "2017-09-28" # 指定爬虫网站的首页链接
sec_vul_domain = "http://www.nsfocus.net/" # 生成字典用于保存漏洞网站的跳转链接
vul_dict = {} # 该变量保存漏洞跳转页面链接:http://www.nsfocus.net/index.php?act=sec_bug
sec_vul_homepage = "" # 收集所有漏洞信息并保存在列表中
sec_all_list = [] # 将列表漏洞转换为字符串
data_str = "" # 将需要监控的系统名称添加至该列表即可实现爬虫功能
system_list = ["Apache","Cisco","Samba","Dnsmasq","Microsoft"] # 该变量保存所有指定系统的格式化后的漏洞信息,邮件发送也是基于该变量里保存的漏洞信息
all_vul_msg = "" # 计算漏洞总数
count = 0 # 传入不同的page链接以获取相应response
def get_response(vul_url):
request = urllib.request.Request(vul_url)
# 当尝试访问https开始当站点时,设置全局取消SSL证书验证
ssl._create_default_https_context = ssl._create_unverified_context
response = urllib.request.urlopen(request)
data = response.read().decode('utf-8')
return data data_homepage = get_response(sec_vul_domain)
soup = BeautifulSoup(data_homepage, features="lxml")
tag1 = soup.find_all(name='a')
for item in tag1:
if "安全漏洞" in item:
# 通过获取标签属性,即使站点结构发生变化也能拿到漏洞页面的链接
attrs = item.attrs
vul_dict = attrs.copy()
sec_vul_homepage = vul_dict.get('href') # 同一天的爆出的漏洞个数可能要占用好几个页面,需指定被扫描网站需要扫描的网页数范围,默认读取10页
for i in range(10):
sec_vul_pageNoUrl = sec_vul_homepage +"&type_id=&os=&keyword=&page=%s" % (i+1)
data_sec_vul = get_response(sec_vul_pageNoUrl) if today in data_sec_vul: str_re = "<span>"+today+"</span>.*"
res = re.findall(str_re,data_sec_vul) for item in res:
data_str += item + '\n' sec_vul_soup = BeautifulSoup(data_str, features="lxml")
tag_a = sec_vul_soup.find_all(name='a') for item in tag_a:
# 生成列表用于收集单独的漏洞信息
sec_sub_list = [] # 收集漏洞标题: title
sec_sub_title = item.string
sec_sub_list.append(sec_sub_title) # 收集漏洞url: sec_sub_url
item = str(item)
sub_url = re.findall("vulndb/\d+",item)
sec_sub_url = sec_vul_domain + sub_url[0]
sec_sub_list.append(sec_sub_url) # 收集漏洞受影响的版本: aff_ver
data_sec_vul_cve = get_response(sec_sub_url)
affected_version = re.findall("<blockquote>.*</blockquote>", data_sec_vul_cve, re.S)
affected_version = str(affected_version[0][12:-13])
affected_version = affected_version.replace("<br />", "")
affected_version = affected_version.replace(">",">")
affected_version = affected_version.replace("<","<")
aff_ver = affected_version.replace("</blockquote><b>不受影响系统:</b><blockquote>","\n不受影响版本:\n")
sec_sub_list.append(aff_ver) if sec_sub_list not in sec_all_list:
sec_all_list.append(sec_sub_list) # ---------------------------------------------
# 【2】信息筛选
# --------------------------------------------- # 各系统漏洞在筛选后最终会保存至各自msg_***变量中,
# >>>添加新监控系统时需相应添加以下记录<<<
msg_cisco = ">>> CISCO安全通告\n"
msg_apache = "\n>>> APACHE安全通告\n" # 调用sub_sec_info方法,将漏洞信息格式化输出
def sub_sec_info():
global count
count += 1
sec_info = "\n漏洞名称:" + line[0] \
+ "\n漏洞链接:" + line[1] \
+ "\n受影响的系统:\n" + line[2] + '\n'
return sec_info # 调用get_sec_info函数,将目标系统或应用名称作为参数传入,即可获取相关爬虫告警信息
def get_sec_info(vul):
vul = vul.capitalize()
global msg_cisco
global msg_apache # >>>添加新监控系统时需相应添加以下elif记录<<<
if vul in line[0]:
if "Cisco" in vul:
msg_cisco += sub_sec_info()
elif "Apache" in vul:
msg_apache += sub_sec_info() # 漏洞信息筛选入口函数
for line in sec_all_list:
for sys in system_list:
get_sec_info(sys) # >>>添加新监控系统时需相应添加以下记录<<<
all_vul_msg += msg_cisco
all_vul_msg += msg_apache
all_vul_msg += "\n漏洞总数:【"+str(count)+"】 " # 为放置数据丢失,同时将筛选后的爬虫信息写入文本f中,f指向secInfo-lvmeng.txt文档。
f.writelines(all_vul_msg)
#print(msg) # ---------------------------------------------
# 【3】信息发送
# --------------------------------------------- # 配制收发邮件客户端
chst = email.charset.Charset(input_charset = 'utf-8')
header = ("From: %s\nTo: %s\nSubject: %s\n\n" %
("from_mail@163.com",
"to_mail@163.com",
chst.header_encode("[爬虫安全通告-绿盟]"))) #借用163smtp服务器发送邮件,将上面读到的报警信息(all_vul_msg)作为邮件正文发送。
email_con = header.encode('utf-8') + all_vul_msg.encode('utf-8')
smtp = smtplib.SMTP("smtp.163.com")
smtp.login("from_mail@163.com","from_mail_pass")
smtp.sendmail('from_mail@163.com','to_mail@163.com',email_con)
print('mail send success!')
smtp.quit()
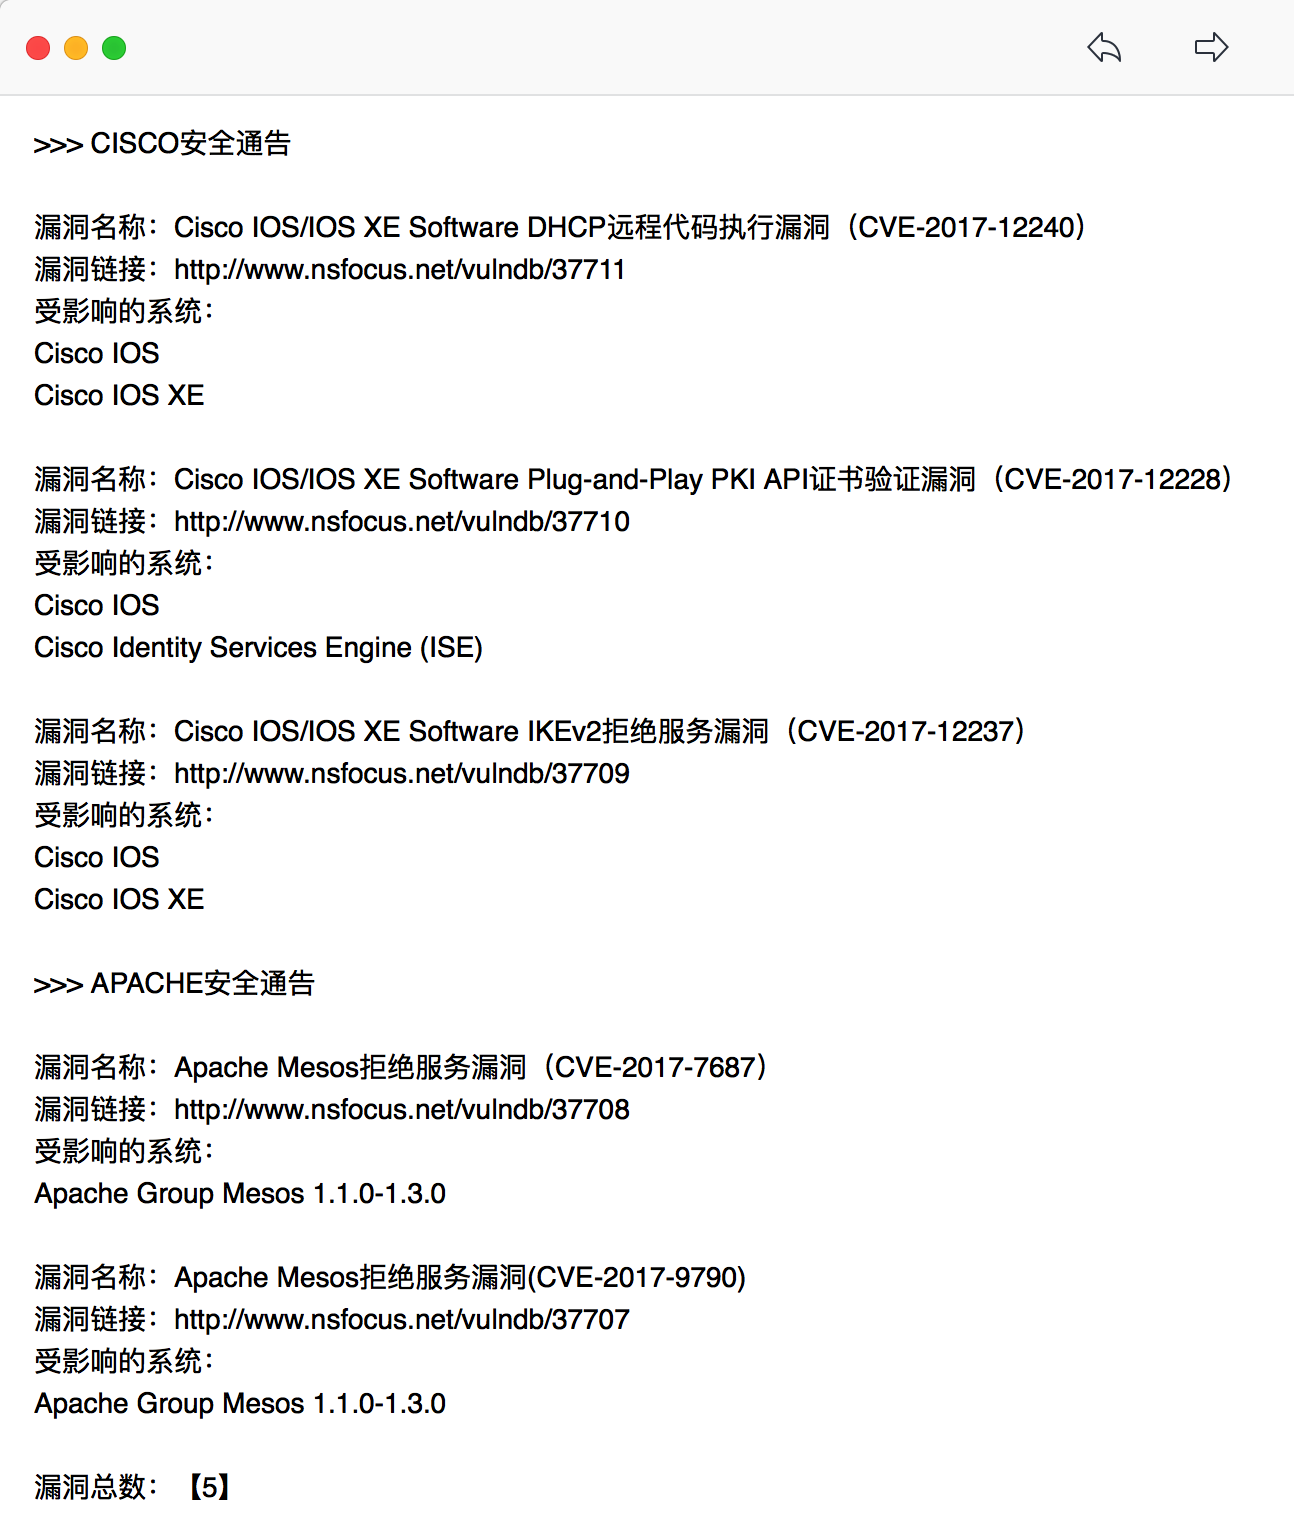
邮件截图:
crawler_exa4的更多相关文章
随机推荐
- Linux学习笔记6
less 命令 空格或者 ctrl+f 前进一屏 ctrl+b 回退一屏 回车 前进一行 /String 查找含有string 字符串的页 ?String 同上 <反方向查找> ...
- html 的实践
<!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8&quo ...
- Xamarin Essentials教程获取路径文件系统FileSystem
Xamarin Essentials教程获取路径文件系统FileSystem 文件系统用于管理设备内的各类文件.通过文件系统,应用程序可以创建永久文件和临时文件,也可以获取预先打包的文件,如预设数据库 ...
- c c++ #define 定义假函数
#define Add(a,b) ((a)+(b)) #define Max(a,b) ((a)>(b)?(a):(b)) 这就定义了一个假的函数 说白了就是字符串替换 这样在写代码时能 ...
- HTTP1.1协议-RFC2616-中文版课前资料收集
1.http rfc大致讲了什么? 2.解决了什么问题? HTTP协议描述的是发送方与接收方的通信协议 协议功能: HTTP协议(HyperText Transfer Protocol,超文本传输协议 ...
- Kafka中时间轮分析与Java实现
在Kafka中应用了大量的延迟操作但在Kafka中 并没用使用JDK自带的Timer或是DelayQueue用于延迟操作,而是使用自己开发的DelayedOperationPurgatory组件用于管 ...
- 三种进程和线程数据共享模块方法Queue》Pipe》manager
>>>>线程中的queue import threading import queue def f(qq): print("in child",qq.qsi ...
- python之名称空间
1 类名称空间 创建一个类就会创建一个类的名称空间,用来存储类中定义的所有名字,这些名字称为类的属性 而类的良好总属性:数据属性和函数属性 其中类的数据属性是共享给所有对象 print(id(g1.c ...
- python之函数联系
----------------------作业一 # 有两个列表,分别存放来老男孩报名学习linux和python课程的学生名字# linux=['钢弹','小壁虎','小虎比','alex','w ...
- 使用html5 Canvas绘制线条(直线、折线等)
使用html5 Canvas绘制直线所需的CanvasRenderingContext2D对象的主要属性和方法(有"()"者为方法)如下: 属性或方法 基本描述 strokeSty ...