
一致性hash-java实现treemap版
把不同号段的数据储存在不同的机器上,以用来分散压力。假如我们有一百万个QQ号,十台机器,,如何划分呢?
最简单粗暴的方法是用QQ号直接对10求余,结果为0-9 分别对应上面的十台机器。比如QQ号为 23900 的用户在编号为0的机器 23901的用户在编号为1的机器,以此类推。那么问题来了,现在QQ用户急剧上升 由一百万涨到了五百万,显然10台机器已经无能为力
了,于是我们扩充到25台。这个时候我们发现以前的数据全乱了。完蛋!只能跑路了……
Hash 算法的一个衡量指标是单调性( Monotonicity ),定义如下:
单调性是指如果已经有一些内容通过哈希分派到了相应的缓冲中,又有新的缓冲加入到系统中。哈希的结果应能够保证原有已分配的内容可以被映射到新的缓冲中去,而不会被映射到旧的缓冲集合中的其他缓冲区。
容易看到,上面的简单 hash 算法 hash(object)%N 难以满足单调性要求。
所以在保证合理分散的情况下,我们还是是可拓展的。这就是一致性hash,一致性hash 算法都是将 value 映射到一个 32 位的 key 值,也即是 0~2^32-1 次方的数值空间;我们可以将这个空间想象成一个首( 0 )尾( 2^32-1 )相接的圆环,当有数据过来按顺时针找到离他最近的一个点,这个点,就是我要的节点机器。如下图:
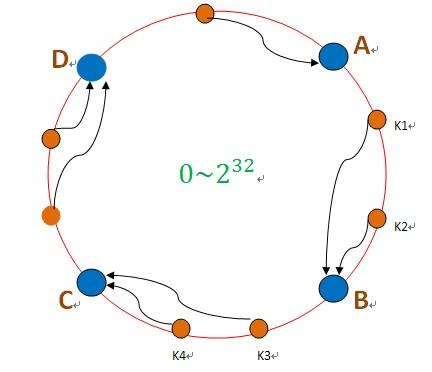 hash("192.168.128.670") ---->A //根据服务器IP hash出去生成节点
hash("192.168.148.670") ---->C //根据服务器IP hash出去生成节点
hash("81288812") ----> k1 //根据QQ号 hash出去生成值 ----->顺时针找到机器
hash("8121243812") ----> k4 //根据QQ号 hash出去生成值 ----->顺时针找到机器
这样当有新的机器加进来,旧的机器去掉,影响的也是一小部分的数据。这样看似比较完美了,,但假如其中一个节点B数据激增,挂了,所有数据会倒到C--->C也扛不住了---->所有数据会倒到D ……以此类推,最终全挂了!整个世界清静了!!!
显然,这种方式因为数据的不平均导致服务挂了。所以我们的一致性hash还需要具有平衡性。
平衡性是指哈希的结果能够尽可能分布到所有的缓冲中去,这样可以使得所有的缓冲空间都得到利用。
为解决平衡性,一致性hash引入了虚拟节点”的概念。“虚拟节点”( virtual node )是实际节点在 hash 空间的复制品( replica ),一实际个节点对应了若干个“虚拟节点”,这个对应个数也成为“复制个数”,“虚拟节点”在 hash 空间中以 hash 值排列。这样我们如果有25台服务器,每台虚拟成10个,就有250个虚拟节点。这样就保证了每个节点的负载不会太大,压力均摊,有事大家一起扛!!!
hash("192.168.128.670#36kr01") ---->A //根据服务器IP hash出去生成节点
hash("192.168.128.670#36kr02") ---->B //根据服务器IP hash出去生成节点
hash("192.168.128.670#36kr03") ---->B //根据服务器IP hash出去生成节点
……
final 虚拟节点+murmurhash成了我们的解决方案:
class Shard<S> { // S类封装了机器节点的信息 ,如name、password、ip、port等

    private TreeMap<Long, S> nodes; // 虚拟节点

    private List<S> shards; // 真实机器节点

    private final int NODE_NUM = 100; // 每个机器节点关联的虚拟节点个数

    public Shard(List<S> shards) {

        super();

        this.shards = shards;

        init();

    }

    private void init() { // 初始化一致性hash环

        nodes = new TreeMap<Long, S>();

        for (int i = 0; i != shards.size(); ++i) { // 每个真实机器节点都需要关联虚拟节点

            final S shardInfo = shards.get(i);

            for (int n = 0; n < NODE_NUM; n++)

                // 一个真实机器节点关联NODE_NUM个虚拟节点

                nodes.put(hash("SHARD-" + i + "-NODE-" + n), shardInfo);

        }

    }

    public S getShardInfo(String key) {

        SortedMap<Long, S> tail = nodes.tailMap(hash(key)); // 沿环的顺时针找到一个虚拟节点

        if (tail.size() == 0) {

            return nodes.get(nodes.firstKey());

        }

        return tail.get(tail.firstKey()); // 返回该虚拟节点对应的真实机器节点的信息

    }

    /**

     *  MurMurHash算法,是非加密HASH算法,性能很高,

     *  比传统的CRC32,MD5,SHA-1(这两个算法都是加密HASH算法,复杂度本身就很高,带来的性能上的损害也不可避免)

     *  等HASH算法要快很多,而且据说这个算法的碰撞率很低.

     *  http://murmurhash.googlepages.com/

     */

    private Long hash(String key) {

        ByteBuffer buf = ByteBuffer.wrap(key.getBytes());

        int seed = 0x1234ABCD;

        ByteOrder byteOrder = buf.order();

        buf.order(ByteOrder.LITTLE_ENDIAN);

        long m = 0xc6a4a7935bd1e995L;

        int r = 47;

        long h = seed ^ (buf.remaining() * m);

        long k;

        while (buf.remaining() >= 8) {

            k = buf.getLong();

            k *= m;

            k ^= k >>> r;

            k *= m;

            h ^= k;

            h *= m;

        }

        if (buf.remaining() > 0) {

            ByteBuffer finish = ByteBuffer.allocate(8).order(

                    ByteOrder.LITTLE_ENDIAN);

            // for big-endian version, do this first:

            // finish.position(8-buf.remaining());

            finish.put(buf).rewind();

            h ^= finish.getLong();

            h *= m;

        }

        h ^= h >>> r;

        h *= m;

        h ^= h >>> r;

        buf.order(byteOrder);

        return h;

    }

}
一致性hash-java实现treemap版的更多相关文章
- 对一致性Hash算法,Java代码实现的深入研究
一致性Hash算法 关于一致性Hash算法,在我之前的博文中已经有多次提到了,MemCache超详细解读一文中"一致性Hash算法"部分,对于为什么要使用一致性Hash算法.一致性 ...
- Java实现一致性Hash算法深入研究
一致性Hash算法 关于一致性Hash算法,在我之前的博文中已经有多次提到了,MemCache超详细解读一文中”一致性Hash算法”部分,对于为什么要使用一致性Hash算法和一致性Hash算法的算法原 ...
- Java 一致性Hash算法的学习
目前我们很多时候都是在做分布式系统,但是我们需把客户端的请求均匀的分布到N个服务器中,一般我们可以考虑通过Object的HashCodeHash%N,通过取余,将客户端的请求分布到不同的的服务端.但是 ...
- 一致性hash算法及java实现
一致性hash算法是分布式中一个常用且好用的分片算法.或者数据库分库分表算法.现在的互联网服务架构中,为避免单点故障.提升处理效率.横向扩展等原因,分布式系统已经成为了居家旅行必备的部署模式,所以也产 ...
- 一致性hash(整理版)
简单解释: 简单解释一致性hash的原理:网上通篇都是用服务器做的举例,我这里也如此,主要是便于理解. 通常:有N个客户端请求服务器,假设有M台web服务器,通常为了均衡访问会进行N%M的取模,然后分 ...
- 对一致性Hash算法及java实现(转)
一致性Hash算法 关于一致性Hash算法,在我之前的博文中已经有多次提到了,MemCache超详细解读一文中"一致性Hash算法"部分,对于为什么要使用一致性Hash算法.一致性 ...
- 对一致性Hash算法,Java代码实现的深入研究(转)
转载:http://www.cnblogs.com/xrq730/p/5186728.html 一致性Hash算法 关于一致性Hash算法,在我之前的博文中已经有多次提到了,MemCache超详细解读 ...
- 【策略】一致性Hash算法(Hash环)的java代码实现
[一]一致性hash算法,基本实现分布平衡. package org.ehking.quartz.curator; import java.util.SortedMap; import java.ut ...
- 【转载】对一致性Hash算法,Java代码实现的深入研究
原文地址:http://www.cnblogs.com/xrq730/p/5186728.html 一致性Hash算法 关于一致性Hash算法,在我之前的博文中已经有多次提到了,MemCache超详细 ...
- Java实现一致性Hash算法
Java代码实现了一致性Hash算法,并加入虚拟节点.,具体代码为: package com.baijob.commonTools; import java.util.Collection; im ...
随机推荐
- [C++] 拓展属性
inline函数 函数重载 占位参数和默认参数 /*__________________________________________________________________ 背景: C++ ...
- 洛谷P1101单词方阵
题目描述 给一n×n的字母方阵,内可能蕴含多个“yizhong”单词.单词在方阵中是沿着同一方向连续摆放的. 摆放可沿着 8个方向的任一方向,同一单词摆放时不再改变方向,单词与单词之间可以交叉,因此有 ...
- linux误删除恢复
extundelete 大家基本都知道,在linux上误删除了东西后果是很严重的,尤其是在服务器上误删除了东西,对于字符终端,想要实现恢复删除的数据更是难上加难,对于Linux误删除了重要的东西,虽然 ...
- android studio 配置网络代理
1.首先在vultr网站购买服务器. 然后使用shadowsocksR给服务器配置FQ,再在本地机器配置好shadowsocksR. 参考网址:https://github.com/getlanter ...
- FOJ Problem 1015 土地划分
Problem 1015 土地划分 Accept: 823 Submit: 1956Time Limit: 1000 mSec Memory Limit : 32768 KB Probl ...
- 201621123033 《Java程序设计》第4周学习总结
1. 本周学习总结 1.1 写出你认为本周学习中比较重要的知识点关键词 父类 子类 继承 覆盖 抽象 1.2 尝试使用思维导图将这些关键词组织起来.注:思维导图一般不需要出现过多的字. 1.3 可选: ...
- [AtCoder ARC103A]/\/\/\/
题目大意:给你一串长度为$n$的序列,要求把这个序列变成$abab\dots abab$的形式,且$a\not =b$,问最少要改几个数字 题解:求出奇偶位上前二多的数字就判断一下就行了 卡点:无 C ...
- 雅礼集训 Day6 T1 Merchant 解题报告
Merchant 题目描述 有\(n\)个物品,第\(i\)个物品有两个属性\(k_i,b_i\),表示它在时刻\(x\)的价值为\(k_i\times x+b_i\). 当前处于时刻\(0\),你可 ...
- 用HTML5绘制的一个星空特效图
<!doctype html> <html lang="en"> <head> <meta charset="UTF-8&quo ...
- [leetcode]Convert Sorted Array to Binary Search Tre
排好序的... 中间是root , root左边是left,root右边是right 递归建树. /** * Definition for binary tree * struct TreeNode ...