
node实现爬虫
node实现获取到豆瓣电影排行榜页面。
准备工作:
1.新建一个文件夹node 在当前文件夹中打开cmd
下载 npm install
初始化 npm init(注意一下:如果你的npm init没有作用可以使用npm init -y)
2.下载模块
- superagent可以发起http请求
- cheerio解析http返回的html内容,可以理解为一个Node.js版的 jquery,使用方式跟jquery相同
- fs设置文件,在获取到图片的路径之后,可以实现将图片保存在本地
- request采用这个模块,向服务器发起请求,获取图片资源
- eventproxy:利用事件机制解决回调函数深度嵌套的问题
- async:多线程并发控制
3.在node中新建两个文件夹
data放置得到的数据的内容 image获取得到的图片
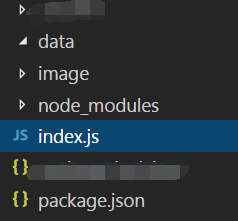
开始编写代码。
var superagent=require('superagent');

var cheerio=require('cheerio');

var url=require('url');

var fs=require("fs");

var request=require('request');

var targeturl='https://movie.douban.com/chart';

var eventproxy=require('eventproxy');

var ep=new eventproxy()

var async=require('async')

superagent.get(targeturl).end(function(err,res){

    if(err){

        return console.error(err)

    }

    console.log('爬虫开始')

    var $=cheerio.load(res.text);//利用cheerio开始解析页面

    var repoUrls=[];//保存url

    var titleArray=[];

    console.log($('.item .pl2').length)

    $(".item .pl2").each(function(index,element){

        var $element=$(element);

        var href=url.resolve('https://movie.douban.com',$element.find("a").attr('href'))

        repoUrls.push(href)

        //获取每个仓库名字

        var $title=$element.find("a").contents()

        $title=$title[0].data.substr(0,$title.length-1)

        titleArray.push($title)

        var news={

            //名字

            title:$title,

            //路径

            url:href

        }

        console.log($)

        saveImage($,news)

    })

    repoUrls=repoUrls.slice(0,2)

    concurrencyCount=0;//当前并发记录

    var fetchUrl=function(repoUrl,callback){

        concurrencyCount++

        console.log('现在的并发数是',concurrencyCount,',正在抓取的是',repoUrl)

        superagent.get(repoUrl).end(function(err,res){

            var $=cheerio.load(res.text);

            //对也面内容进行解析

            var httpGitUrl=$('.item').attr('value')

            return ({

                url:repoUrl,

                httpGitUrl:httpGitUrl

            })

            concurrencyCount--;

            callback(null,repoUrl)

        });

    }

    async.mapLimit(repoUrls,5,function(repoUrl,callback){

        //对每个url进行相关处理

        fetchUrl(repoUrl,callback)

    },function(err,result){

        console.log('final');

    }

    )

})

//保留图片资源

function saveImage($,news){

    $(".item .nbg img").each(function(index,item){

        var img_title=$(this).attr("alt");//获取图片名字

        console.log(img_title)

        var img_filename=img_title+'.jpg';

        var img_src=$(this).attr("src");//获取图片的路径

        //采用request模块,向服务器发起一次请求,获取图片资源

        request.head(img_src,function(err,res,body){

            if(err){

                console.log(err)

            }

        });

        request(img_src).pipe(fs.createWriteStream('./image/'+news+'---'+img_filename))

    })

}
这样代码就完成了
开始执行代码:
然后再cmd中node index.js就可以了
git地址:https://github.com/GainLoss/MyNode/tree/master/Node%20crawler
参考:
https://byronlun.github.io/posts/2017-01-20-NodeJS爬虫摸索教程.html
http://blog.csdn.net/yezhenxu1992/article/details/50820629
node实现爬虫的更多相关文章
- 【原】小玩node+express爬虫-2
上周写了一个node+experss的爬虫小入门.今天继续来学习一下,写一个爬虫2.0版本. 这次我们不再爬博客园了,咋玩点新的,爬爬电影天堂.因为每个周末都会在电影天堂下载一部电影来看看. talk ...
- Node.js爬虫-爬取慕课网课程信息
第一次学习Node.js爬虫,所以这时一个简单的爬虫,Node.js的好处就是可以并发的执行 这个爬虫主要就是获取慕课网的课程信息,并把获得的信息存储到一个文件中,其中要用到cheerio库,它可以让 ...
- node.js爬虫
这是一个简单的node.js爬虫项目,麻雀虽小五脏俱全. 本项目主要包含一下技术: 发送http抓取页面(http).分析页面(cheerio).中文乱码处理(bufferhelper).异步并发流程 ...
- <node.js爬虫>制作教程
前言:最近想学习node.js,突然在网上看到基于node的爬虫制作教程,所以简单学习了一下,把这篇文章分享给同样初学node.js的朋友. 目标:爬取 http://tweixin.yueyishu ...
- node:爬虫爬取网页图片
代码地址如下:http://www.demodashi.com/demo/13845.html 前言 周末自己在家闲着没事,刷着微信,玩着手机,发现自己的微信头像该换了,就去网上找了一下头像,看着图片 ...
- Node.js aitaotu图片批量下载Node.js爬虫1.00版
即使是https网页,解析的方式也不是一致的,需要多试试. 代码: //====================================================== // aitaot ...
- Node.js umei图片批量下载Node.js爬虫1.00
这个爬虫在abaike爬虫的基础上改改图片路径和下一页路径就出来了,代码如下: //====================================================== // ...
- Node.js abaike图片批量下载Node.js爬虫1.01版
//====================================================== // abaike图片批量下载Node.js爬虫1.01 // 1.01 修正了输出目 ...
- Node.js abaike图片批量下载Node.js爬虫1.00版
这个与前作的差别在于地址的不规律性,需要找到下一页的地址再爬过去找. //====================================================== // abaik ...
- Node JS爬虫:爬取瀑布流网页高清图
原文链接:Node JS爬虫:爬取瀑布流网页高清图 静态为主的网页往往用get方法就能获取页面所有内容.动态网页即异步请求数据的网页则需要用浏览器加载完成后再进行抓取.本文介绍了如何连续爬取瀑布流网页 ...
随机推荐
- 页面布局常用,让子级div排排坐
画页面的时候经常遇到页面布局的问题,父级div包裹多个子div很常见,代码如下: <div> <div style='width:100px;height: 100px;backgr ...
- .net core项目中引用.net framework封装的dll库
https://blog.csdn.net/sharphou/article/details/80746551 A----------如何安装IIS [Server Hosting]------- ...
- Java多线程之同步集合和并发集合
Java多线程之同步集合和并发集合 不管是同步集合还是并发集合他们都支持线程安全,他们之间主要的区别体现在性能和可扩展性,还有他们如何实现的线程安全. 同步集合类 Hashtable Vector 同 ...
- 这是通过 Open Live Writer(是个博客编辑器) 发布的
Open Live Writer 是开源的win10上的博客编辑器
- if else 选择机构 _多重if选择机构_if选择结构嵌套(综合练习题——code)
import java.util.*; class If01{ public static void main(String[ ]args){ //练习1:假如张三参加Java考试,判断如果在95分以 ...
- leetcode 197. Rising Temperature sql_Date用法
https://leetcode.com/problems/rising-temperature/description/ 题目需要选出今天比昨天气温高的ID 用join,默认是inner join需 ...
- BuildAssetBundles文件打包
BuildAssetBundles文件打包: public class BuildAssetBundlesTest : Editor { //定义打包文件路径 public static string ...
- Murano Setup Steps
1. Select a Linux Distribution Only Ubuntu 14.04 (Trusty), Fedora 21 (or Fedora 22) and CentOS/RHEL ...
- .NET控制台程序监听程序退出
There are mainly 2 types of Win32 applications, console application and window application. They hav ...
- Ubuntu 16.04下安装Charles抓包工具
Charles是一个跨平台的抓包工具,虽然没有Fiddler做的这么完美,但是也算是另一个选择. 下载: https://www.charlesproxy.com/download/ 注册: http ...