
数据预处理中归一化(Normalization)与损失函数中正则化(Regularization)解惑
背景:数据挖掘/机器学习中的术语较多,而且我的知识有限。之前一直疑惑正则这个概念。所以写了篇博文梳理下
摘要:
1.正则化(Regularization)
1.1 正则化的目的
1.2 正则化的L1范数(lasso),L2范数(ridge)
2.归一化 (Normalization)
2.1归一化的目的
2.1归一化计算方法
2.2.spark ml中的归一化
2.3 python中skelearn中的归一化
知识总结:
1.正则化(Regularization)
1.1 正则化的目的:我的理解就是平衡训练误差与模型复杂度的一种方式,通过加入正则项来避免过拟合(over-fitting)。
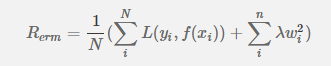
后面的
 就是正则化项,其中λ越大表明惩罚粒度越大,等于0表示不做惩罚,N表示所有样本的数量,n表示参数的个数。

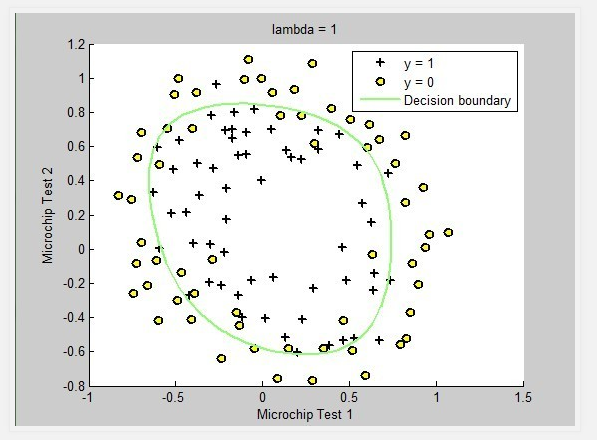
上图的 lambda = 0表示未做正则化,模型过于复杂(存在过拟合)
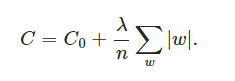 ,其中C0是代价函数,
 是L1正则项,lambda是正则化参数
L2正则化:
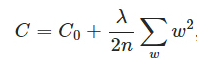 ,其中
 是L2正则项,lambda是正则化参数
L1与L2正则化的比较:
1.L1会趋向于产生少量的特征,而其他的特征都是0,而L2会选择更多的特征,这些特征都会接近于0。
2.Lasso在特征选择时候非常有用,而Ridge就只是一种规则化而已。
2.归一化 (Normalization)
2.1归一化的目的:
1)归一化后加快了梯度下降求最优解的速度;
2)归一化有可能提高精度。详解可查看
2.2归一化计算方法
2.3.spark ml中的归一化
newNormalizer(p: Double) ,其中p就是计算公式中的向量绝对值的幂指数
可以使用transform方法对Vector类型或者RDD[Vector]类型的数据进行正则化
下面举一个简单的例子:
scala> val dv: Vector = Vectors.dense(3.0,4.0)
dv: org.apache.spark.mllib.linalg.Vector = [3.0,4.0]
scala> val l2 = new Normalizer(2)
scala> l2.transform(dv)
res8: org.apache.spark.mllib.linalg.Vector = [0.6,0.8]
或者直接使用Vertors的norm方法:val norms = data.map(Vectors.norm(_, 2.0))
2.4 python中skelearn中的归一化
from sklearn.preprocessing import Normalizer
#归一化,返回值为归一化后的数据
Normalizer().fit_transform(iris.data)
数据预处理中归一化(Normalization)与损失函数中正则化(Regularization)解惑的更多相关文章
- 数据预处理 | 使用 Pandas 统一同一特征中不同的数据类型
出现的问题:如图,总消费金额本应该为float类型,此处却显示object 需求:将 TotalCharges 的类型转换成float 使用 pandas.to_numeric(arg, errors ...
- python中常用的九种数据预处理方法分享
Spyder Ctrl + 4/5: 块注释/块反注释 本文总结的是我们大家在python中常见的数据预处理方法,以下通过sklearn的preprocessing模块来介绍; 1. 标准化(St ...
- sklearn中的数据预处理和特征工程
小伙伴们大家好~o( ̄▽ ̄)ブ,沉寂了这么久我又出来啦,这次先不翻译优质的文章了,这次我们回到Python中的机器学习,看一下Sklearn中的数据预处理和特征工程,老规矩还是先强调一下我的开发环境是 ...
- 机器学习实战基础(九):sklearn中的数据预处理和特征工程(二) 数据预处理 Preprocessing & Impute 之 数据无量纲化
1 数据无量纲化 在机器学习算法实践中,我们往往有着将不同规格的数据转换到同一规格,或不同分布的数据转换到某个特定分布的需求,这种需求统称为将数据“无量纲化”.譬如梯度和矩阵为核心的算法中,譬如逻辑回 ...
- 文本数据预处理:sklearn 中 CountVectorizer、TfidfTransformer 和 TfidfVectorizer
文本数据预处理的第一步通常是进行分词,分词后会进行向量化的操作.在介绍向量化之前,我们先来了解下词袋模型. 1.词袋模型(Bag of words,简称 BoW ) 词袋模型假设我们不考虑文本中词与词 ...
- 深度挖坑:从数据角度看人脸识别中Feature Normalization,Weight Normalization以及Triplet的作用
深度挖坑:从数据角度看人脸识别中Feature Normalization,Weight Normalization以及Triplet的作用 周翼南 北京大学 工学硕士 373 人赞同了该文章 基于深 ...
- Python初探——sklearn库中数据预处理函数fit_transform()和transform()的区别
敲<Python机器学习及实践>上的code的时候,对于数据预处理中涉及到的fit_transform()函数和transform()函数之间的区别很模糊,查阅了很多资料,这里整理一下: ...
- postgreSQL使用sql归一化数据表的某列,以及出现“字段 ‘xxx’ 必须出现在 GROUP BY 子句中或者在聚合函数中”错误的可能原因之一
前言: 归一化(区别于标准化)一般是指,把数据变换到(0,1)之间的小数.主要是为了方便数据处理,或者把有量纲表达式变成无量纲表达式,便于不同单位或量级的指标能够进行比较和加权. 不过还是有很多人使用 ...
- 借助 SIMD 数据布局模板和数据预处理提高 SIMD 在动画中的使用效率
原文链接 简介 为发挥 SIMD1 的最大作用,除了对其进行矢量化处理2外,我们还需作出其他努力.可以尝试为循环添加 #pragma omp simd3,查看编译器是否成功进行矢量化,如果性能有所提升 ...
随机推荐
- Angular2学习笔记(1)
Angular2学习笔记(1) 1. 写在前面 之前基于Electron写过一个Markdown编辑器.就其功能而言,主要功能已经实现,一些小的不影响使用的功能由于时间关系还没有完成:但就代码而言,之 ...
- 移动端IOS点击事件失效解决方案
解决方案 解决办法有 4 种可供选择: 1 将 click 事件直接绑定到目标元素(即 .target)上 2 将目标元素换成 <a> 或者 button 等可点击的元素 3 将 clic ...
- javascript:逆波兰式表示法计算表达式结果
逆波兰式表示法,是由栈做基础的表达式,举个例子: 5 1 2 + 4 * + 3 - 等价于 5 + ((1 + 2) * 4) - 3 原理:依次将5 1 2 压入栈中, 这时遇到了运算符 + ...
- DDD 领域驱动设计-谈谈 Repository、IUnitOfWork 和 IDbContext 的实践(3)
上一篇:<DDD 领域驱动设计-谈谈 Repository.IUnitOfWork 和 IDbContext 的实践(2)> 这篇文章主要是对 DDD.Sample 框架增加 Transa ...
- 破解SQLServer for Linux预览版的3.5GB内存限制 (UBUNTU篇)
在上一篇中我提到了如何破解RHEL上SQLServer的内存大小限制,但是Ubuntu上还有一道检查 这篇我将会讲解如何在3.5GB以下内存的Ubuntu中安装和运行SQLServer for Lin ...
- Selenium的PO模式(Page Object Model)[python版]
Page Object Model 简称POM 普通的测试用例代码: .... #测试用例 def test_login_mail(self): driver = self.driver driv ...
- Linux服务器安全配置
众所周知,网络安全是一个非常重要的课题,而服务器是网络安全中最关键的环节.Linux被认为是一个比较安全的Internet服务器,作为一种开放源代码操作系统,一旦Linux系统中发现有安全漏洞,Int ...
- Linux.NET实战手记—自己动手改泥鳅(上)
各位读者大家好,不知各位读者有否阅读在下的前一个系列<Linux.NET 学习手记>,在前一个系列中,我们从Linux中Mono的编译安装开始,到Jexus服务器的介绍,以及如何在Linu ...
- Lesson 23 A new house
Text I had a letter from my sister yesterday. She lives in Nigeria. In her letter, she said that she ...
- Angular2学习笔记——路由器模型(Router)
Angular2以组件化的视角来看待web应用,使用Angular2开发的web应用,就是一棵组件树.组件大致分为两类:一类是如list.table这种通放之四海而皆准的通用组件,一类是专为业务开发的 ...