
python爬虫笔记之爬取足球比赛赛程
目标:爬取某网站比赛赛程,动态网页,则需找到对应ajax请求(具体可参考:https://blog.csdn.net/you_are_my_dream/article/details/53399949)
# -*- coding:utf-8 -*-

import sys

import re

import urllib.request

link = "https://***"

r = urllib.request.Request(link)

r.add_header('User-Agent','Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/59.0.3071.115 Safari/537.36')

html = urllib.request.urlopen(r,timeout=500).read()

html = bytes.decode(html,encoding="gbk")
                     #返回大量json,需提取

#找出返回json中对应正则匹配的字符串

js = re.findall('"n":"(.*?)"',html)

i=0

#循环打印比赛信息

try:

    while(1):
        #将字符串Unicode转化为中文,并输出

        print  (js[i].encode('utf-8').decode('unicode_escape'),js[i+1].encode('utf-8').decode('unicode_escape'),"VS",js[i+2].encode('utf-8').decode('unicode_escape'))

        i=i+3
        #当所有赛程爬取结束时,会报错“IndexError:list index out of range”,所以进行异常处理

except IndexError:

    print ("finished")
总结注意点:
1、python 3 采用这个import urllib.request
因为urllib和urllib2合体了。
2、字符串Unicode转为中文需注意python3与python2的表示方法不同:
python3:print 字符串.encode('utf-8').decode('unicode_escape')
python2:print 字符串.decode('unicode_escape')
3、re.findall()
关于这个函数,他的输出内容规律可以参考我之前写的:http://www.cnblogs.com/4wheel/p/8497121.html
【"n":"(.*?)"】 这个表达式只输出(.*?)这部分(为什么,还是参考我之前写的那篇文章),加上问号就是非贪婪模式,不加就是贪婪模式,顺便实践解释下贪婪模式
example:
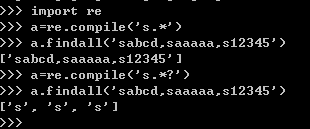
总结:非贪婪模式就是在满足正则表达式的情况下,尽可能少的匹配。
相反,贪婪模式就是在满足正则表达式的情况下,尽可能多的匹配。
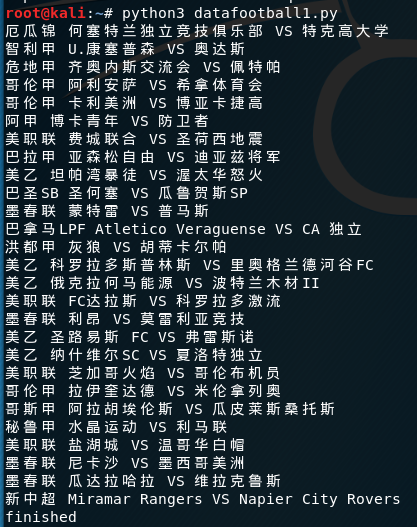
so,爬取结果为:
python爬虫笔记之爬取足球比赛赛程的更多相关文章
- Python爬虫教程-17-ajax爬取实例(豆瓣电影)
Python爬虫教程-17-ajax爬取实例(豆瓣电影) ajax: 简单的说,就是一段js代码,通过这段代码,可以让页面发送异步的请求,或者向服务器发送一个东西,即和服务器进行交互 对于ajax: ...
- 【转载】教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神
原文:教你分分钟学会用python爬虫框架Scrapy爬取心目中的女神 本博文将带领你从入门到精通爬虫框架Scrapy,最终具备爬取任何网页的数据的能力.本文以校花网为例进行爬取,校花网:http:/ ...
- Python爬虫实例:爬取B站《工作细胞》短评——异步加载信息的爬取
很多网页的信息都是通过异步加载的,本文就举例讨论下此类网页的抓取. <工作细胞>最近比较火,bilibili 上目前的短评已经有17000多条. 先看分析下页面 右边 li 标签中的就是短 ...
- Python爬虫实例:爬取猫眼电影——破解字体反爬
字体反爬 字体反爬也就是自定义字体反爬,通过调用自定义的字体文件来渲染网页中的文字,而网页中的文字不再是文字,而是相应的字体编码,通过复制或者简单的采集是无法采集到编码后的文字内容的. 现在貌似不少网 ...
- Python爬虫实例:爬取豆瓣Top250
入门第一个爬虫一般都是爬这个,实在是太简单.用了 requests 和 bs4 库. 1.检查网页元素,提取所需要的信息并保存.这个用 bs4 就可以,前面的文章中已经有详细的用法阐述. 2.找到下一 ...
- python爬虫-基础入门-爬取整个网站《3》
python爬虫-基础入门-爬取整个网站<3> 描述: 前两章粗略的讲述了python2.python3爬取整个网站,这章节简单的记录一下python2.python3的区别 python ...
- python爬虫-基础入门-爬取整个网站《2》
python爬虫-基础入门-爬取整个网站<2> 描述: 开场白已在<python爬虫-基础入门-爬取整个网站<1>>中描述过了,这里不在描述,只附上 python3 ...
- python爬虫-基础入门-爬取整个网站《1》
python爬虫-基础入门-爬取整个网站<1> 描述: 使用环境:python2.7.15 ,开发工具:pycharm,现爬取一个网站页面(http://www.baidu.com)所有数 ...
- Python 爬虫入门之爬取妹子图
Python 爬虫入门之爬取妹子图 来源:李英杰 链接: https://segmentfault.com/a/1190000015798452 听说你写代码没动力?本文就给你动力,爬取妹子图.如果 ...
随机推荐
- 从Qt5开始只剩下setCodecForLocale这一个了,只是影响Qt对toLocal8Bit相关函数的编码方式(在源码里写非英文,官方推荐“\xE4\xBD...”这种)good
QTextCodec::setCodecForCStrings(QTextCodec::codecForName("UTF-8")); QTextCodec::setCodecFo ...
- 完全卸载mysql免安装版
使用以下命令 reg delete "HKEY_LOCAL_MACHINE\SYSTEM\ControlSet001\services\eventlog\Application\MySQL& ...
- Java对象结构及HotSpot对象模型
一.对象结构 在HotSpot虚拟机中,对象在内存中存储的布局可以分为3块区域:对象头(Header).实例数据(Instance Data)和对齐填充(Padding).下图是普通对象实例与数组对象 ...
- php生成html静态文件
现在的动态网站存在很多性能上的弊端,seo优化会存在一定的瓶颈,现在将动态的网站代码转换为html静态文件,是浏览器通过html间接的读取动态网站源文件,这对其网站加载速度还是seo优化有着举足轻重的 ...
- Kafka笔记7
Kafka提供了一些命令行工具,用于管理集群变更.这些工具使用Java实现,Kafka提供了一些脚本调用这些Java类. 9.1主题操作 使用Kafka-topics.sh工具可以执行主题大部分工作, ...
- C++模板的理解与使用
最近发现原来学的东西根本都不理解,所以本人正在恶补C++,把自己对C++中概念的最简单粗暴的理解写下来. 有问题的地方还请指出~随时更正 模板:顾名思义,就是为了方便以后使用而出现的东西,生活中的模板 ...
- never下ioc
生命周期 当前分单例,作用域(范围),短暂.单例是整个服务中只有一个实例,短暂则是每一次得到的都是新的实例,作用域就是在该一套行动中内得到的是同一个实例,该行动中指的是什么?我们看看demo下的sta ...
- 实现h5公众号分享功能(vue项目也适用)
在vue项目中我们先npm install weixin-js-sdk --save下载下来在main.js文件中引入 import wx from 'weixin-js-sdk';//引入 Vue. ...
- 关于vue项目中在js中引入图片问题
<template> <div> <img v-for="(star,index) in stars" :src="star.src&quo ...
- PATA 1065 A+B and C (64bit)
1065. A+B and C (64bit) (20) 时间限制 100 ms 内存限制 65536 kB 代码长度限制 16000 B 判题程序 Standard 作者 HOU, Qiming G ...